
开源仓库
共 8 个仓库 · 按最近更新排序
 vuejs/core
🖖 Vue.js is a progressive, incrementally-adoptable JavaScript framework for building UI on the web.
 twbs/bootstrap
The most popular HTML, CSS, and JavaScript framework for developing responsive, mobile first projects on the web.
 DIYgod/RSSHub
🧡 Everything is RSSible
 tailwindlabs/tailwindcss
A utility-first CSS framework for rapid UI development.
 Minglink/dsh-infinite-gen-5
DeepSeek v4.1 flash 逆向工具(无限五代) 求 Star 收藏 ⭐欢迎大家提交项目的改进
 xia-sc/dsh-opencode-go
DeepSeek Harness LLM provider plugin for OpenCode Go (zen-go route)
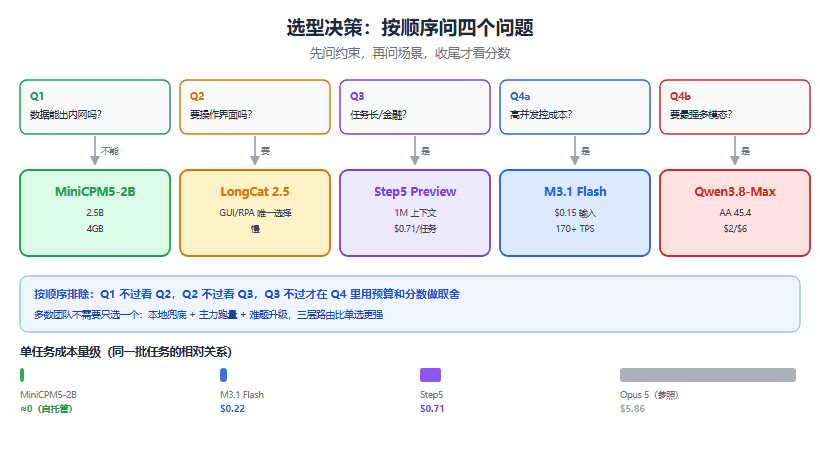
五款模型怎么选:一张决策图看完端侧、跑量、长任务与旗舰
一句话总结:选模型不是比分数,是先回答四个约束问题——能不能私有、要不要长上下文、任务长短、预算多少,答案组合基本就锁定了这五款里的唯一一个。前面分别写了Qwen3.8、M3.1Flash、MiniCPM5-2B、LongCat2.5、Step5,也做了横评和成本账。这篇收个口:怎么把选择做成流程,而不是凭...
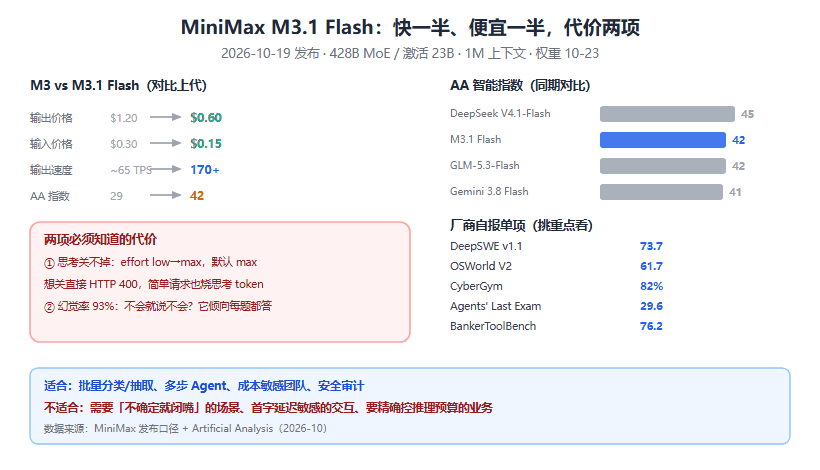
MiniMax M3.1 Flash 深度解读:428B 激活 23B,速度翻三倍、价格砍一半
一句话总结:MiniMax10月19日发布M3.1Flash,428B总参数每次只激活23B,1M上下文、文图视频输入,输出速度200+TPS、价格降到M3的一半,AA智能指数42分,但「思考常开」和93%的幻觉率是两个实打实的代价。10月19日晚发布的M3.1Fla...
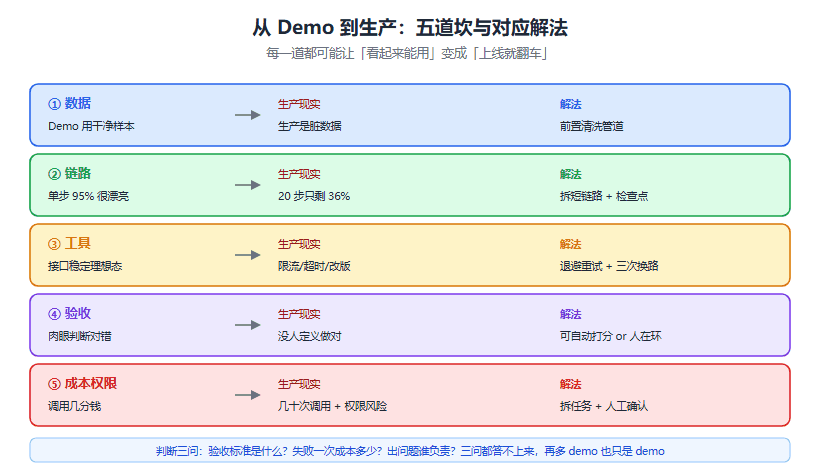
AI Agent 落地真相:Demo 惊艳、生产拉胯的五个原因
一句话总结:Agent的demo和生产之间隔着五道坎——脏数据、长链路误差累积、工具脆弱、验收缺失、成本与权限,任何一个没解决都会让「看起来能用」变成「上线就翻车」。今年看过太多Agent演示:一句话下达任务,模型自己拆步骤、调工具、改错误,一路交到成品。看完就想立刻上生产。真上了才发现另一回事。我自...
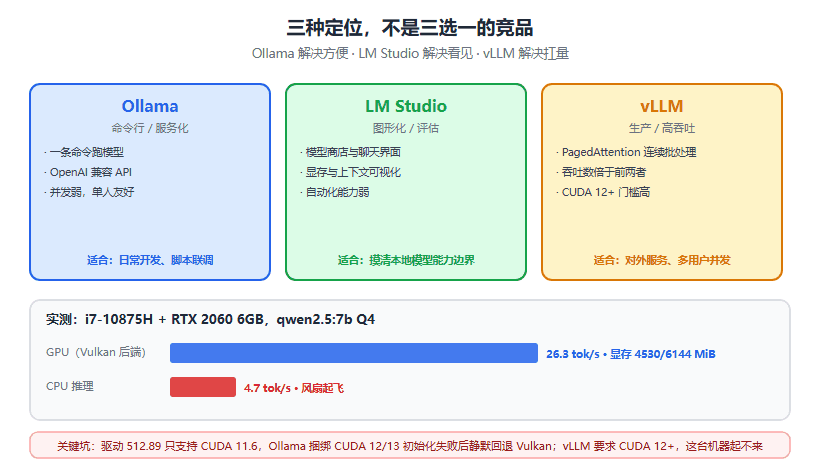
本地跑大模型工具横评:Ollama、LM Studio、vLLM 到底该选谁
一句话总结:三个工具不是竞品关系而是三种定位——Ollama是命令行服务端、LMStudio是图形化体验、vLLM是生产级吞吐引擎,选错的代价是白折腾一晚上;附RTX2060上的实测数据和踩坑记录。本地跑模型这件事,工具选错比模型选错更常见。我见过有人为了「体验一下」装了vLLM,卡在CUDA...
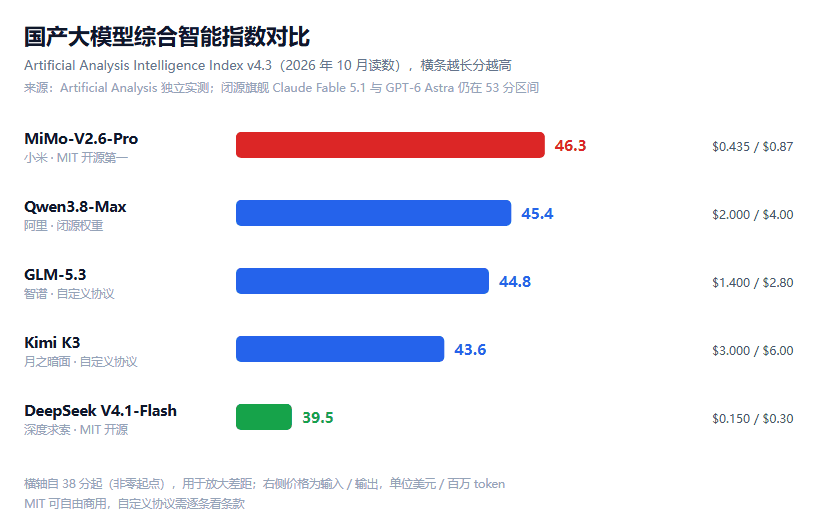
小米 MiMo-V2.6 深度解读:347 万美元训出的开源第一,以及它自己承认没修好的问题
一句话总结:MiMo-V2.6-Pro以46.3分登顶ArtificialAnalysis开源权重榜第一,两次训练合计只花了347万美元,但小米自己在9月27日的复盘里承认,Agent重复调用问题只从13.45%降到3.83%,没解决掉。先把一个事实摆出来:你现在用的这个Wor...
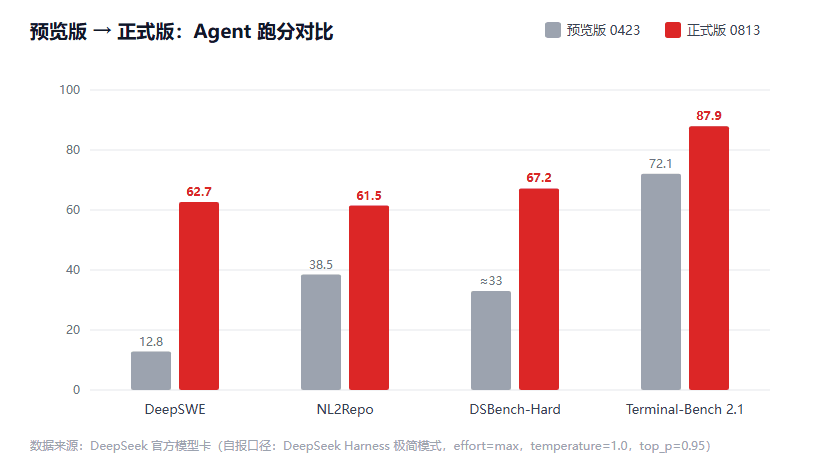
DeepSeek-V4-Pro-0813 全面解析:1.6T 旗舰正式版,Agent 跑分翻倍、峰谷定价后还划算吗
一句话总结:DeepSeek-V4-Pro-0813是4月预览版转正的旗舰,架构没动、后训练重做,DeepSWE从12.8分跳到62.7分,权重照旧MIT开源,但8月那次峰谷调价让实际成本涨到了原来的2.3到4.5倍。2026年8月13日,DeepSeek把挂了将近四个...
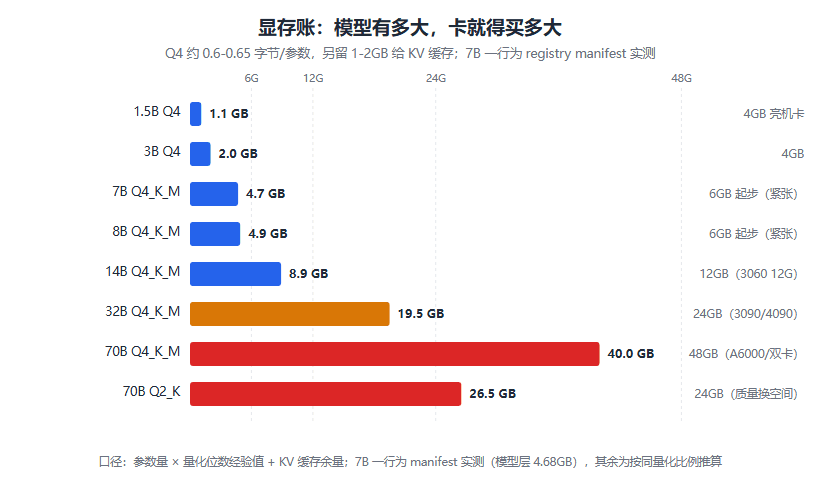
本地跑模型做应用:Ollama 与 vLLM 部署实战,6GB 显卡能干什么、什么时候必须换引擎
一句话总结:本地跑模型的门槛不在技术,在一笔账:7B模型Q4量化后要4.7GB显存,RTX2060这类6GB卡刚好卡在门口;我用这台机器实测了Ollama从安装到出字的全流程,也把「什么时候该换vLLM」的账算清楚了。前八篇都在调API,模型在别人机房。这篇把模型搬回自己机器。理由通常有...
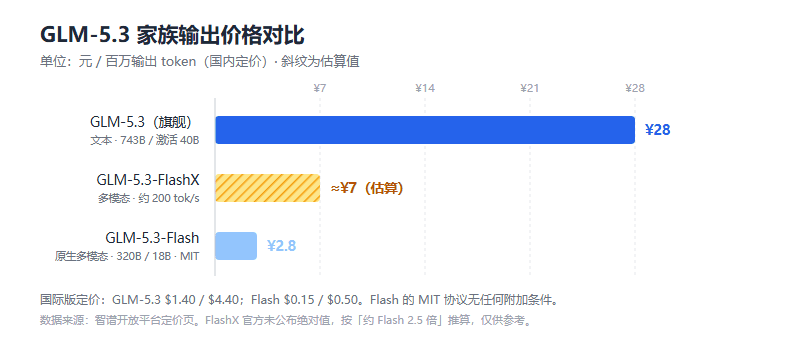
智谱 GLM-5.3 模型全面解析:7430 亿参数不换基座,靠后训练把编程能力提升 50%,值得用吗?
一句话总结:GLM-5.3是智谱(Z.ai)2026年8月发布的开源旗舰模型,与GLM-5.2共用同一个基座,全部能力提升来自后训练,编程能力较上代提升约50%,在Terminal-Bench3.0、Agents'LastExam等基准上位列开源第一,并涌现出接近闭源前沿的网络安全能...