
一句话总结:MiMo-V2.6-Pro 以 46.3 分登顶 Artificial Analysis 开源权重榜第一,两次训练合计只花了 347 万美元,但小米自己在 9 月 27 日的复盘里承认,Agent 重复调用问题只从 13.45% 降到 3.83%,没解决掉。
先把一个事实摆出来:你现在用的这个 WorkBuddy,跑的就是 MiMo-V2.6-Flash。所以这篇稿子里涉及 Flash 的部分,有一部分是我自己在跑。
9 月 21 日小米把 MiMo-V2.6 系列的权重放上了 Hugging Face,协议是 MIT。第二天正式发布,技术报告、训练框架、七千多个 RL 任务环境一起开源。Hugging Face 的 CEO Clément Delangue 在 X 上的评价是一个词:Banger。
我一开始对这件事是有点怀疑的。手机厂做基础大模型,听着像财报需要的叙事。但把技术报告翻完,再把第三方评测和社区反馈对了一遍之后,我改主意了——这个模型最值得写的,不是 46.3 分这个数字,而是它把训练成本摊开给你看,包括那些难看的部分。
先把跑分这件事说清楚,别被一张表骗了
这是写这篇稿子最费劲的地方。同一个模型,不同来源给出的分数能差 14 分,因为它们根本不是一套体系。
| 榜单 | 模型 | 分数 | 说明 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3.2 | MiMo-V2.6-Pro | 46.3 | 开源权重模型第一 |
| Artificial Analysis(同上) | Qwen3.8-Max | 45.4 | 闭源权重 |
| Artificial Analysis(同上) | GLM-5.3 | 44.8 | 自定义协议 |
| Artificial Analysis(同上) | Kimi K3 | 43.6 | 自定义协议 |
| Artificial Analysis(同上) | DeepSeek V4.1-Flash | 39.5 | MIT 开源 |
| BenchLeader Index | MiMo-V2.6-Flash | 60.1 | 761 个配置中排 #105 |
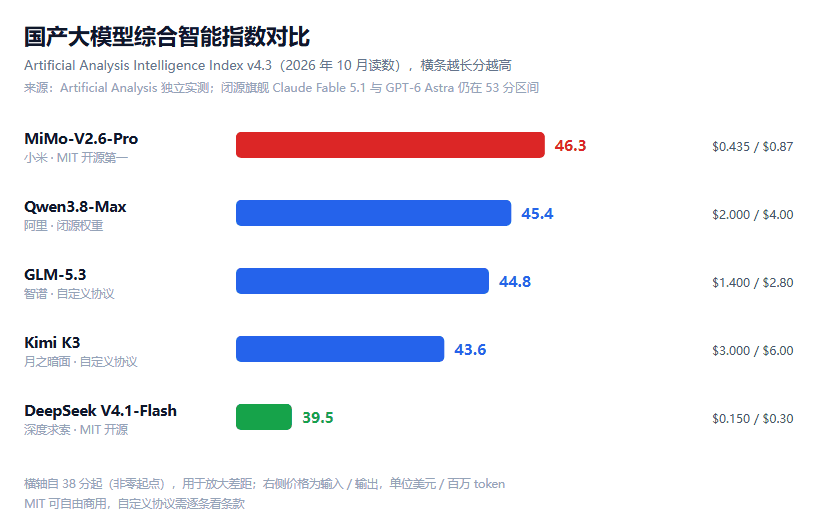
图 1:Artificial Analysis 的国产模型对比,横轴自 38 分起,用于放大差距。注意右侧价格差异,Pro 的输入价只有 Qwen 的四分之一
上表里两个 60 和 46 不能放在一起比。BenchLeader 用的是自己的一套标准化方法,把 761 个模型配置按中位数 50 归一化;AA 是另一套测试集和另一套打分。BenchLeader 测的是 Flash,AA 那张表测的是 Pro。混在一起看,就会得出「第三方跑分比官方高 14 分」的错误结论。
那 46.3 分和 53 分的差距怎么说?我核过来源,53 分区间对应的是 Claude Fable 5.1、GPT-6 Astra、Grok 4.7 这几个闭源模型。同榜开源组里还有个熟面孔,DeepSeek V4.1-Flash,39.5 分,输入价只有 MiMo 的三分之一,差距在哪我们之前拆解过。但老实讲,我不想把这个「差距 7 分」写成标题——闭源旗舰的迭代节奏很快,今天写的差距,下个月可能就不成立了。你要记住的是这个结论:MiMo-V2.6-Pro 是目前独立榜单上排名最高的开源权重模型,这是硬的。至于离闭源第一梯队有多远,等你自己去试。
一个版本跳了 20 分
上一代 MiMo-V2.5-Pro 在同一张 AA 榜上是 26 分。V2.6 是 46.3 分。一代之内抬了 20 分。
这两年榜单上的分数基本是一分一分往下啃的,20 分这个跨度在开源模型里没见过。小米把这次发布定义为探索 RSI(递归自我改进)路径的关键一步。
但我得拆穿一个流传很广的说法。很多文章写「DeepSWE v1.1 从 19.0 提升到 71.9,强化学习贡献了 52.9 分」。这个算法是错的。
真实链条是三段:
- V2.5 Pro 的分数是 19.0
- V2.6 完成 SFT、开始 RL 之前的基线是 58.4
- 跑完 30 步 RL 之后是 72.57(model card 自报 71.9)
也就是说,SFT 阶段就吃掉了 39 分,RL 再贡献 14 分。RL 很强,但没强到能一口气扛下 50 分。
这里还有一个我必须提的坑:Epoch AI 独立审查 DeepSWE v1.1 这个基准后评了 flawed,人工确认 113 道题里至少 23 道存在误判。所以 72.57 这个数字,不该当成一把没有误差的尺子。
347 万美元,花在哪了
这是我最想讲的部分。小米把训练账本摊开了:Flash 约 85 万美元,Pro 约 262 万美元,合计约 347 万。30 步 RL,约 75 万条轨迹,不到 6 天跑完。
技术报告《MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement》里,总额只是一行数字,真正有信息量的是成本结构:
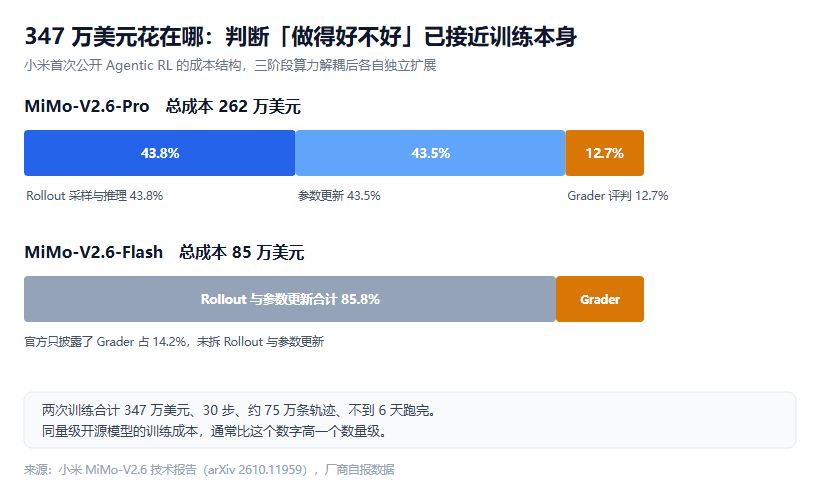
图 2:Pro 的成本里,用来判断「Agent 这个活干得好不好」的 Grader 占了 12.7%,和参数更新的 43.5% 已经不是一个数量级的差距了
Pro 的 262 万里,Rollout 采样与推理占 43.8%,参数更新占 43.5%,Grader 占 12.7%。Flash 的 Grader 占比更高,14.2%。
这个 13% 上下意味着一件事:在 Agentic RL 时代,「评判模型做得好不好」的开销已经不是零头了,它开始跟训练本身一个量级。
为什么会这样?报告里举了个例子我觉得特别说明问题。同一个任务有两个方案:一个只改必要的三行代码,另一个加了一堆兼容分支、把异常吞掉、还把 API 范围扩大了。传统「测试通过与否」的二元奖励下,这两个方案得分一样。但工程质量天差地别。
所以他们做了两套机制:GRS(分组奖励合成)和 GAR(组内优势重分配),对已经通过测试的方案继续按实现质量、边界处理、修改范围打分排序。加了这套之后,模型开始倾向于写更小、更精确的 patch,也更愿意用更少的 Token 完成任务。
训练任务的构成也值得看一眼:覆盖 Code、General、Visual、Cyber 四个方向,其中代码与竞赛编程占了 RL Batch 的 68%。这解释了它为什么在编码类基准上跳得最猛,也解释了后面要说的那些短板。
官方自己承认的那个问题
这是我查资料时挖到的,通稿里基本没有。
9 月下旬,B 站上有个十万播放的视频吐槽 MiMo-V2.6-Pro「空跑消耗 6.3 亿 token、烧掉近三分之一订阅量而无产出」。这听起来像情绪输出,但小米 MiMo 团队 9 月 27 日真的公开复盘了。
复盘内容是:模型在 MiMo Desktop、MiMo Code 这类 Agent 环境里,会反复发出相同或高度相似的工具调用。
补救措施是重训约 20 步,按完整规模估算又花了约 231 万美元。结果呢?重复率从 13.45% 降到 3.83%。
没有消除。
我认为这是整个 MiMo-V2.6 故事里最值得记住的一个数字。训练报告里官方说 reward hacking 轨迹压在 2% 以下,那是实验室环境;放到真实的 Agent 产品环境里,重复调用率是 13.45%。花了 231 万美元补窟窿,补到 3.83%,还剩 3.83%。
这意味着什么?把一个耗时数小时的任务直接甩给它不管,目前是在买彩票,不是在交付。
Pro 和 Flash 怎么选
两者的架构是一样的:稀疏 MoE,384 个专家每次激活 8 个,路由是冻结的;滑动窗口注意力加全局注意力混合,比例 7:1;都是 1M 上下文,都是原生全模态(文、图、视频、音频进同一个上下文)。
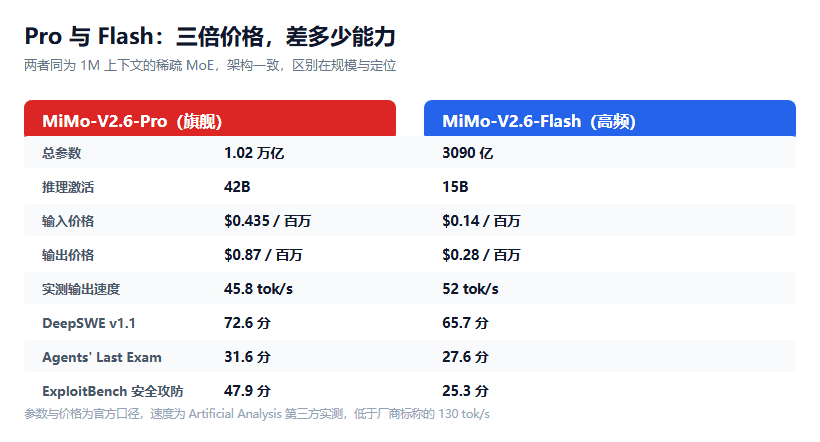
图 3:价格差三倍,但 ExploitBench 安全攻防上差了将近一倍,Flash 这一项只有 Pro 的一半多一点
价格上,Pro 是 $0.435 输入 / $0.87 输出每百万 token,Flash 是 $0.14 / $0.28。国内 API 是人民币计价,Pro 3 元 / 6 元,Flash 1 元 / 2 元,缓存折扣最高 99%。
实测速度上,Artificial Analysis 测出来 Pro 是 45.8 tok/s,Flash 是 52 tok/s。厂商标称 Pro 能到 130 tok/s,这个差距后面再说。
Reddit 上有个数据我觉得很能说明 Flash 的价值。r/LocalLLaMA 的用户 u/pipeline_hacker 跑了 5 万次文件提取和表单填写任务,Flash 完成了 98% 和 Pro 完全一致的结果,周 API 账单从 480 美元直接降到 155 美元。确定性的批量任务,Flash 就是性价比之王。
但 Flash 有个很具体的软肋,用之前必须知道:长程异常恢复悬崖。它在 Agents' Last Exam 上只有 27.6 分(Pro 是 31.6)。当自动化任务撞上突发状况——弹出的验证码、改名的按钮选择器、过期的权限——它不会退一步重新规划,而是会重复失败的点击或请求,直到耗尽最大步数。
15B 激活参数给不了它推断第二套方案的容量。所以生产环境里,绝对不要让 Flash 在没有外部监督的情况下独立跑长程任务。
真实使用中的四个坑
这些都不是榜单上的事,是社区反馈里反复出现的。
第一,长提示词反而更差。B 站有 UP 主做了整日前端能力全量测试,结论反直觉:这个模型在长提示词下容易陷入深思,做出超出自己能力范围的东西,质量反而崩。karminski-牙医 的横评结论同样指向这个方向——适合后端智能体编程,前端空间理解和美学还需加强。它更适合短提示词配多轮修改。
第二,思考 token 计费陷阱。Flash 的内部思考 token 按输出费率计费,也就是 $0.28 百万。不设 max_thinking_tokens 的话,它可能在回答一个简单布尔值之前先生成 3000 到 5000 个思考 token。简单分类任务的成本就这么被拉高了好几倍。
第三,1M 上下文是容量,不是 1M 的推理质量。报告里 config 确实把 max_position_embeddings 设成 1,048,576,但披露的典型 RL 轨迹只有 110K–150K。没有在接近 1M 位置的检索命中率、位置偏差、任务成功率数据。把整个仓库、工具 trace 和多个 session 塞进去之前,先自己测一下。
第四,速度体感不稳定。有投诉说「让 Flash 改一个 HTML,一小时半还在思考,竞品三分钟搞定」。评测者认为这里既有模型原因,也有基础设施原因,高峰时段吞吐还没兜住。另外有工程反馈说中高推理档 token 消耗过大容易超时。
落地这件事:为什么是小米做
MiMo 不是一个孤立的模型产品。澎湃 OS 4 深度集成 MiMo 和超级小爱 2.0,端侧模型已经落到小米 18Fold 这类终端上。端云双架构:手机车机本地离线跑,复杂任务再调云端。
手机端的功能我挑两个说。灵感球是拖个小球指向屏幕任意内容然后语音下指令,识别图片文字、提取地址、建日程;任务上岛是把耗时长的 AI 任务丢后台,比如批量筛相册生成旅行图集,任务完成卡片自动弹出,不打断你正在刷的视频。
人车家联动的场景是:一句「下班回家,提前打开家里空调,导航回家,路上把今天待办清单整理成简短笔记」,AI 串联手机、车机、米家设备跨设备执行。
但我得提醒一个硬件门槛:高级 Agent 功能目前只在小米 17 系列部分机型封测,老款手机只有基础端侧能力,复杂智能体功能硬件不支持。这个很多人不知道就下单了。
隐私这块官方规则是清楚的:图片文字处理优先端侧本地运算,用户确认后才上传云端,屏幕记忆功能需要手动授权。短板也坦白说了——几十万字超长深度分析、复杂商业策划还是得联网走云端,离线只适配日常短文本。
小米在这个赛道的投入量级可以做个参考:2025 年研发投入超 330 亿,同比增长 37.8%;2026 年预计超 400 亿,其中 AI 及具身智能超 160 亿;未来三年 AI 累计投入超 600 亿。
自建门槛不低
想本地部署的话先掂量一下硬件。官方 SGLang 配方里 Pro 要两节点 16 卡,Flash 单节点 8 卡或 4 卡可行。vLLM 用户建议直接用官方镜像并开 trust_remote_code。独立量化版还没跟进,GGUF 党得再等等。
不想自建的话 OpenRouter 已经上架了 Pro 和 Flash 两个模型。另外有个 API 专供的 Pro-UltraSpeed,官方称推理速度最高快 20 倍,但没有开源权重。
自建还有个反直觉的坑:MIT 协议不等于你能完整复现训练。预训练数据披露停留在来源类别,没有逐项 provenance 和完整的过滤去污染审计。可以下载权重,但外部团队没法重做训练。
我的判断
适合用的场景:高频批量任务(文件提取、表单填写这类确定性活)、后端智能体编程、成本敏感的团队、需要数据不出服务器的私有化部署。Flash 在这些场景下的性价比目前很难打。有 Reddit 用户 5 万次任务跑出 98% 一致性和 68% 的账单削减,这个数据比我任何描述都有说服力。
不适合的场景:无人值守的长程自动化任务(会死循环烧钱)、前端视觉与美学工作(空间理解不够)、强安全攻防需求(ExploitBench Flash 只有 25.3,Pro 47.9,而 GPT-5.6 Sol 是 78.5)。
一句话收尾:它把「第一梯队开源模型」的训练门槛压到了几百万美元量级,而且整套 RL 训练环境和代码都开源了。46.3 分是开源权重榜的天花板没错,但它自己承认的那 3.83% 重复调用率,才是这个模型当前最真实的边界。
常见问题
Q1:MiMo-V2.6 和上一代差多少?
AA 综合指数从 26 分升到 46.3 分,一代跳了 20 分。分项上看,DeepSWE v1.1 从 19.0 升到 71.9,AutomationBench 从 16.0 升到 53.1,Terminal Bench 2.1 从 65.2 升到 89.9,CyberGym 从 40.0 升到 94.0。注意 DeepSWE 那 52.9 分里,SFT 阶段占 39 分,RL 占 14 分。
Q2:为什么官方说 130 tok/s,第三方只测出 45.8?
厂商标称通常是理想条件下峰值吞吐,Artificial Analysis 是在统一环境下实测。社区反馈里高峰时段体感更差。用第三方实测值做规划更保险。
Q3:Pro 和 Flash 怎么选?
确定性批量任务选 Flash,性价比高到离谱。需要复杂规划、长程推理、安全攻防选 Pro。绝对不要让 Flash 独立跑无监督长程任务,它遇到异常会重复失败操作直到耗尽步数。
Q4:1M 上下文能不能直接塞整个代码库?
能塞,但别指望塞进去就能用。报告里典型 RL 轨迹只有 110K 到 150K,没有接近 1M 位置的检索质量验证。先自己测引用命中率和任务成功率。
Q5:开源的到底有哪些东西?
权重(MIT 协议,可商用可改可再发布)、技术报告、7000 多个 RL 任务环境、端到端训练框架、可组合 Agent Harness、uni-agent 与 verl 与 mimoagent 的 mimo-oss 分支、RL 数据集、Distill-Qwen-9B 蒸馏小模型。注意预训练数据没有逐项来源披露,外部无法完整复现训练。
Q6:本地部署要什么硬件?
Pro 要两节点 16 卡,Flash 单节点 8 卡或 4 卡。独立量化版和 gguf 还没跟进。个人用户直接走 OpenRouter 或官方 API 更现实。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。