
一句话总结:DeepSeek-V4.1-Flash-1017 是 2026 年 10 月 17 日发布的 V4.1 Flash 快照,是 DeepSeek 第一款用 Causal Encoder-Decoder 架构的模型,552B 稀疏 MoE 只激活 8B/16B 参数,主打长上下文和 Agent 场景,输入 0.15、输出 0.60 美元每百万 Token。
2026 年 10 月 17 日,DeepSeek 放出了 V4.1 Flash 的一个日期快照:DeepSeek-V4.1-Flash-1017。名字里的 1017 就是 10 月 17 日,DeepSeek 现在习惯用这种带日期的快照名,方便开发者锁定版本。这篇把它和前几代的关系、架构、价格和真实定位讲清楚,凡是没被独立验证的官方说法,我都会标出来。
它到底是什么
V4.1 Flash 是 DeepSeek V4.1 家族里走性价比路线的那一档。1017 这个快照挂在 deepseek-flash 这个 API 模型名下面,由 DeepSeek 自家托管,同时上了 OpenRouter(模型 ID 是 deepseek/deepseek-v4.1-flash-1017)。DeepSeek 官方说这一档在性能、速度和任务完成时间上都超过了自家的 V4 Pro,但这个对比没有附任何 benchmark 数字,我在下文单独说这件事。
架构:DeepSeek 第一次用 CED
这一代最值得写的是架构。V4.1 Flash 是 DeepSeek 第一个基于 Causal Encoder-Decoder(CED)架构的模型。它本质上是个 552B 参数的稀疏混合专家(MoE)模型,但激活参数做了非对称拆分:输入时只激活 8B,输出时激活 16B。这个不对称是有意为之,目的是把每个 token 的计算量压低,相对于模型总规模来说更省。
非对称激活带来的直接好处是:模型很重(552B 总参数),但每次推理很轻(8B/16B 在干活)。这对那种要跑很多步、读很多上下文的 agent 工作负载特别合适,因为成本是按处理的 token 算的,激活参数少就意味着单步便宜。
关键参数
| 项目 | 数值 |
|---|---|
| 发布日期 | 2026-10-17(快照) |
| 架构 | CED,稀疏 MoE,DeepSeek 首款 |
| 总参数 | 552B |
| 激活参数 | 输入 8B / 输出 16B(非对称) |
| 上下文窗口 | 1,048,576 token(补全最多 393,216) |
| 输入模态 | 文本 + 图像(原生视觉) |
| 输出模态 | 文本 |
| 定价(DeepSeek 端点) | 输入 $0.15 / 输出 $0.60 / 缓存读 $0.003 每百万 token |
| API 模型名 | deepseek-flash |
| 工具调用 | 支持 tools / tool_choice |
| JSON 输出 | 支持 response_format,但不强制 schema |
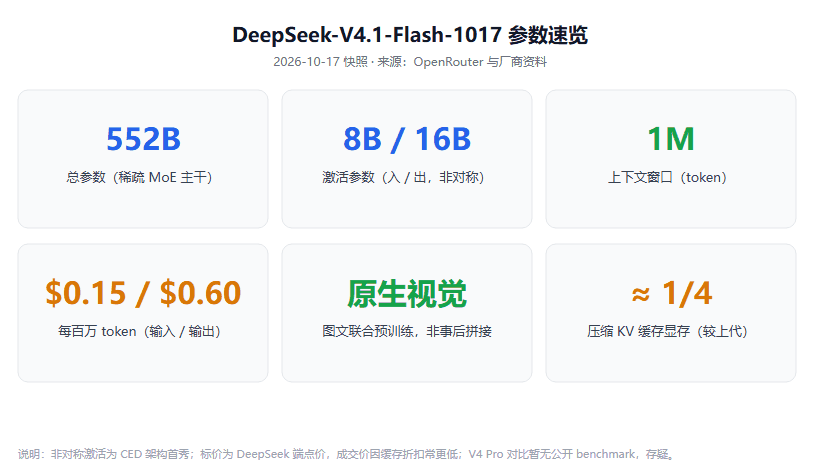
图 1:6 张参数卡片,核心卖点是激活参数与总参数的解耦。
两个真正有用的能力
原生视觉。 图像和文本的 embedding 是从预训练一开始就是联合训练的,不是像上一代实验性的 V4 Flash Vision Exp(284B 总、13B 激活)那样事后把视觉模块接上去。这意味着它适合文档和图表分析、视觉问答,以及那种文本和图像交替出现的多模态 agent 流程。
压缩 KV 缓存。 DeepSeek 说压缩后的 KV 缓存把显存占用到上一代 Flash 的大约四分之一。这件事对 agent 场景的意义可能比标价还大:长任务大部分预算都花在反复读取已经累积的上下文上,缓存体积砍到四分之一,长链路服务的成本就能明显降下来。缓存读价格定在 $0.003 每百万 token,也指向同一个方向。
和前两代对比
| 维度 | V4 Flash 0731 | V4.1 Flash 1017 | V4 Pro 0423 |
|---|---|---|---|
| 发布 | 2025-07-31 | 2026-10-17 | 2026-04-23 |
| 总参数 | 284B | 552B | 1600B |
| 激活(入/出) | 13B | 8B / 16B | 49B |
| 上下文 | 上一代 Flash | 1M token | 未披露 |
| 定位 | 上一代 Flash | 性价比档 | 旗舰 |
V4.1 Flash 1017 的总参数几乎是 V4 Flash 0731(284B)的两倍,但激活参数从 13B 变成了 8B/16B 的非对称。换句话说,DeepSeek 在存储容量上多花了钱,在每 token 计算上少花了钱,这种取舍明显是冲着高吞吐 agent 循环去的。V4 Pro 0423 有 1.6T 总参数、49B 激活,是上一代旗舰,所以 DeepSeek 说 V4.1 Flash「超过 V4 Pro」这个说法,指的是用远少得多的激活参数做到了更好,听着合理,但缺数字,我建议先存疑。
能力定位与适用场景
DeepSeek 给它的目标场景写得很明确:代码、终端和电脑操作类 agent;必须跨很多步跑完的长链路任务;长上下文分析。它适合这几类人:
- 跑 agent 流水线、成本随 token 量放大的团队,单价低加上压缩缓存,账单能压住
- 需要原生多模态、又不想另接视觉模型的文档/图表分析
- 长上下文、多步推理的批量任务
不太适合的场景也得说清楚:它只输出文本,不能出图出音频;官方「超过 V4 Pro」的声明没有 benchmark 支撑,真要迁移到关键任务,得在自己工作负载上先跑一遍;另外它在 OpenRouter 上暂时没有欧盟区域内路由,有合规要求的团队要注意。
怎么用
接 DeepSeek 官方端点用 deepseek-flash 这个模型名就行;走 OpenRouter 用 deepseek/deepseek-v4.1-flash-1017。这里有个坑要提醒:DeepSeek 还提供「Flash Latest」这种别名,会自动指向最新的 Flash 模型。想要稳定复现,一定要 pin 带日期的快照 1017,不然哪天它静默切到新版本,你的评测基线就漂移了。工具调用和 JSON 输出都支持,但 JSON 模式不强制 schema,该自己做校验的地方别省。
关于性能数字,诚实标注来源
下面这些延迟和吞吐不是官方 benchmark,是 OpenRouter 聚合的多日实测(P50):吞吐约 145 到 155 token/秒,首 token 延迟约 1.15 到 1.29 秒,近三天可用性接近 100%。这类数字会随负载和路由变化,参考价值大于精确值。DeepSeek 官方那句「超过 V4 Pro」至今没有公开 benchmark,本文不把它当结论引用。
FAQ
V4.1 Flash 1017 和 V4.1 Flash 有什么区别?
1017 是 2026 年 10 月 17 日的快照。DeepSeek 还提供不带日期的「Flash Latest」别名会跟到最新版。要稳定就锁 1017。
它和 V4 Pro 比谁更强?
官方说 V4.1 Flash 在性能、速度、完成时间上超过 V4 Pro,但没给数字。从参数看它激活参数远少于 V4 Pro(8B/16B vs 49B),性价比和速度大概率占优,绝对上限还不好说。我不建议在没有自己实测前把关键任务全迁过去。
缓存读 $0.003 是真的便宜吗?
相对 $0.15 的输入价,缓存命中的 token 只要约五十分之一,agent 场景命中率很高时,这部分能显著拉低实际成本。OpenRouter 实测缓存命中率在 88% 到 90% 左右,说明大部分 token 确实走了缓存。
支持本地部署吗?
本文查到的信息里,它只通过 DeepSeek 官方端点和 OpenRouter 提供,没看到权重开放或本地部署的说明。需要完全离线的场景,暂时走不通。
非对称激活(8B 入 / 16B 出)对调用有什么影响?
直觉上输出比输入贵、也更需要算力,DeepSeek 把它激活参数调高,是合理的。对调用方来说没有额外操作,但能解释为什么输出单价($0.60)是输入($0.15)的四倍。
结语
DeepSeek-V4.1-Flash-1017 不是又一个更大的模型,它是 DeepSeek 在架构上的一次转向:用 CED + 非对称激活 + 压缩 KV 缓存,把成本中心从「单次算力」挪到「存储与命中率」。对跑 agent 的团队,这比单纯堆参数更有意义。我的建议是:把它放进你的性价比档测试集,用你自己的长链路任务跑一遍,再决定要不要把 Flash Latest 换成这个带日期的快照。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。