
一句话总结:特朗普与习近平宴请 8 位 AI 高管的同一周,「工业规模蒸馏」的互相指责、英伟达芯片管制、远程算力获取三个火点一个没解,中美 AI 竞争已经从拼模型能力进入拼规则主导权的阶段。
上周最耐人寻味的一张照片,是特朗普和习近平与 8 位 AI 公司高管同桌吃饭。白宫和中方的通报口径都很缓和,还谈成了一条由美财长贝森特牵线的沟通热线。但科技媒体把桌下的账摊开一看,三个火点一个都没解:英伟达先进芯片对华出口管制、中国企业经由海外数据中心远程获取芯片、以及蒸馏争议。
第三条是这场规则战的核心,值得单独展开。
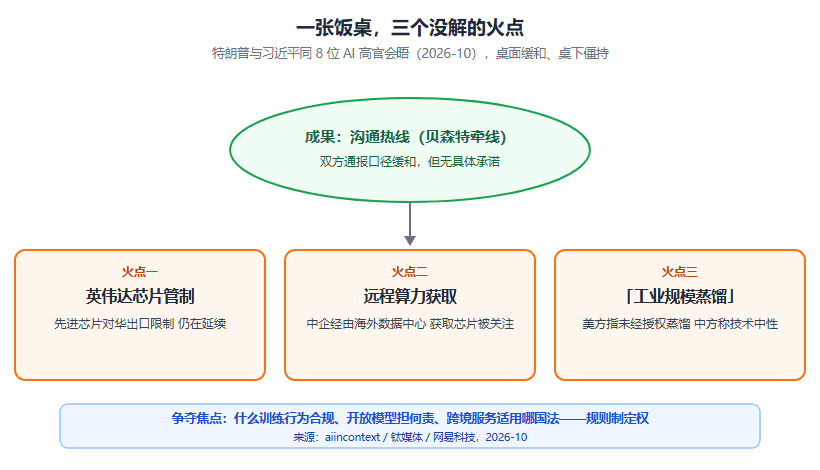
图 1:会晤成果与三个未解火点,争夺的实质是规则制定权
「工业规模蒸馏」吵的是什么
蒸馏本身是机器学习里的常规技术:用能力更强的教师模型生成数据,训练成本更低的学生模型。它没有原罪,DeepSeek 早期的成功、各家的小型号,多少都受益于这条路线。
2026 年的争议不在技术,在授权。美国政府和 Anthropic 先后公开指责部分中国 AI 企业「未经授权的工业规模蒸馏」——即大规模利用竞争对手模型的输出做训练,甚至通过规避访问限制获取数据。中方否认相关指控,强调蒸馏是中性通用技术。就公开信息看,双方都没拿出完整证据链,技术方法本身与是否违反合同、知识产权或访问规则,目前是分开的两件事。
但争论的意义远超个案。钛媒体的判断我认为准确:中美 AI 竞争已经不仅是谁能训练出更强的模型,而是在争夺「什么样的模型训练行为可以被接受、开放模型应该承担何种安全义务、跨境 AI 服务如何适用现有法律」的定义权。谁先把这个框架立起来,对方就得照着玩。
立场由产业链位置决定
跟开源闭源之争一个逻辑,各家在蒸馏和开放问题上的立场,几乎完全由商业模式推出。
芯片公司希望模型越多越好、应用越广越好,算力需求跟着涨。云厂商需要大量不同模型进入企业工作负载。下游软件公司想降低对单一模型供应商的依赖。这三类是开放的天然受益者。而前沿实验室重金训练模型,商业回报依赖模型能力保持稀缺、客户持续为 API 和订阅付费——天然倾向收紧。
有意思的是阵营会漂移。2026 年 7 月,英伟达、微软、Meta、IBM 等多家美国公司公开支持开放权重模型;而部分美国前沿实验室强调能力扩散后的安全风险。「中国开源、美国闭源」这个简化叙事正在失效,硅谷内部在这件事上的分裂比中美之间还大。
规则不确定的代价由谁付
规则没定下来之前,代价已经开始产生。方向至少有四个:闭源模型加强身份验证、访问频率控制和异常调用识别,后训练数据的获取成本提高;各国如果对开放模型设置更严的部署或出口要求,开放路线的扩散速度会放缓;企业客户被迫做多模型冗余,采购成本上升;跨境 AI 服务面临的法律审查加严,出海的合规成本变高。
还有一层更隐蔽的:数据来源、授权关系和合规能力正在取代参数规模,成为新的竞争壁垒。模型能力在快速商品化,但「训练数据干净」这件事没法速成。这对一直强调合规、有数据工程积累的公司是利好,对靠捷径起家的团队是坏消息。
国际层面也在动。超过 30 个国家呼吁对前沿 AI 加强管控,并讨论建立新的国际机构。大西洋理事会的研究员提了个清醒的观点:AI 治理需要的不是全球监督者,而是互联网式分布式的专业网络。30 多国能不能谈出东西另说,但「这事得管」已经是多数共识。
同桌吃饭解决不了的事
回到那张饭桌。热线的价值在于下次芯片争端或 Agent 事故发生时有渠道可打,这不算小成就。但三位知情人士的说法很一致:会晤没有产生具体承诺。芯片管制、远程算力、蒸馏三个问题,每一个都嵌在两国的产业政策里,不是一顿饭能换的。
中方也在用行动说话。CNBC 报道称,中国科技巨头新的芯片进展和 AI 模型发布,正在强化北京的一个判断:华盛顿的筹码有其限度。本土模型能力的上升,本身就在改写谈判筹码的重量。
我的判断
蒸馏争议会长期化,因为它本质上是规则制定权之争,而规则之争没有速胜。对从业者来说,有两个实际影响值得提前准备:一是如果你的业务依赖调用海外模型做训练数据,从现在起把授权链条留好证据,未来合规审查大概率要看;二是国产开源模型在规则不确定期反而是确定性最高的选择——没有跨境法律风险,授权条款自己说了算。
这场规则战最可能结局不是谁赢谁输,而是两边各建一套标准,中间地带的企业两头合规、成本翻倍。所以别只盯着模型跑分,规则才是下一阶段真正的分水岭。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。