
一句话总结:Pika Labs 在 MiniMax H3 上做后训练,推出开源模型 Pika H3 Flex,采样步数从 50 步压到 6 步。按每步 1.2 秒估算,同样 60 秒从出 1 条变成出 8 条。步数能减不是靠截断,是在别人的模型上重新训练过。
Pika 这两天开源了一个模型,Pika H3 Flex。
最有意思的参数不是模型多大,是采样步数:50 步压到 6 步。
这个数字我第一眼没反应过来,算了笔账才发现分量。
一、从 50 步到 6 步,省的是采样时间
扩散类模型的生成过程是迭代的:从噪声开始,一步步去噪,每一步都是一次完整的模型前向。
50 步就是 50 次前向,6 步就是 6 次。耗时基本是线性关系。
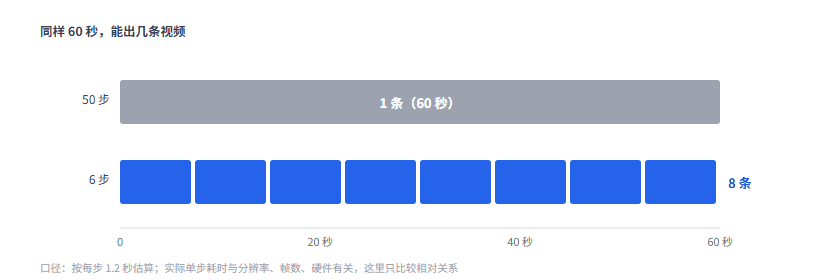
图 1:同一段时间里,步数少的那个能出 8 条
按每步 1.2 秒估算(视频生成的典型量级):
def total_time(steps, per_step=1.2):
    return steps * per_step

print(total_time(50))   # 60.0 秒
print(total_time(6))    # 7.2 秒
加速 8.3 倍。
换个角度看更直观:给 60 秒的预算,50 步能出 1 条,6 步能出 8 条。
对做内容的人来说,这是产能的差别——不是"快一点",是"能不能批量做"的分水岭。
二、扩散模型为什么要走这么多采样步
要理解步数为什么能减,得先知道它为什么要那么多。
扩散模型的训练目标是"学会从噪声里还原图像"。训练时用的是加噪-去噪的配对数据,但推理时没人告诉你"这一步该去多少噪声"。
传统做法是把过程离散成很多小步,每步只去掉一点点噪声。步数越多,每步越小,累积误差越低。
50 步是经验的平衡点:再少,画质开始崩;再多,收益递减。
这个递减很明显:
| 从几步加到几步 | 多花时间 | 相对增幅 |
|---|---|---|
| 1 → 2 | 1.2 秒 | 100% |
| 6 → 7 | 1.2 秒 | 16.7% |
| 12 → 13 | 1.2 秒 | 8.3% |
| 25 → 26 | 1.2 秒 | 4.0% |
从 25 加到 26 只多 4%,但从 6 加到 7 要多 16.7%。 也就是说,步数越少,每一步越"值钱"。
把 50 步砍到 6 步,等于把 44 个"只值 4%"的步骤全砍了。理论上画质会崩,除非——模型本身变了。
三、步数能减,靠的是重新训练
这是关键:6 步不是把 50 步的流程截断,是换了一个模型。
截断会怎样?前 44 步跳过了,只剩 6 步要去掉全部噪声,每步的跨度是原来的 8 倍。模型没见过这种输入分布,输出直接是糊的。
正确的做法是让模型学会"大步走":训练时就用 6 步的采样路径,让它适应每一步的大跨度。
这一步在业内叫蒸馏(distillation)或者轨迹对齐——让"学生模型"学着用更少的步数走完"老师模型"的路径。
三条常见路线:
渐进蒸馏。 每轮把步数减半,50 → 25 → 12 → 6,每轮重训一次。路径稳,但训练轮数多。
一致性模型。 直接学"任意时刻的状态都指向同一个终点",理论上可以一步到位。难训,容易崩。
对抗训练。 加个判别器,让它判断"少步数的结果真不真"。能明显提升少步数下的锐度,但训练不稳定。
Pika 具体用了哪种,公开信息没说。但"质量有所提升"这个说法,只可能来自重新训练——截断不可能提升质量。
四、Pika 这次在别人的模型上做后训练
还有个细节值得说:Pika H3 Flex 是在 MiniMax H3 上做后训练的。
不是从零训一个视频模型,是在别人开源的权重上继续训。
这条路最近很常见。MiniMax 那篇讲的社区压缩也是同一个逻辑——把别人放出来的东西改造成自己能用的形态。
好处很实在:
省算力。 从零训一个视频生成模型,成本是千万美元级。后训练只是零头。
省时间。 几周 vs 几个月。
继承能力。 基座模型的画质、运动连贯性、语义理解,都是白拿的。
代价是受制于人。基座模型的许可、能力上限、后续版本,你控制不了。
五、三种减步数的路子
回到技术侧,把三种方法放在一起对比:
| 方法 | 步数能到多少 | 训练难度 | 画质损失 |
|---|---|---|---|
| 渐进蒸馏 | 4–8 步 | 中,要分多轮 | 小 |
| 一致性模型 | 1–2 步 | 高,容易训崩 | 中 |
| 对抗训练 | 4–8 步 | 高,不稳定 | 小,锐度更好 |
6 步落在"4–8"这个区间,说明走的不是一步到位的极端路线。
这个区间比较务实:一步生成的画质还是差口气,而 4 到 8 步已经能满足大部分用途,成本又降了一个量级。
六、常见问题
6 步会不会掉画质?
官方说质量"有所提升"。这句话要看对比基准——是和 50 步的原模型比,还是和上一代 Pika 比。没有具体数据,存疑。
开源的是权重还是代码?
开放权重。能不能商用、有没有使用限制,要看许可条款。
能跑在什么硬件上?
视频模型对显存要求高,具体门槛要看模型规模和分辨率。官方没给详细配置。
为什么不干脆做到 1 步?
一步生成的画质目前还不够好。少步数有下限,跨过就崩。
这会成为行业标准吗?
少步数采样已经是趋势。50 步是两年前的标准,现在主流在 20 步以下。
七、边界
我没实测这个模型,所有分析基于公开参数和扩散模型的一般原理。
"质量有所提升"这个说法,我没有找到具体的对比数据——和谁比、用什么指标、样本多少,都不清楚。这类没有基准的描述,建议先当成"没有明显下降"来理解。
另外 1.2 秒/步是我的估算值,实际耗时和分辨率、帧数、硬件强相关。真实的加速比要看同硬件同配置的对比。
结语
50 到 6 这件事,本质是把"推理时反复算"换成"训练时一次算清楚"。
这个交换在投机解码那篇里也出现过——用训练一个草稿模型,换推理时少跑几轮主模型。思路一样:算力从推理侧挪到训练侧,摊薄到每次调用上。
对用户来说,结果就是快。对做模型的人来说,是一次成本结构的重新分配。
参考资料
- AI 工具情报站:模型动态 - Pika H3 Flex 发布信息与步数对比
- MiniMax 官方 - H3 基座模型信息
- Pika Labs - 模型与产品说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。