
一句话总结:小米用 Qwen3.5 9B 做基座,拿自家 MiMo 大模型生成的 77.4B token 做监督微调,蒸馏出 MiMo-V2.6 9B。SWE Pro 从 32.0 涨到 44.6,SWE Verified 只从 60.0 涨到 61.1。同一个模型、同一批数据,两个基准的涨幅差 11 倍——这件事比分数本身更值得看。
昨天有读者问我,说他想拿大模型蒸馏一个小模型自己用,问我该准备多少数据。
我说你先别管数据量,先想清楚你要蒸馏的是什么。
他问有区别吗。有,而且区别很大。小米这个 MiMo-V2.6 9B 正好是个现成的例子。
一、MiMo-V2.6 9B 是什么:Qwen3.5 的蒸馏版
先把规格摆清楚。这模型的全名是 MiMo-V2.6-Distill-Qwen-9B,名字里把出身写得明明白白。
| 项目 | 内容 |
|---|---|
| 基座 | Qwen3.5 9B(Qwen 的 hybrid Gated DeltaNet 架构,GGUF 里 arch 标为 qwen35) |
| 训练方式 | 监督微调,数据是 MiMo 家族大模型生成的 77.4B token |
| 其中有 loss 的 | 27.2B token(占 35%) |
| 上下文 | 256K |
| 输入模态 | 文本 + 图像 |
| 许可 | MIT,可商用 |
| 量化后体积 | Q4_K_M 5.84 GB / Q6_K 7.79 GB / Q8_0 9.55 GB |
「有 loss 的 27.2B」这个细节值得停一下。77.4B 是生成总量,但训练时只有 27.2B 参与损失计算,其余 50.2B 大概是作为上下文喂进去的。真正教会模型东西的,是那 27.2B。
数据配比也公开了:
- 代码 23.2B(30.0%)
- 通用 agent 任务 22.0B(28.4%)
- 视觉任务 21.2B(27.4%)
- 网络安全 11.0B(14.2%)
四块几乎是均分的,代码和 agent 加起来占了近六成。这个配比说明它的目标不是「通用助手」,是「能干活的 9B」。
二、四个基准四种提升:蒸馏后差在哪
分数是这样的:
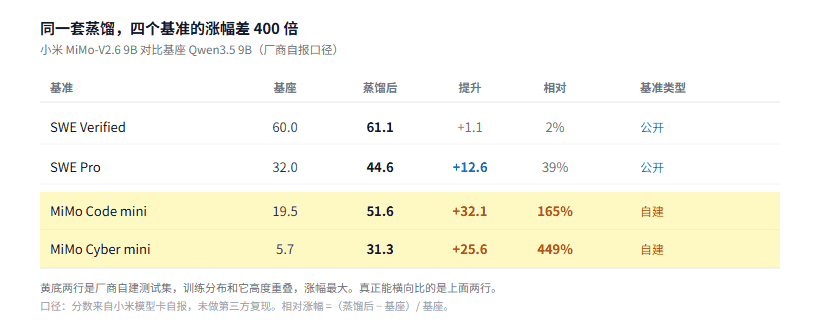
图 1:越难的基准涨得越多,自建测试集的涨幅又明显高于公开基准
| 基准 | 基座 | 蒸馏后 | 提升 | 相对 |
|---|---|---|---|---|
| SWE Verified | 60.0 | 61.1 | +1.1 | 2% |
| SWE Pro | 32.0 | 44.6 | +12.6 | 39% |
| MiMo Code mini(自建) | 19.5 | 51.6 | +32.1 | 165% |
| MiMo Cyber mini(自建) | 5.7 | 31.3 | +25.6 | 449% |
两个公开基准平均涨 6.9 点,两个自建基准平均涨 28.9 点,差 22 点。
三、越难的基准涨得越多:蒸馏学到的是行为
这是我认为最有意思的地方。
SWE Verified 是「修一个已知问题」类的任务,基座 Qwen3.5 9B 已经能拿 60 分,说明它基本会做。蒸馏之后 61.1,涨 1.1 点,在噪声范围内。
SWE Pro 更难,基座只有 32 分。蒸馏后 44.6,涨 12.6 点。
同一个能力,在容易的题上没动,在难的题上大涨。
如果蒸馏只是「把知识灌进去」,那应该两个基准一起涨才对。实际情况不是这样,说明蒸馏灌进去的主要不是知识,是遇到难题时的行为模式。
什么行为模式?我猜是这几样:不轻易放弃、先读代码再改、改完自己跑一遍验证、报错了不瞎猜。这些东西 Qwen3.5 9B 本身可能也会,但不够稳定;大模型在这上面的表现稳定得多,蒸馏把这个稳定性传下来了。
证据是 MiMo Code mini 那行。 基座 19.5 涨到 51.6,相对涨幅 165%。这个基准是小米自建的,训练分布和它高度重叠,所以涨得最多。这既是优点(说明定向能力确实强)也是警告(这个数字不能拿去跟别家比)。
四、77.4B token 的配比说明了什么
回到开头那个问题:要准备多少数据。
这个案例给的答案是 77.4B 生成量、27.2B 有效量,为了把一个 9B 模型在特定方向上拉起来。
但更该看的是配比,不是总量。四块数据(代码 23.2B、agent 22.0B、视觉 21.2B、网络安全 11.0B)都不是「通用对话」,全是「有明确对错的任务」。
这有个直接推论:如果你蒸馏的数据是「对话记录」,得到的是个更会聊天的模型;如果数据是「任务轨迹」,得到的是个更能干活的模型。 小米这四条线全是后者。
还有一点,数据是 MiMo 家族大模型生成的,不是人类标注的。这条路现在很常见,成本比人工低两三个数量级。代价是错误也会被继承——大模型在某类任务上系统性犯错,蒸馏出来的小模型会一模一样地犯。
五、8GB 卡跑得动:量化档位怎么选
这是它最实用的部分。9B 这个规模,量化后 5.84 GB,一张 8GB 卡能跑。
| 量化档位 | 文件大小 | 建议显存 | 适用 |
|---|---|---|---|
| Q4_K_M | 5.84 GB | 6–8 GB | 主流选择,能跑就行 |
| Q6_K | 7.79 GB | 10–12 GB | 质量优先 |
| Q8_0 | 9.55 GB | 12–16 GB | 接近无损 |
Ollama 那边整包下载 6.6 到 8.7 GB,比单个量化文件大,因为带了视觉投影件(mmproj)。要图像输入就得装整包,只要文本可以下单个 GGUF。
几个实操点:
- 量化是用
llama.cppb10964 做的,本地版本更旧的话先升级,否则可能不认这个 arch - 思考模式默认开着,Ollama 里用
/set nothink关,vLLM/SGLang 里传"enable_thinking": false - 关掉思考能省一大截输出 token,代价是复杂任务的准确率
档位怎么选这件事,27B 那篇算过更细的账:Q4 不是万能解,16GB 卡跑 27B 的 Q4 其实差 1.4GB 跑不动。9B 这个规模宽松得多,Q4 就能进 8GB 卡。
六、蒸馏的边界:这 12.6 点能迁移吗
三个边界得说清。
一,自建基准的分数不能横向比。 165% 和 449% 这两个相对涨幅看着惊人,但基准是自家出的,训练数据和测试集的分布重叠度高。这类数字只能证明「定向优化有效」,不能证明「整体能力提升」。
二,公开基准只涨 1.1 点这件事,说明天花板在基座。 SWE Verified 60 分已经接近这个规模的上限,蒸馏再怎么灌也上不去多少。想再往上,得换更大的基座。
三,所有分数都是厂商自报。 我没做第三方复现,文章里也没找到独立的评测。模型卡上的数字通常是最有利的那次运行,读的时候打个折。
这一点和同模型自问自答那篇的结论能对上:那篇测出来「双角色提升 ≈ 老师比学生强多少的一半」,老师等于学生时收益归零。蒸馏是同一个逻辑的极端版——老师强得多,所以收益明显;但收益落在哪个能力上,取决于老师强在哪。
七、结语
这个模型最值得记的不是 44.6 这个分数,是 1.1 和 12.6 的对比。
它说明蒸馏不是「复制能力」,是「复制行为」。能力有天花板(受基座限制),行为没有——一个 9B 模型可以学会大模型「遇到难题不放弃」的习惯,哪怕它自己想不出那么好的解法。
对想自己做蒸馏的人来说,这条比数据量有用:与其堆通用对话,不如攒任务轨迹。
参考资料
- Freaky Jolly - Run Xiaomi MiMo-V2.6 9B Locally - 规格、基准、量化档位与本地运行步骤的主要来源
- DEV Community - Running AI Models Locally in 2026 - 量化档位的质量保留率参考
- Ollama 模型库 - MiMo-V2.6 9B 的下载体积与标签
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。