
一句话总结:把 10 篇技术文档切成 46 到 14 块不等,用 26 个带标准答案的问题逐个扫参数,最后发现切分甜点是 300 字符配 15% 重叠,而纯 BM25 的 MRR 居然压过了混合检索——但先别急着改架构,原因在第三节。
上一篇(几百行代码搭一个自己的知识库问答)留了个尾巴:demo 跑通了,问「MCP 是谁发布的」却把一段讲部署的文档排到了第一。当时我说这个问题留给调优篇,就是这篇。
调优这件事,网上教程的写法是「推荐 512 Token、10% 重叠、混合检索、上重排」,四件套摆齐就收尾。这套说法不能算错,但它跳过了最关键的一步:你的语料、你的问题,跟他的不一样。同一个参数,换批数据结论就能反过来。
所以这篇不搬道理。我搭了个 10 篇文档、5692 字符的小语料,写了 26 个问题,每个问题标注了标准答案所在的文档和关键词,然后把切分、重叠率、检索方式、k 值四个旋钮一个个拧,看数字怎么动。全部代码可复现,结论和翻车现场都写在下文。
先立规矩:没有评测集的调优,跟玄学没区别
拧旋钮之前得先有仪表盘。我用了 26 个问题,分四类:
| 类型 | 数量 | 问法示例 | 考察点 |
|---|---|---|---|
| 直问 | 7 | MCP 是哪一年发布的 | 词面重合,送分题 |
| 同义改写 | 9 | 怎么把外部工具接给大模型用 | 换了说法还能不能找到 |
| 专名细节 | 9 | Inspector 默认端口号是多少 | 版本号、命令、价格这类硬词 |
| 边界情况 | 1 | GLM-5.3 为什么比 5.2 发布得晚 | 答案是一句短句,上下文依赖强 |
判定标准很土但有效:一个问题算命中,当且仅当 top5 结果里出现了标准答案所在的文档,并且那一块里含有关键词(比如「2024 年 11 月」)。只看文档不看片段会虚高——80 页的 PDF 里有正确答案,不代表翻到哪页都算赢,这个坑不少人踩过。
指标选了 Recall@5 和 MRR,没用 NDCG。原因很简单:我没有做分级标注,硬上 NDCG 是给自己贴金。Recall@5 回答「该捞的捞到没有」,MRR 回答「第一个对的排第几」,这两个够定位问题了。
26 个问题是什么水平?说实话,只够看趋势。多份公开实践给的口径是 50 到 200 条才有统计意义,低于这个数指标波动不小,0.06 的差距别当真。我个人的习惯是先攒 30 条跑起来,别等完美了再动手。另外评测集里应该放无答案问题(比如「MCP 的认证机制怎么配」,语料里根本没讲),考的是系统会不会硬答——这篇没放进指标,下篇补。
切分大小和重叠率:300 字符配 15% 是甜点
切分用的是最朴素的句子聚合:按句号、分号、换行断句,然后贪心拼接到目标长度,重叠部分按字符数从上一块末尾回退。代码二十行,没有任何黑魔法:
def chunk_text(text, max_chars, oveRLap_chars):
    sents = split_sentences(text)  # 按 。!?;\n 断句
    chunks, cur = [], ""
    for s in sents:
        if cur and len(cur) + len(s) > max_chars:
            chunks.append(cur)
            cur = cur[-overlap_chars:] if overlap_chars > 0 else ""
        cur += s
    if cur.strip():
        chunks.append(cur)
    return [c.strip() for c in chunks if c.strip()]
九种配置,每种都全量重建索引再跑 26 问。结果如下:
| 切块字符 | 重叠 | 块数 | Recall@5 | MRR | Recall@1 |
|---|---|---|---|---|---|
| 150 | 0% | 46 | 0.962 | 0.827 | 0.731 |
| 150 | 15% | 55 | 0.923 | 0.745 | 0.615 |
| 150 | 30% | 66 | 0.962 | 0.732 | 0.577 |
| 300 | 0% | 24 | 0.962 | 0.811 | 0.692 |
| 300 | 15% | 26 | 1.000 | 0.886 | 0.808 |
| 300 | 30% | 28 | 1.000 | 0.867 | 0.769 |
| 600 | 0% | 14 | 1.000 | 0.865 | 0.769 |
| 600 | 15% | 14 | 1.000 | 0.885 | 0.808 |
| 600 | 30% | 14 | 1.000 | 0.891 | 0.808 |
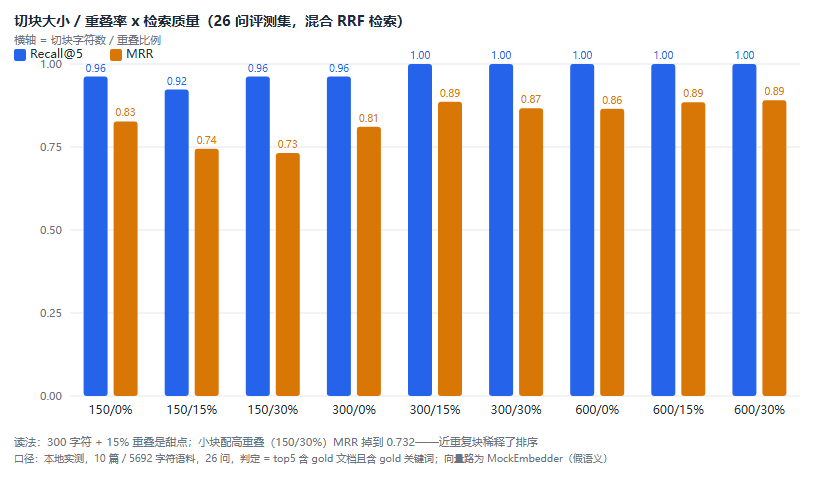
图 1:九种切分配置的 Recall@5 与 MRR 对比,Recall@5 到顶之后 MRR 才有区分度
先看 Recall@5:300 和 600 两档基本都能打满,小块 150 反而在 15% 重叠时掉到 0.923。答案块太小,关键词被稀释,个别问题捞不回来。
真正有信息量的是 MRR。300 字符配 15% 重叠拿到 0.886,是全场最佳组合;而 150 字符配 30% 重叠只有 0.732,比同样 150 字符不重叠的 0.827 还低。这个结果我没想到——重叠率不是越高越好,小块配高重叠会制造大量近重复块,RRF 融合时同一事实的多个副本互相挤占排名,反而把正确答案顶下去了。
大块 600 的 Recall@5 全部打满,看起来很美,但 Recall@1 只有 0.81。答案确实在块里,可块里还有五百字废话,排序时分摊了相关性。而且 600 字符的块直接喂给生成模型,token 成本是小块的四倍,噪声也多。我的判断:大块适合答案本身就需要长上下文的场景(总结、对比),事实型问答用它是花冤枉钱。
这里必须说明口径:我用的是字符数不是 token 数。中文语料里字符和 token 的比例相对稳定,同口径横向比没问题,但绝对值别拿去跟教程里的 512 token 直接对照。真要上生产,把 len() 换成 tiktoken 的编码器,改动不超过三行。
块数那列也值得看一眼:46 → 26 → 14。索引体积和每次查询的扫描量差出去三倍,这是切分大小在工程账上的另一面。
三种检索方式:纯 BM25 赢了,但我劝你别信
切分固定成甜点配置(300 字符 / 15%),换检索方式再跑一遍:
| 检索方式 | Recall@5 | MRR | 直问 | 同义 | 专名 | 边界 |
|---|---|---|---|---|---|---|
| 纯 BM25 | 1.000 | 0.936 | 7/7 | 9/9 | 9/9 | 1/1 |
| 纯向量 | 0.885 | 0.613 | 6/7 | 8/9 | 8/9 | 1/1 |
| 混合 RRF | 1.000 | 0.886 | 7/7 | 9/9 | 9/9 | 1/1 |
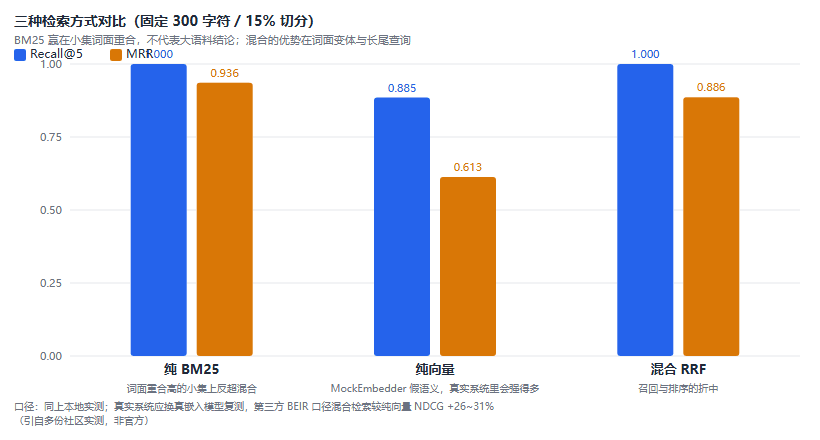
图 2:词面重合高的小评测集上,纯 BM25 的 MRR 反超混合检索,这是评测集特性不是通用结论
纯 BM25 的 MRR 0.936,把混合检索的 0.886 按在地上。按教程的说法这时候应该怀疑人生,但我劝你先看看两个前提。
第一,我的向量路是 MockEmbedder——用 MD5 哈希把词袋投影到 128 维的假向量,没有任何语义能力。同义词在它眼里就是两个完全不同的词,这个瘸腿向量参与 RRF 融合,不拖后腿就算客气。真实系统里换个 BGE-M3 或 text-embedding-3,向量那一路的表现完全是另一回事。
第二,26 个问题的词面重合度偏高。「Inspector 默认端口号是多少」这种问法,原文里「Inspector」「端口」原样存在,BM25 的精确匹配优势被放大。换一批口语化重写的问题,BM25 立刻趴。
多份公开实测的结论是混合检索比纯向量 NDCG 高 26 到 31 个百分点,这些数字来自真嵌入模型、真语料,不是我这张表能复现的。我认为更稳的读法是:混合检索的价值在词面变体和长尾查询上兜底,在小型高重合语料上体现不出来。如果你的查询集就是关键词式的高重合问法,先别急着建混合索引,把评测集扩到 50 条再说。
顺带说个 FTS5 的坑。BM25 的 MATCH 语法里,空格分隔的词默认是 AND 关系,长查询全命中太严——我第一版查询构造直接拼空格,26 问里对不上两个词的文档全被筛掉,纯 BM25 的 Recall 一度只有 0.25,惨不忍睹。改成 OR 连接让候选都进来打分才恢复正常:
def search_bm25(self, query, k=10):
    terms = bigrams(query)
    q = " OR ".join(terms)  # AND 改 OR,别让布尔匹配提前枪毙候选
    rows = conn.execute(
        "SELECT rowid, bm25(chunks_fts) FROM chunks_fts WHERE chunks_fts MATCH ? ORDER BY rank LIMIT ?",
        (q, k)).fetchall()
    return [(r[0] - 1, -r[1]) for r in rows]  # bm25() 返回负数,取负转成正向分
k 值:调到 5 就到顶,再加就是给 token 账单捐款
候选池大小的影响:
| k | Recall@k | MRR |
|---|---|---|
| 1 | 0.885 | 0.885 |
| 3 | 0.923 | 0.885 |
| 5 | 1.000 | 0.886 |
| 10 | 1.000 | 0.873 |
k 从 3 加到 5,Recall 从 0.923 抬到 1.000,这是有效投入。再加到 10,Recall 不动,MRR 反而从 0.886 微降到 0.873。候选池变大之后,低质候选混进 RRF 融合,把靠前的排名稀释了。
成本那边更直白:k 决定最后塞进 prompt 的块数,k=10 的 token 消耗是 k=5 的两倍。这个小语料上 k=5 之后再加纯亏。当然这是 26 问的结论,语料大了答案埋得深,该加还得加——用评测集的曲线说话,别用感觉。
重排:单步收益最大,但它救不了召回缺失
重排是这篇里唯一没法本地实测的部分。交叉编码器要真模型,我手头没有 GPU,硬跑一个量化版小模型反而误导读者,所以这节的数据全部引用第三方口径,接入代码给你,效果数字看别人的。
公开 BEIR 平均 NDCG@10(多个独立来源口径一致):
| 方案 | NDCG@10 |
|---|---|
| BM25 单独 | 41.7 |
| BGE-base 双编码器 | 51.0 |
| 双编码器 + 交叉编码器重排 | 56.5 |
重排一步贡献 5 个点以上,是整条链路上单步收益最大的改造。模型选择上,bge-reranker-v2-m3 是 568M 参数、MIT 协议、多语言,自托管首选;不想运维就上 Cohere Rerank 3.5,按搜索次数计费,每千次 2 美元;CPU 或边缘场景看 FlashRank,蒸馏过的轻量版。
代价是延迟:50 个候选通常多花 100 到 300 毫秒,候选数翻倍延迟也翻倍。所以短名单控制在 50 到 100,别把重排当全库检索用。
接入就是几行,在第一阶段检索之后插一刀:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # 或换 Cohere API,只改这一行
candidates = retriever.search(query, k=50)          # 阶段一:粗召回 50 条
pairs = [(query, c.text) for c in candidates]
scores = reranker.predict(pairs)                    # 阶段二:逐对精细打分
top = [c for c, _ in sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)[:5]]
但有个前提必须说死:重排只能重排候选集里的东西。上一篇「MCP 是谁发布的」排错,是因为正确答案压根没进候选集,这时候上天价重排也没用。先修召回,再谈重排,顺序反了全是白工。
我的调参顺序:先定位层,再动参数
跑完这一圈,我把调参流程固化成了图里这个顺序。核心思路是先判断问题出在哪一层,再拧那一层的旋钮,一次只改一个变量。
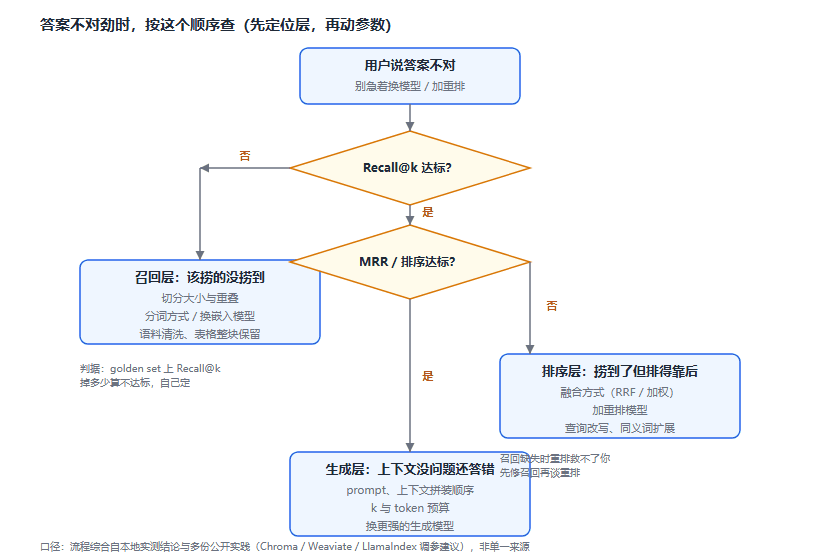
图 3:答案不对劲时,先用 golden set 定位是召回、排序还是生成层的问题,再动对应参数
具体到顺序:建评测集(30 条起步)→ 定切分大小和重叠 → 定检索方式和融合参数 → 上重排 → 最后才动 prompt 和生成模型。反过来做的人我见过不少,prompt 改了十几版,最后发现是切分把答案切碎了。
「一次只改一个变量」这条听着像废话,实操中最容易违反的就是它。同时换嵌入模型加切分大小,指标涨了你说不清是谁的功劳,跌了也不知道回滚哪个。改之前记一笔,跑完对比,留着记录。
这套结论的适用边界
把丑话说在前面,这篇的数字别直接搬:
- 语料只有 5692 字符、26 个问题。趋势可信,绝对值不可信,0.06 以内的差距我认为是噪声。
- 向量路是 MockEmbedder 假语义,第三节 BM25 赢混合的结论不适用于真嵌入模型的系统。
- 字符切分不是 token 切分,跟教程里的 512 token 不是一回事。
- 单机 SQLite 毫秒级响应,换成分布式向量库,延迟和 k 的权衡逻辑会变。
- 没测的东西不少:查询改写、HyDE、ColBERT、上下文检索头(Anthropic 那套给块加 LLM 生成标题的做法)、语义切分。这些要么要 GPU 要么要调 API,留坑。
还有个存疑点:RRF 的 k 常数我固定在 60,没扫。小语料上 10 到 60 区间的影响应该不大,但这个判断我没验证过,不敢写死。
FAQ
Q:切分到底切多大合适?
A:300 到 512 字符(token)是通用起点,事实型查询偏小,分析型偏大。有厂商基准显示 256-512 适合事实问答、512-1024 适合多跳推理,但那是他们的数据。拿你的评测集扫三档,一下午就有答案。
Q:重叠率一定要加吗?
A:不一定。我的实测里小块配 30% 重叠反而掉分,近重复块稀释排序。如果切分本来就切在话题边界(语义切分),0% 重叠完全合理。先测边界问题在不在候选里,不在再加。
Q:混合检索一定比单路好吗?
A:我的小集上没赢,但那是假向量加高词面重合的特殊条件。公开实测里混合多数场景更稳,尤其是专名和口语混杂的查询集。我的建议:混合作为默认,但如果你的 BM25 单独就打到 0.9 以上,先扩评测集再决定。
Q:重排模型选哪个?
A:自托管起步 BGE-Reranker-v2-m3(MIT、多语言),CPU 场景 FlashRank,不想管基础设施 Cohere Rerank。别忘了先确认召回够不够,召回缺失时重排是零收益。
Q:评测集要多大才够?
A:30 条能跑趋势,50 条以上结论才硬。必须包含无答案问题,考的是系统会不会一本正经地编。标注标片段不标整篇,双人标不一致的直接扔。
结语
这一圈跑下来,我最想说的不是哪个参数最优,而是调优的起点根本不是参数,是评测集。没有 26 个带标准答案的问题,前面所有「推荐配置」都只是别人的经验搬运。300 字符配 15% 重叠适合我这摊数据,你的数据大概率不一样——但拧旋钮的方法是一样的。
下一篇讲大模型 API 的工程实践:重试、限流、缓存和成本控制,把「能跑」变成「敢上线」。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。