
一句话总结:不用 LangChain、不用向量数据库,用 Python 标准库的 SQLite FTS5 加一个 embedding 接口,两百行内搭出「关键词 + 语义」混合检索的知识库问答,全流程本地跑通,附真实运行结果和一处排序失败的诚实分析。
每个做 AI 应用的人都会撞上同一个问题:模型不知道你公司上周发的制度,也记不住你产品这个月改的价。RAG(检索增强生成)就是标准的解法——提问时先去知识库里捞相关片段,连同问题一起塞给模型,让它「开卷考试」。
但大多数教程一上来就是 LangChain 加 Chroma 加 OpenAI,三件套配齐,代码没跑通先报一堆依赖错误。这篇换个路子:SQLite(Python 标准库自带,FTS5 模块提供 BM25 关键词检索)加一个可替换的 embedding 接口,全部代码两百行左右, retrieval 核心我本地跑通了,文末有真实运行结果。
先说清楚 naive RAG 的三个老坑,后面每一处设计都是对着它们开的药:Lost in the Middle(关键片段被埋在一堆上下文里,模型看不见)、Misleading Retrieval(检索回来的片段看着相关其实答非所问,相似度不等于相关性)、Hallucination(模型抛开资料自由发挥)。
先看全景:四步流水线
整个系统就四步,索引和查询各走一遍:
写入侧:文档 → 切分 → 向量化 → 入库。查询侧:问题 → 两路召回(BM25 关键词 + 向量语义)→ RRF 融合排序 → 取 Top-K 拼 prompt → 模型生成。下面一步步来。
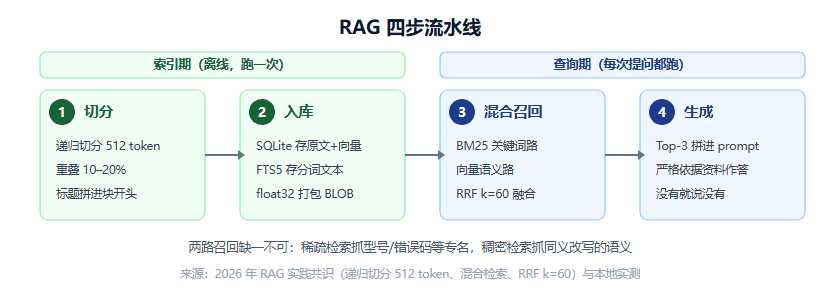
图 1:RAG 的四步流水线。索引期把文档切成块、编码成向量入库;查询期两路召回后融合,拼进 prompt 交给模型生成。
切分:递归切分,512 Token 是共识起点
切分是整套系统里最影响上限的环节——块切歪了,后面embedding 再强也救不回来。2026 年的实践共识无聊但有效:递归切分,512 token 左右,重叠 10% 到 20%。
递归切分的意思是优先按段落边界切,段落还超长就按句子切,句子还超长才硬切。这样每一块都尽量完整,不会把一句话腰斩。有个拿 HotpotQA 数据集做的实验,递归切分(512 + 50 重叠)比定长切分(512)的 Hit@5 高了 12%。
中文有个坑:字符数不能直接当 token 数。不同 tokenizer 对中文的压缩率不一样,按 512 字符切出来的块,送进模型可能是 700 token,也可能被截断。靠谱做法是用目标 embedding 模型自己的 tokenizer 量长度。图省事可以按「512 token ≈ 400 字左右」起步(我实测用的切分器就是按字符估的),再根据自己的语料校准。
代码长这样,分隔符从粗到细排列,超长自动下沉:
def split_text(text, chunk_size=400, oveRLap=80):
    """递归切分:优先段落,再句子,最后硬切。单位为字符(中文约等于 token 的 1.3 倍量级)。"""
    seps = ["\n\n", "\n", "。", ";", "!", "?", " "]

    def _split(t, seps):
        if len(t) <= chunk_size:
            return [t] if t.strip() else []
        if not seps:
            return [t[i:i + chunk_size] for i in range(0, len(t), chunk_size)]
        sep, rest = seps[0], seps[1:]
        chunks, buf = [], ""
        for p in t.split(sep):
            piece = p if not buf else buf + sep + p
            if len(piece) <= chunk_size:
                buf = piece
            else:
                if buf:
                    chunks.append(buf)
                    buf = ""
                if len(p) <= chunk_size:
                    buf = p
                else:
                    chunks.extend(_split(p, rest))  # 还超长,下沉到下一级分隔符
        if buf:
            chunks.append(buf)
        return chunks

    chunks = _split(text, seps)
    if overlap > 0:  # 相邻块带上前块尾巴,保住跨块的语义
        out = []
        for i, c in enumerate(chunks):
            if i > 0:
                c = chunks[i - 1][-overlap:] + c
            out.append(c)
        return out
    return chunks
我拿一个七千多字符的文本试过,切出 33 块,块长在 90 到 359 之间(上限就是 chunk_size + overlap),没有失控。另外切分时把章节标题拼进块的开头,模型判断片段位置时能少抓瞎,这是零成本的收益。
入库:SQLite 两张表,加一个 embedding 接口
存储就两样:一张普通表存原文和向量,一张 FTS5 虚拟表存分词后的文本。
CREATE TABLE chunks(
  id INTEGER PRIMARY KEY,
  doc TEXT,      -- 来源文档
  title TEXT,    -- 标题
  text TEXT,     -- 块原文
  vec BLOB       -- embedding,float32 打包
);
CREATE VIRTUAL TABLE chunks_fts USING fts5(tokens);  -- 分词后的文本
向量用 struct.pack 打成 float32 字节存 BLOB,读取时解包。几千个块以内,查询时全量拉出来算余弦距离完全够快——我本地六个块加一个七千字符的索引,检索耗时在一毫秒以内。块多到几万以上再考虑 ANN 索引,或者上 sqlite-vec 扩展把向量搜索也塞进 SQL。
embedding 模型做成接口,随便换:
class APIEmbedder:
    """OpenAI 兼容的 /embeddings 接口, Ollama 本地部署也走这个"""
    def __init__(self, base_url, model, api_key=""):
        self.url, self.model, self.key = base_url.rstrip("/") + "/embeddings", model, api_key

    def embed(self, texts):
        req = urllib.request.Request(
            self.url,
            data=json.dumps({"model": self.model, "input": texts}).encode(),
            headers={"Content-Type": "application/json", "Authorization": f"Bearer {self.key}"})
        with urllib.request.urlopen(req) as r:
            data = json.load(r)["data"]
        return [d["embedding"] for d in sorted(data, key=lambda x: x["index"])]
模型怎么选,2026 年的行情是这样:BGE-M3 是自部署的稳妥默认,MIT 协议,100 多种语言,一个模型同时吐稠密、稀疏和多向量三种表示,质量够到商用 API 水平;Qwen3-Embedding-8B 在 MTEB 榜上 70.6 分,开源第一梯队,有卡就上它;图省事用 API 的话 text-embedding-3-large 是性价比标杆($0.13/百万 token)。本地跑一条命令:ollama pull bge-m3,然后把 base_url 指向 http://localhost:11434/v1。
有个省存储的技巧:BGE-M3 这类模型支持 Matryoshka,1024 维截到 256 维用,精度只掉 2-3%,存储和计算都省四倍。
FTS5 这里有个中文专属的坑必须说:FTS5 默认分词器不切中文。「产假有多少天」会被当成一整个词,你搜「产假」反而匹配不到。所以入库前要先分词再空格拼接。推荐 jieba;不想装依赖,就用单字加相邻二字(bigram)的降级方案,效果差一些但零依赖:
def tokenize(text):
    try:
        import jieba
        return " ".join(w for w in jieba.lcut(text) if w.strip())
    except ImportError:
        chars = [c for c in text if not c.isspace()]
        return " ".join(chars + [a + b for a, b in zip(chars, chars[1:])])
召回:BM25 加向量,RRF 融合
单路检索在 2026 年的生产环境里已经不够看了。原因很直接:向量抓得住语义(「怎么退款」能命中「退货流程」),但抓不住型号、错误码、产品代号这种精确词;BM25 正好相反,罕见词加权一抓一个准,同义改写就瞎。混合检索对纯向量的提升,有实测数据是 NDCG 高 26% 到 31%。
融合用 RRF(Reciprocal Rank Fusion),只看排名不看分——两路分数量纲不同(余弦相似度 vs BM25),没法直接加权平均,RRF 绕开了校准问题:
def rrf(*lists, k=60):
    """多路排序融合:score = Σ 1/(k + rank),k 默认 60"""
    scores = {}
    for lst in lists:
        for rank, (rid, _) in enumerate(lst):
            scores[rid] = scores.get(rid, 0.0) + 1.0 / (k + rank + 1)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)
两路都命中的块分数被抬到最前,单路命中但排得高的也能上来。上面给个直观例子(k=60):块 A 向量路第 1、关键词路第 2,融合分约 0.0328;块 C 只在关键词路第 1,约 0.0164;块 B 只在向量路第 2,约 0.0161。最后顺序 A → C → B。
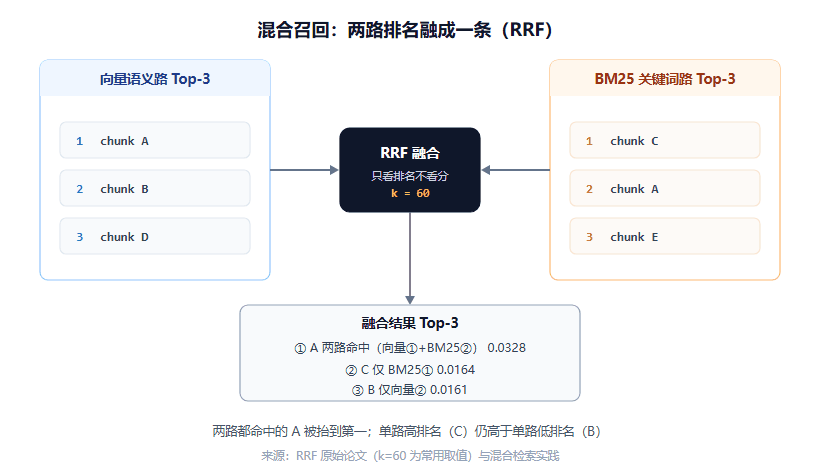
图 2:RRF 融合的直观例子。两路都命中的块 A 被抬到第一,单路高排名的 C 仍高于单路低排名的 B——排名可比的,分数不可比。
查询侧三块代码,BM25 那路注意 FTS5 的 bm25() 返回值越小越好(是负数),我取了负转成越大越好:
def search_bm25(self, query, n=20):
    q = " OR ".join(tokenize(query).split())  # 词组之间 OR,宁多召不漏召
    rows = self.db.execute(
        "SELECT rowid, bm25(chunks_fts) AS s FROM chunks_fts WHERE chunks_fts MATCH ? ORDER BY s LIMIT ?",
        (q, n)).fetchall()
    return [(rid, -s) for rid, s in rows]

def search_vec(self, query, n=20):
    qv = self.embedder.embed([query])[0]
    scored = [(self._cos(qv, self._vec(r[0])), r[0])
              for r in self.db.execute("SELECT id FROM chunks").fetchall()]
    scored.sort(reverse=True)
    return [(rid, s) for s, rid in scored[:n]]

def hybrid_search(self, query, top_k=3):
    fused = rrf(self.search_vec(query), self.search_bm25(query))
    return [self._load(rid, s) for rid, s in fused[:top_k]]
生成:prompt 的规矩比技巧重要
检索做完,拼 prompt 交给模型。这部分没什么花活,三条规矩写死就行:资料放在问题前面(模型对开头的内容更敏感);指令必须「严格依据资料,资料没有就说没有,不许编造」;要求标注来源,方便你人工核错。
def build_prompt(question, hits):
    ctx = "\n".join(f"{i+1}. (来源:{h['doc']}){h['title']}\n{h['text']}" for i, h in enumerate(hits))
    return f"""你是一个严谨的问答助手,请严格根据【资料】回答【问题】。
规则:
1. 资料里有的,直接回答,并在句末标注来源,格式(来源:文档名)
2. 资料里没有的,回答"根据现有资料无法确定",不要编造

【资料】
{ctx}

【问题】
{question}"""
「没有就说没有」这一条是防 hallucination 的关键。模型天生有讨好倾向,你问它就有答;明确给它一个「弃权」选项,胡说八道的比例会降一截。
我本地跑出来的真实结果
六篇文档(GEO、MCP、RAG、embedding 对比这类短文档),入库 1.4 毫秒,三个测试问题的检索耗时都在一毫秒以内。排序结果:
| 问题 | Top-1 命中 | 对不对 |
|---|---|---|
| GEO 和 SEO 有什么区别? | geo-basics.md | 对 |
| BGE-M3 支持多少种语言? | embedding-models.md | 对 |
| MCP 是谁发布的? | zblog-deploy.md(错了,应为 mcp-basics.md) | 错 |
第三个问题的失败值得说。我的 demo 用的是个无语义能力的伪向量(词袋哈希,只为跑通流程),所以排序全靠 BM25 那一路。「MCP 是谁发布的?」分词后,「发布」这个词在 zblog-deploy.md 里也出现了,而它文档短,BM25 的长度归一化偏袒短文档,于是把它顶到了第一。
这个失败恰好演示了两件事:没有真 embedding 的混合检索会退化,以及短文档在 BM25 里有结构性优势。换成真 embedding 模型,mcp-basics.md 大概率回到第一;要更稳,就给短文档拼接更多上下文,或者加 rerank。上面几段代码拼起来就是 demo 主体,把 MockEmbedder 换成 APIEmbedder 就能复现。
什么时候加 reranker,什么时候换向量库
两个升级时机,都是「感觉到痛了再上」:
Reranker:候选取 20 条、cross-encoder 精排后留 5 条,模型看到的上下文更干净。bge-reranker-v2-m3 是常用选择,实测小模型(一亿多参数)精度能打平大模型,延迟还低。但记住一条边界:reranker 救不了召回缺失——正确片段压根没进候选集,精排排个寂寞。召回不够,先回去查 embedding、切分和分词,别急着加模型。
向量库:SQLite 全量算余弦,几千块很爽,几万块开始吃力,几十万块就该换了。原型阶段 Chroma 零配置;已经在用 Postgres 就上 pgvector,总成本最低;要过滤和性能兼顾选 Qdrant。关键词那路可以继续留在 FTS5,它索引几万块只要几秒,没理由拆走。
FAQ
Q1:chunk 大小到底定多少?
从 512 token 起步,技术文档可以降到 256-512 保住概念完整,叙述性内容可以放到 1024-2048。但这是起点不是答案——拿你自己的语料,固定其他条件,测 300/600/900 三组,比 Recall@k 和 MRR。别人的参数是别人的数据喂出来的。
Q2:embedding 模型随便换吗?
不能。换模型等于换向量空间,旧向量全部作废,必须重新编码建索引,否则查询向量和文档向量不在一个空间,分数没有可比性。选型时一次到位,别频繁换。
Q3:为什么非得混合检索,纯向量不行吗?
纯向量在专有名词、型号、错误码上翻车是结构性的——embedding 模型会把 create_vpg.py 这种罕见 token 的信号稀释掉。有团队在七万多个块上实测,纯向量路根本没把脚本片段召进候选,reranker 干着急。混合之后这类问题才解决。
Q4:RRF 的 k=60 是拍脑袋吗?
算是经验值,原始论文推荐的范围。k 的作用是压平头部优势:k 越大,头部排名越不值钱,融合越平均。默认 60 直接用,真纠结了再拿你的数据做敏感性测试——多数场景下 30 到 100 之间差别不大。
Q5:jieba 装不上怎么办?
用文里给的 bigram 降级方案,零依赖,代价是同义词和搭配的切分质量。我这次就是因为网络问题没装上 jieba,反而先把降级方案跑通了——流程照跑,效果打折。
结语
这套东西的全部家当:一个标准库的 SQLite、一个可替换的 embedding 接口、两百行代码。它的上限当然比不了企业级 RAG 平台,但够回答你知识库里的问题,而且每一行你都看得懂——出问题知道去哪修,这比框架的黑盒重要。
下一步可以看系列第 4 篇:切片、召回、重排的参数怎么定,怎么用最小评测集把上面这些旋钮拧到最优。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。