
一句话总结:调 API 谁都会,上线才是考验开始的地方。这篇把重试、限流、缓存、成本四个旋钮各拧一遍,附一个本地重试模拟的真实数据——立即重试策略看起来最快,实际丢了 6% 的任务还多打了一倍请求。
调 client.chat.completions.create 是一行代码的事。让这一行代码在线上活过一个星期,是另一回事。
我见过太多这样的项目:demo 阶段完美,上线第一天晚高峰开始刷 429,重试逻辑写了个 for i in range(3) 了事,月底收到账单吓一跳。每次报错都原样重发,Token 烧了双倍。这篇讲四个旋钮:重试、限流、缓存、成本控制。每个都有本地实测数字或官方标价算出来的账,不空谈。
重试:第一件事是分清哪些错误不配重试
大部分教程教你怎么重试,很少有人先教你别重试哪些。我的分类表:
| 状态码 | 含义 | 该不该重试 | 做法 |
|---|---|---|---|
| 429 | 限流 | 重试 | 指数退避 + 抖动,优先看 Retry-After 头 |
| 500 / 502 / 503 | 服务端抽风 | 重试 | 指数退避,最多 3-5 次 |
| 超时 | 生成慢或网络断 | 看情况 | 流式请求要在迭代器上捕获异常 |
| 400 | 请求体错了 | 不重试 | 改了参数再来,重试纯浪费额度 |
| 401 / 403 | 密钥或权限 | 不重试 | 立即告警,人工介入 |
| 413 | 上下文超限 | 不重试 | 缩 prompt 或换大窗口模型 |
413 这条最值得说。上下文超限的时候原样重试一百次也没用,正确做法是截断历史或缩 max_tokens,这是另一条代码路径。
四种重试策略,我本地跑了一遍
光说「指数退避加抖动」没有体感,我写了个模拟器:20 个并发线程打一个自写的限流服务端(每秒只放 30 个请求,超出部分 75% 概率回 429、25% 回 503),对比四种策略:
| 策略 | 总耗时 | 总请求数 | 拒绝率 | 任务完成率 |
|---|---|---|---|---|
| 立即重试(无退避) | 3.01s | 222 | 57.7% | 94% |
| 固定间隔 1s | 3.76s | 161 | 38.2% | 99% |
| 指数退避,无抖动 | 10.17s | 155 | 35.6% | 100% |
| 指数退避 + full jitter | 5.66s | 157 | 36.4% | 100% |
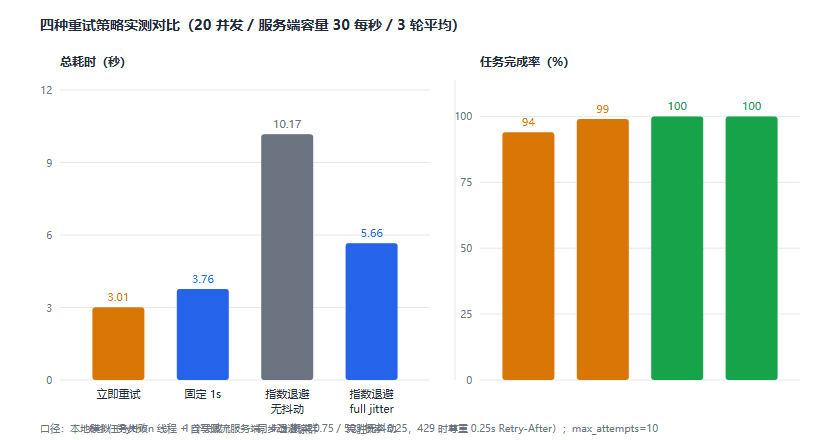
图 1:立即重试总耗时最短但丢了 6% 的任务;full jitter 比无抖动快 44%,同步退避会撞墙
立即重试那行值得盯一眼:总耗时 3.01 秒,全场最快——但有 6 个任务彻底失败了。原因是无退避的重试在同一个限流窗口内瞬间耗尽 10 次尝试,任务直接出局。它还多打了 122 个无效请求(222 对 100),拒绝率 57.7%。翻译一下:你把服务端骂了一顿,自己的任务还没办成。
无抖动的指数退避反而最慢,10.17 秒。20 个 worker 按同一个公式算退避时间,会同时睡着同时醒来,再同时撞墙——这就是惊群。full jitter 在退避时间上加一个均匀随机数,把重试打散到不同时刻,同样 100% 完成只花了 5.66 秒,比无抖动快 44%。
固定间隔 1s 在这个模拟里总请求数最少,但我不推荐。那是节奏巧合:1 秒的固定间隔刚好和服务端的 1 秒窗口对齐。真实环境里多客户端同步重试的代价比这严重得多,full jitter 的稳健性不依赖任何节奏假设。
代码长这样,重点在三处:区分异常类型、优先 Retry-After、full jitter:
import random
import time
from functools import wraps
from OpenAI import OpenAI, RateLiMITError, APIConnectionError, InternalServerError

def with_retry(max_attempts=5, base=0.5, cap=30.0):
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            for attempt in range(max_attempts):
                try:
                    return fn(*args, **kwargs)
                except (RateLimitError, APIConnectionError, InternalServerError) as e:
                    if attempt == max_attempts - 1:
                        raise
                    resp = getattr(e, "response", None)
                    retry_after = resp.headers.get("retry-after") if resp else None
                    if retry_after:
                        time.sleep(float(retry_after) + 0.1)  # 听服务端的
                    else:
                        delay = min(cap, base * (2 ** attempt))
                        time.sleep(random.uniform(0, delay))  # full jitter
        return wrapper
    return decorator

client = OpenAI()

@with_retry(max_attempts=5)
def chat(prompt: str):
    return client.chat.completions.create(
        model="gpt-5.4-mini",
        messages=[{"role": "user", "content": prompt}],
    )
注意这个装饰器只抓三种异常,400/401/413 会直接抛出去。那些错误该 fail fast,重试是浪费。
限流:先搞清楚你超的是哪种额度
限流不只有请求数(RPM)一种,还有 token 数(TPM)。后者更阴险:你以为是请求发太勤,其实是几个大 prompt 把 token 配额吃光了。这种情况干等没用,重试前先把 max_tokens 降下来、prompt 砍一截,比退避一分钟管用。
服务端其实把答案写在响应头里。OpenAI 返回 x-ratelimit-remaining-requests 和 x-ratelimit-reset-requests(还有 token 版),Anthropic 的 429 带 retry-after。看到这些头就照着睡,别自己猜退避时间。
应用层有三个动作,按见效速度排:
分泳道。 实时聊天、交互摘要、后台批处理、离线重算,四种活不该抢同一份额度。我的做法是后台任务单独一路,限流紧张时自动暂停,用户无感知。最怕的是 nightly job 把线上用户的额度吃光——这种事故我听过不止一次。
上队列。 长任务(文档解析、批量打标、重算向量)别在 HTTP 请求里硬等,进队列慢慢消化。用户那边看到的是「处理中,完成后通知」,不是白屏转圈。队列天然削峰,还把重试逻辑收拢到一处。
限并发。 按 provider、按 model、按用户三个维度各设并发上限。这是背压:入口慢了,系统不会炸。
持续失败还要有熔断:连续 N 次失败就把这条路开路一段时间,半开探活。不然你会在一个已经死掉的模型上反复撞头,每次都撞到限流。
缓存:收益最大的一行改动
如果这篇只允许留一句话,我会留这句:静态内容放前面,打开缓存。
两家的机制不一样,说清楚:
OpenAI 侧是自动的。prompt 前缀相同就命中,GPT-5 系列缓存输入打一折($0.125/MTok,标准 $1.25),GPT-4.1 系列七五折。你要做的只是把不变的 system prompt、few-shot 示例、文档上下文放到请求开头——前缀匹配,中间改一个字,后面全部作废。
Anthropic 侧要显式加 cache_control。价格结构是:5 分钟缓存写 1.25 倍价、1 小时写 2 倍、命中读取 0.1 倍(一折)。账很好算:5 分钟档写一次 1.25 倍,只要命中一次就回本(1.25 + 0.1 = 1.35,小于两次原价 2.0)。1 小时档写 2 倍,要两次命中才划算。
我按官方标价算了两个账。场景 A 是我在第四篇搭的那个 RAG:50K token 的共享知识库,每天查 1000 次,跑 30 天,Sonnet 4.6($3/$15 每百万 token):
| 方案 | 30 天账单 |
|---|---|
| 不用缓存 | $4,680 |
| 5 分钟缓存(每小时写一次,其余命中) | $754 |
| 降幅 | 84% |
一天一百五十美元降到二十美元,改动就是给 system 块加一个 cache_control: {"type": "ephemeral"}。我认为这是整个 API 工程里 ROI 最高的一行改动,没有之一。
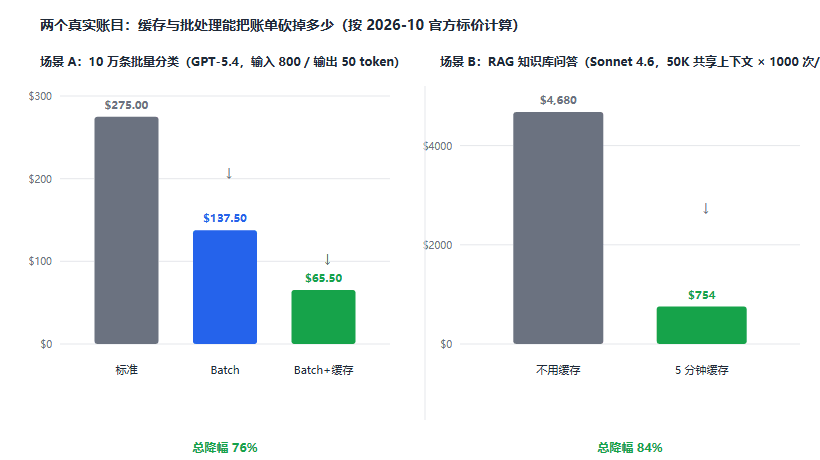
图 2:两个场景的账单阶梯,量级不同所以分开画;场景 B 与公开案例同口径复现
成本:把不能实时的活挪走,把简单的活给小模型
批处理是第二把刀。OpenAI 和 Anthropic 都有 Batch API,逻辑一样:任务不追求实时,24 小时内出结果,输入输出全部五折。OpenAI 还加了个 priority 档,约 4 小时返回,贵两成。夜间报告生成、离线评测、数据打标、向量重算,这些都该进 batch,前提是没有用户盯着屏幕等。
还是 10 万条分类任务(输入 800 / 输出 50 token),GPT-5.4($2.50/$15):
| 方案 | 账单 |
|---|---|
| 标准 | $275.00 |
| Batch | $137.50 |
| Batch + 80% 前缀走缓存 | $65.50 |
三刀砍下去剩四分之一。Anthropic 那边叠加更狠,batch 五折和缓存一折乘起来,Opus 4.7 的缓存输入从 $5.00 干到 $0.25 每百万 token,等于标准价的 5%——不过这个数字来自第三方对官方价格的复现,我自己没有 Anthropic 的账单可以验证。
第三刀是模型路由。分类、抽取、短摘要这类活,70% 的流量扔给 mini 版模型,账单直接砍半(同一个场景从 $275 降到 $140.25)。我在上一批文章里提过这个思路:先定任务的难度档位,再选模型,不要拿旗舰模型干体力活。
路由的工程要点是兜底:小模型答不好要能升级到大模型重试。常见做法是先小模型跑,置信度低或格式校验失败再上大模型,多花的钱远比全量大模型少。
落地顺序:先计量,再动刀
四个旋钮不是同时拧的。我的顺序:
- 先埋计量。 每个功能记录:每次用户动作发起几次 AI 调用、平均输入输出 token、重试率、fallback 率。没有这些数字,后面所有优化都是猜。有个反直觉的事实:很多团队以为贵在模型单价,其实是某个循环在反复重试。
- 修重试。 按上面的分类表实现,半天工作量,立刻止住无效消耗。
- 开缓存。 把 system prompt 和文档上下文的顺序理顺,能自动命中的就自动命中。
- 挪 batch。 盘一遍流量,把没有用户等待的任务全挪进异步队列。
- 做路由。 最后动模型分级,因为它影响输出质量,需要评测集兜底。
每加一个旋钮,对比前后两周的账单曲线。降了,留下;没降,回滚。别信「理论上能省」。
边界与存疑
丑话说前面:
- 价格全部是 2026 年 10 月的官方页面口径,促销会变(GPT-5.6 Sol 的促销价就标了只到 11 月 21 日),下单前以当时页面为准。
- 重试模拟是我自写的服务端模型,真实厂商的限流算法(令牌桶、滑动窗口、按 key 分级)比我这个复杂,结论的方向可信,具体数字别当真。
- 缓存降幅强依赖流量模式。场景 B 的 84% 建立在「同一份知识库被反复查」上,如果每次查询的上下文都不一样,缓存收益趋近于零。
- 比成本要按任务比,不要按 token 比。Anthropic 自己提过 Opus 4.7 之后换了 tokenizer,同样文本会多出约三成 token,单价低不代表任务便宜。
- 语义缓存(相似问题直接返回缓存答案)我没测。它对召回的准确性有风险,相似不等于等价,我持保留态度。
FAQ
Q:429 到底重试几次合适?
A:3 到 5 次,配合 Retry-After 头。超过还失败就降级或进队列,硬刚只会把窗口拖更长。真要抢救,先缩小请求体。
Q:prompt 缓存怎么加,会有坑吗?
A:OpenAI 自动命中,把静态内容放前面即可;Anthropic 在内容块上加 cache_control。最大的坑是顺序:system prompt 里塞了当前时间或用户 ID,整个前缀缓存全部失效,改之前先查有没有这类变量。
Q:Batch API 能用于聊天吗?
A:不能。它的设计前提是 24 小时内出结果。要快又要便宜,看 OpenAI 的 priority 档(约 4 小时)或 flex 档,按延迟预算选。
Q:最狠的省钱路径是什么?
A:按顺序叠:缓存(输入九折到一折)→ 批处理(全量五折)→ 模型路由(大头给小模型)。三样都上,批量场景砍掉七成以上不稀奇。但每样的前提是任务没有用户在等。
Q:重试和幂等有什么关系?
A:纯推理调用是只读的,重试安全。但如果你在拿到响应后才写库、发消息,记得把副作用放在成功之后,否则一次超时重试可能让用户收到两封邮件。
结语
这四个旋钮拧下来,我的判断是:重试决定系统死不死,缓存和批处理决定账单厚不薄,限流决定你半夜会不会被叫起来。顺序上先保命再省钱,计量先行。下一篇讲结构化输出:怎么让模型稳定吐出能直接 json.loads 的 JSON,那又是另一个坑位密集的话题。
- 四种重试策略,我本地跑了一遍
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。