
一句话总结:Step 5 Preview 是阶跃星辰 9 月 20 日发布、10 月 15 日开源的旗舰模型,600B 总参数只激活 27B,92 层"窄而深"架构,1M 上下文、原生视觉。AA 智能指数 44 排全球开源前三,单任务成本 0.71 美元,是 Claude Opus 5 的八分之一。
阶跃星辰这次讲的故事不太一样。
别人发布模型讲参数规模、讲跑分排名。他们讲的是"帕累托前沿"——智能和成本之间那条当前能达到的最佳边界。
翻译成人话:我不跟你比谁最聪明,我比"同样聪明的情况下谁更便宜"。
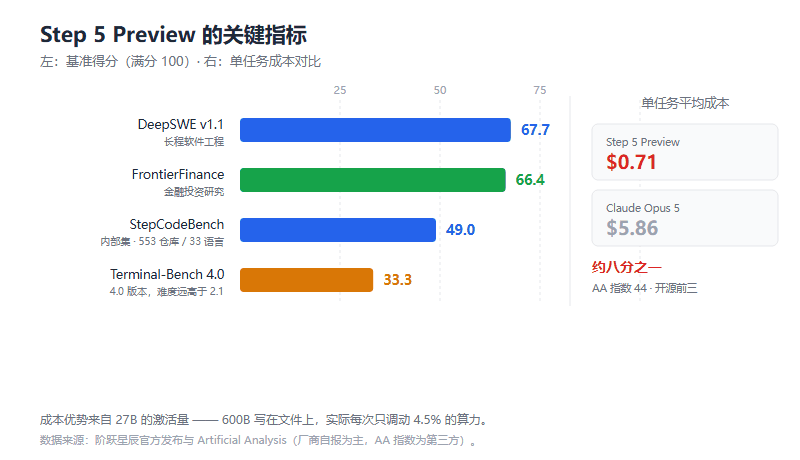
图 1:AA 指数 44 分排开源前三,单任务成本 0.71 美元
规格
| 项目 | 参数 |
|---|---|
| 总参数 | 6000 亿 |
| 每 Token 激活 | 270 亿 |
| 架构 | 稀疏 MoE,92 层 |
| 上下文 | 1M |
| 输入模态 | 文本、视觉 |
| 生成速度 | 约 100 tokens/s |
| 开源协议 | 开放权重(BF16 / FP8) |
| 发布时间 | 2026 年 9 月 20 日发布,10 月 15 日开源 |
92 层"窄而深"是什么思路
这是 Step 5 最特别的地方。
它由 92 个 Transformer 模块堆叠而成。作为对比:Qwen3.8 Max、Kimi K3 这些万亿参数级开源模型的深度也在同一量级,但 Step 5 的总参数不到它们的四分之一,激活参数不到三分之一。
也就是说,它用深度换宽度。同样的层数,每层更窄。
为什么深度重要?因为推理链的每一步都要经过完整的前向计算。层数不够,复杂任务的推理就浅;层数够但太宽,算力全花在"带宽"上。
阶跃的取舍是:保持深度,砍掉宽度。
配套的两个设计:
Sparse GQA。分组查询注意力做了稀疏化。
Block-wise Token Merging。把 Indexer 和 Top-k Selection 的成本降低 8 倍。这两个是长上下文稀疏注意力的主要开销,降 8 倍意味着 1M 上下文真的能用。
还有 Context Compaction(上下文压缩)和 Long-horizon RL,专门为长周期 Agent 任务优化。
跑分
官方公布的核心数据:
AA 智能指数 44,全球开源前三。这个数字在开源阵营里是实打实的第一梯队。
DeepSWE v1.1 67.7%。这个基准测长程软件工程,67.7 是个能打的分数。
Terminal-Bench 4.0 33.3%。注意这是 4.0 版本,比 2.1 难得多。33.3 在 4.0 上属于正常水平。
FrontierFinance 66.4。金融投资研究评测,这是它的差异化方向。
StepCodeBench 49 分(内部集)。这个测试集覆盖 553 个独立代码仓库、9 类任务、20 个应用领域、33 种编程语言。规模做得挺认真。
还有一组对比值得看:在 ALE-CLI、FrontierFinance、DRACO 三个基准上,Step 5 Preview 优于 Kimi K3 和 GLM-5.3,仅次于 GPT-6 Astra 或 Claude Opus 5。
这个位置很微妙。它不争第一,稳稳站在第二梯队头部。
成本:真正的卖点
阶跃给的数字:单任务平均成本 0.71 美元(约 4.75 元),Claude Opus 5 是 5.86 美元(约 39.22 元)。
八分之一。
这个成本优势来自激活参数只有 27B。写 600B 在文件上,实际每次推理只调动 27B 的算力。稀疏度做得很激进。
配合 100 tokens/s 的生成速度,它的定位就清楚了:便宜、够快、能力不差。
生态落地比跑分更能说明问题
Step 5 Preview 上线后有两个动作值得注意。
接入腾讯 WorkBuddy。能执行深度研究、信息检索、数据分析、文档与 PPT 生成。这是通用办公场景。
接入豆包 Trae。进入软件工程工作流,做漏洞修复、重构、性能调优。
一个是腾讯的 Agent 工作台,一个是字节的 AI 开发工具。都在第一时间接入了。
OpenRouter 上的数据更直白:截至 10 月 15 日,Step 5 Preview 的 token 用量在周榜、日榜都排第二,近七日约 18.8 万亿 token。
这个量级说明它是真的在被用,不是只在榜上好看。
一个少见的细节:能操作硬件
官方文档里提到一件事:获得开发文档和用户授权后,Step 5 Preview 可以直接调用相机、COM 端口、截图和模拟鼠标输入,完成设备侧的开发与调试。
这个能力听起来像黑客工具,但用在嵌入式开发和硬件调试上是刚需。模型能看见设备屏幕、能模拟输入、能读串口日志,调试效率完全不一样。
短板
是 Preview。名字里写着呢。正式版什么时候出、会不会变,官方没说。
视觉能力没说细。支持视觉输入,但没给具体的多模态基准分数。跟 GLM-5V 那种专门做视觉编程的比,可能不是一个量级。
中文评测数据少。官方公布的几乎都是英文基准。金融那块有 FrontierFinance,但中文业务场景的实测数据不多。
开源协议需要自己确认。官方说 10 月 15 日开源,BF16 和 FP8 上了 HuggingFace 和 ModelScope,但协议类型我在发布公告里没找到明确说明,建议下载前先看仓库 LICENSE。
"前三"这个说法要小心。AA 指数 44 排开源前三,但 AA 的口径每个季度都在调整,跨时间比较意义有限。
怎么用
API:阶跃星辰开放平台。
开源权重:HuggingFace 和 ModelScope(stepfun-ai/Step-5-Preview),BF16 和 FP8 两个版本。
第三方:OpenRouter 可调,已接入 WorkBuddy、TRAE。
常被问的
600B 参数,27B 激活,实际能跑多快? 官方给的是 100 tokens/s。这个速度在 600B 级别里算快的,稀疏激活的好处就在这里。
和 Kimi K3 比怎么样? Step 5 在 ALE-CLI、FrontierFinance、DRACO 上优于 K3,但 K3 的参数规模是它的四倍多,上限更高。日常任务 Step 5 更划算。
金融能力是真的吗? 官方专门做了 FinStepBench 系列内部测试,FrontierFinance 拿 66.4。但金融评测的基准本身争议就大,建议自己拿真实研报测。
值得现在就上生产吗? Preview 版本,谨慎。可以先用 API 做灰度,别直接替换现有主力。
最后
Step 5 Preview 的定位很清楚:它不抢最强,抢最划算。
92 层的窄深架构、27B 激活、0.71 美元的任务成本,这三个数字串起来是一个完整的产品逻辑。在当前这个"参数越堆越大、价格越压越低"的市场里,它选择用架构效率换成本优势。
对多数团队来说,这个交换值得考虑。毕竟真正决定项目能不能跑起来的,往往是账单而不是榜首。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。