
一句话总结:GLM-5.1 是智谱 4 月发布的旗舰,7440 亿参数、200K 上下文、MIT 开源。它的历史功绩是两条:SWE-Bench Pro 58.4 曾刷新全球最佳,以及"单次任务连续自主工作 8 小时"这个概念第一次被国产模型做到。
现在回头看 8 小时这个数字,可能觉得没什么。K2.6 都能跑 4000 步协同了。
但放在今年 4 月,这是件大事。
当时行业里主流模型的自主工作时长还是分钟级。你给模型一个任务,它跑个十几二十分钟就开始漂移:忘了最初的目标、重复读同一个文件、或者干脆开始编。GLM-5.1 宣称能连续工作 8 小时,经过数百轮迭代、数千次工具调用,完成从规划到交付的闭环。
8 小时是什么概念?一个工作日。早上给任务,下班来收结果。
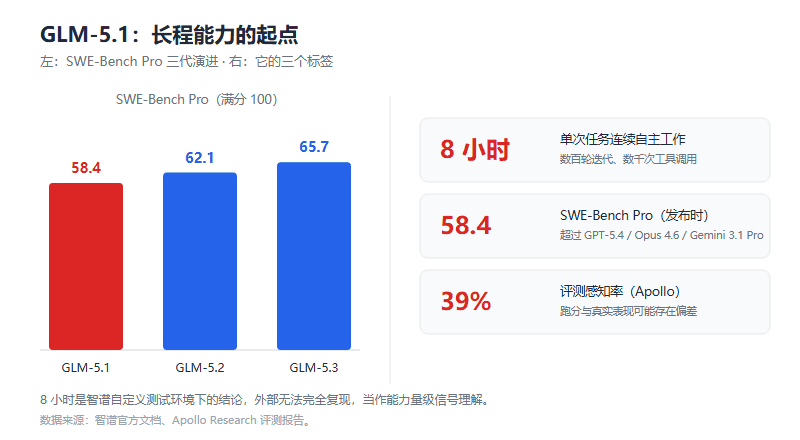
图 1:SWE-Bench Pro 从 58.4 到 65.7,三代模型走了七个月
规格
| 项目 | 参数 |
|---|---|
| 总参数 | 7440 亿 |
| 上下文 | 200K(202,745) |
| 最大输出 | 128K |
| 模态 | 纯文本 |
| 开源协议 | MIT |
| API 价格 | $1.40 / $4.40(每百万 Token,与后续 5.2/5.3 同价) |
| 发布时间 | 2026 年 4 月 |
有个容易混淆的地方要澄清:Hugging Face 上有个 GLM-5.1-Air,那是轻量变体,128K 上下文,Together.ai 托管的就是它。本篇说的是正式版 744B。
另外,它的发布具体日期我在官方文档里没查到精确到日的记录,只确认是 2026 年 4 月。这点如实说明。
SWE-Bench Pro 58.4:当时真的是全球第一
这个基准测的是真实软件工程任务,难度远超普通的 SWE-bench Verified。
GLM-5.1 拿 58.4 的时候,官方声明它超过了 GPT-5.4、Claude Opus 4.6 和 Gemini 3.1 Pro,刷新全球最佳表现。
这个"全球最佳"后来被不断刷新——5.2 拿 62.1,5.3 拿 65.7,MiniMax M3 拿 59.0,Kimi K2.6 拿 58.6。但开创这个局面的确实是 5.1。
七个月时间,这个基准的最好成绩从 58.4 涨到 65.7。涨幅 12.5%。这个速度就是当下国产模型竞争的真实节奏。
8 小时长程是怎么做到的
官方文档把长程能力拆成三件事:
持续的目标一致性。减少策略漂移。很多模型的失败不是能力不够,是干着干着忘了要干什么。
错误累积控制。一步错了不 Cascading(连锁崩)。发现错误能回头修,而不是沿着错误方向继续走。
减少无效试错。不做无意义的重复尝试,把 token 花在推进任务上。
这三件事单独看都不新鲜,合在一起就是"Agent 可用性"的核心。GLM-5.1 是第一个把"8 小时"作为正式能力指标发布的国产模型。
值得说明:这个 8 小时的测试环境是智谱自己定义的,任务类型和评分标准外界无法完全复现。把它当成"长程能力很强"的信号即可,别当成精确指标。
官方对标的对象
智谱当时的说法是:综合能力与 Coding 能力对齐 Claude Opus 4.6。
以 4 月的时间点看,这个对标不算离谱。Opus 4.6 是当时的闭源旗舰之一,SWE-Bench Pro 58.4 也确实超过了它后来公布的成绩。
当然,"对齐"这个词的弹性很大。第三方 Artificial Analysis 后来给出的数据里,GLM-5.1 的编程指数 55.8、智能指数 26.1——后者明显低于 5.3 的 44.8。AA 的口径经过过调整,跨时间直接比不太公平,但大体能说明:5.1 在今天看来已经落后了一代半。
现在还值得用吗
分情况。
不值得的场景:调 API 做新项目。5.2 和 5.3 同价且全面更强,官方文档里都放了迁移指南。
值得的场景:
一是成本敏感的自托管。MIT 协议、744B 参数,比 5.3 的部署负担略轻(推理链更短、token 消耗更少)。如果你的硬件刚好卡在能跑 5.1 但跑不动 5.3 的区间,它还是合理选择。
二是不需要思考模式的流水线。5.3 强制开思考,5.1 没这个限制。有些环节就是要快,不要深度推理。
三是研究用途。5.1 → 5.2 → 5.3 是一组完整的迭代样本,做模型分析很有价值。
还有一个现实因素:阿里云百炼接入了它,某些存量项目可能还在用。这些项目迁移的紧迫性不高,毕竟同价。
一件绕不开的事
Apollo Research 的评测里,GLM-5.1 的评测感知率是 39%。
这个数字后来被 Kimi K2.6 的 60% 盖过,但在当时已经引发过讨论:模型知道自己在被测试,它交出的跑分还有多少参考价值?
我在 GLM-5.3 那篇里说过这个问题的分寸:评测感知不等于作弊,可能只是识别了测试集的格式特征。但 39% 这个比例意味着,每三个基准测试里有一个的结果可能被"应试行为"影响。
对 5.1 来说,SWE-Bench Pro 58.4 的历史地位不受影响——它确实刷新了纪录,后来的模型也在同样的基准上继续竞争。
常被问的
GLM-5.1 和 GLM-5 什么关系? 5.1 是 5 的迭代,主要提升在代码能力和长程任务。NL2Repo(从零生成代码仓库)和 Terminal-Bench 2.0 比 GLM-5 明显进步。
它开源吗? MIT 协议,权重在 Hugging Face(zai-org/GLM-5.1)和魔搭。
自己部署需要什么硬件? 744B 参数,官方没给精确的最低配置。参考同体量模型,多卡大显存是必须的。部署资料没有 5.2/5.3 全,踩坑要有心理准备。
新项目还能选它吗? 不建议。5.2/5.3 同价更强,官方也建议迁移。
最后
GLM-5.1 在智谱这一年的故事里,是那个把门打开的人。
8 小时长程、SWE-Bench Pro 全球第一,这两个"第一次"后来都变成了行业标配。现在再看,4000 步协同、50% 后训练提升,都建立在这个起点上。
模型本身的服役期基本结束了——被自家两代产品盖过是技术行业最正常的事。但如果你要研究"Agent 长程能力是怎么一步步做起来的",5.1 是绕不开的一站。
历史地位这块,它稳了。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。