
一句话总结:DeepSeek-V4-Pro-0813 是 4 月预览版转正的旗舰,架构没动、后训练重做,DeepSWE 从 12.8 分跳到 62.7 分,权重照旧 MIT 开源,但 8 月那次峰谷调价让实际成本涨到了原来的 2.3 到 4.5 倍。
2026 年 8 月 13 日,DeepSeek 把挂了将近四个月的 V4-Pro 预览版转成了正式版,版本号定为 0813。同一份 API 文档更新里,还顺手宣布了峰谷定价,新价格 8 月 17 日生效。当时用的人第一反应都差不多:模型变强了,账单也变厚了。
两个月后的 10 月 17 日,DeepSeek 又放出 V4.1-Flash-1017 快照,官方口径里说这个新 Flash 已经超过了 V4 Pro。那 0813 这个正牌旗舰现在处于什么位置、还值不值得为它多花钱,这篇文章把参数、跑分、价格和接入方式一次说清。
从预览版到正式版:这四个月改了什么
先把时间线捋一遍。4 月 24 日,V4-Pro 以预览版身份上线;8 月 12 日晚间,官网 API 文档悄悄更新出 0813 版本;8 月 13 日正式官宣,同时预告调价;8 月 14 日,国家超算互联网宣布上线正式版和智能体框架 DeepSeek Harness。
有意思的地方在于官方自己承认:模型结构没变。0813 和 4 月预览版共用同一套架构和参数规模,变化出在后训练阶段,Agent 相关的训练数据和策略做了针对性改造,另外挂了一个 DSpark 投机解码模块来提推理效率。
这点我觉得挺难得。很多厂商发「正式版」喜欢把架构升级当卖点一起讲,DeepSeek 反而把话说得很直白:DeepSWE 那个接近四倍的跳升,就是后训练的功劳,跟架构没关系。你可以说这是诚意,也可以说预览版当时确实拉胯,两头都占一点。
核心参数:1.6T 里每次只用 490 亿
| 参数项 | DeepSeek-V4-Pro-0813 |
|---|---|
| 架构 | MoE 混合专家 |
| 总参数 | 约 1.6T |
| 每 Token 激活 | 约 49B |
| 专家配置 | 384 个路由专家 + 1 个共享专家,每次激活 6 个 |
| 精度 | FP4(专家)+ FP8(其余)混合 |
| 上下文窗口 | 1M token |
| 最大输出 | 384K token |
| 输入模态 | 纯文本 |
| 推理档位 | 三档(不思考 / 高 / 最深) |
| 许可证 | MIT(权重开放) |
| 并发上限 | 500 |
| API 模型名 | DeepSeek-V4-Pro-0813 |
长上下文是这套架构真正下功夫的地方。官方叫混合注意力,两块拼起来:压缩稀疏注意力(CSA)加高度压缩注意力(HCA)。效果按模型卡的说法,1M 上下文下单 token 算力约为 V3.2 架构的 27%,KV Cache 需求只占 10%。
翻译成人话:上下文拉到 1M 的时候,这台模型的服务成本不会像上一代那样爆炸。这对两类人意义重大,一是 API 用户(缓存命中便宜),二是想自己部署的团队。总参数 1.6T 听着吓人,但每次推理只激活 49B,配合 FP4 精度,单机多卡堆一堆不是完全碰不起,虽然也绝对不算便宜。
有一点得说清楚:参数规模各来源有点出入。TrueFoundry 的技术博客写 1.7T,官方模型卡和百度百科、百度智能云都写 1.6T,我按多数口径取 1.6T,这个 0.1T 的差异不影响任何使用决策。
跑分:Agent 能力是真的跳了一截
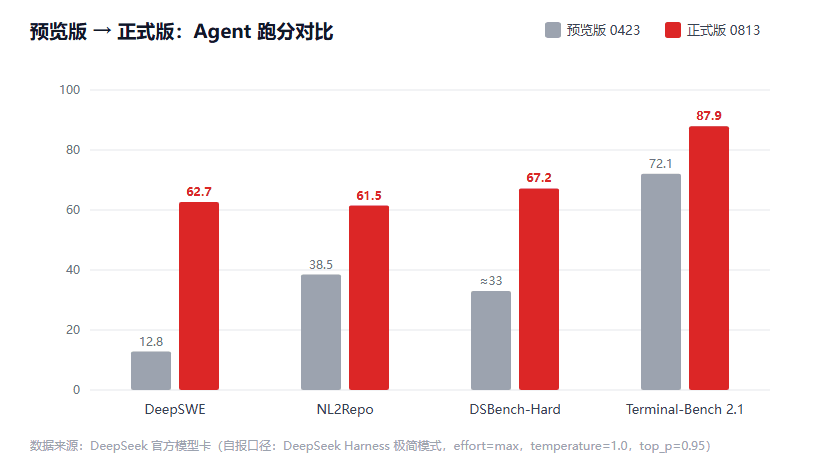
图 1:四个 Agent 基准的预览版(4 月)与正式版(8 月)对比,数据来自 DeepSeek 模型卡
| 测试集 | 预览版(4 月) | 正式版(0813) | 变化 |
|---|---|---|---|
| DeepSWE(软件工程 Agent) | 12.8 | 62.7 | +390% |
| NL2Repo(自然语言生成仓库) | 38.5 | 61.5 | +60% |
| DSBench-Hard(全栈高难编码) | 约 33(推算) | 67.2 | 约翻倍 |
| Terminal-Bench 2.1 | 72.1 | 87.9 | +15.8 |
DeepSWE 这行值得单独说。12.8 分是什么概念?基本等于模型面对一个多步骤代码任务时只会瞎猜,改两下就崩。62.7 分才算真正进了牌桌,跟主流 Agent 产品有了比较的资格。对照组也有:V4-Flash 正式版(7 月 31 日)在 DeepSWE 上是 54.4,Pro 比 Flash 高出约 8 个百分点。
SWE-bench Verified 拿到 96.4%,这个数字有两个口径:官方语境说开源权重第一,第三方 Vals AI 的榜单把它排在 82 个模型的第 2 位。差别大概率出在评测 harness 上,两个都列出来,你自己掂量。
还有个细节不能略过:官方跑分用的是 DeepSeek Harness 极简模式,推理努力级别拉满(max),采样参数 temperature=1.0、top_p=0.95。换句话说,这是「开足马力」的成绩。你日常用低档位去跑,复现不出这个数。老实讲,Agent 类跑分里 harness 的影响经常比模型本身还大,看个趋势就好,别当承诺。
价格:峰谷定价之后,账要重新算
| 项目 | 发布时(8 月上旬) | 8 月 17 日起谷时 | 8 月 17 日起峰值 |
|---|---|---|---|
| 输入(每百万 token) | ¥3 | $0.66 | $1.32 |
| 输出(每百万 token) | ¥6 | $1.98 | $3.96 |
8 月 13 日官宣调价,The Information 9 月底的报道说,这轮涨价让客户的实际成本涨到了之前的 2.3 到 4.5 倍。梁文锋在投资者会议上的回应是:涨价没有导致客户数量下降,需求依然在,而且这个价格在主流大模型里仍属低位。这两句话都对,也都不完整——单价确实还是便宜的,但对比 7 月之前的老用户,心理落差是实打实的。
缓存命中还有一档,第三方聚合站给的数字是每百万 token $0.003625,不过同一个站点给的常规输入价($0.435)跟官方峰谷价($0.66~1.32)对不上,这个口径我没能核实到官方原文,存疑,你以 API 控制台里的实时价格为准。
想省钱的路径倒是清楚的:谷时跑批任务、能命中缓存就命中缓存、思考档位用低档。这三招叠下来,跟峰值裸调的差距能差出一倍多。
怎么接入:三套协议、现成工具和自托管
API 侧按百度智能云的调用示例,模型名传 DeepSeek-V4-Pro-0813。协议支持三套:OpenAI Chat Completions、OpenAI Responses,以及 Anthropic 协议。这意味着 Codex 和 Claude Code 这类主流编程工具基本是即插即用,改个 base_uRL 和模型名就能切过去,具体这些工具怎么选可以看我们之前的海外 AI 编程工具横评。
不想花 API 钱的也有去处。国家超算互联网 8 月 14 日就上线了正式版,连 DeepSeek Harness 智能体框架一起提供。自己有算力的团队,Hugging Face 上 deepseek-ai/DeepSeek-V4-Pro-0813 直接下权重,MIT 许可,商用不用谈。
自托管要掂量的是门槛:1.6T 总参数就算只激活 49B,FP4+FP8 混合精度的部署也不是消费级显卡能碰的。好在 CSA+HCA 把长上下文的算力和显存需求压到了 V3.2 的 27% 和 10%,如果你跑的是长文档批量处理,这笔账比上一代好算很多。
V4 家族现在怎么选
| 型号 | 总参数 / 激活 | 上下文 | 输入价(每百万) | 定位 |
|---|---|---|---|---|
| V4-Flash-0731 | 284B / 13B | 1M | 更低 | 轻量快速档 |
| V4.1-Flash-1017 | 552B / 8B~16B | 1M | $0.15 | 当前性价比主力 |
| V4-Pro-0813 | 1.6T / 49B | 1M | $0.66~1.32(峰谷) | 旗舰,Agent 上限最高 |
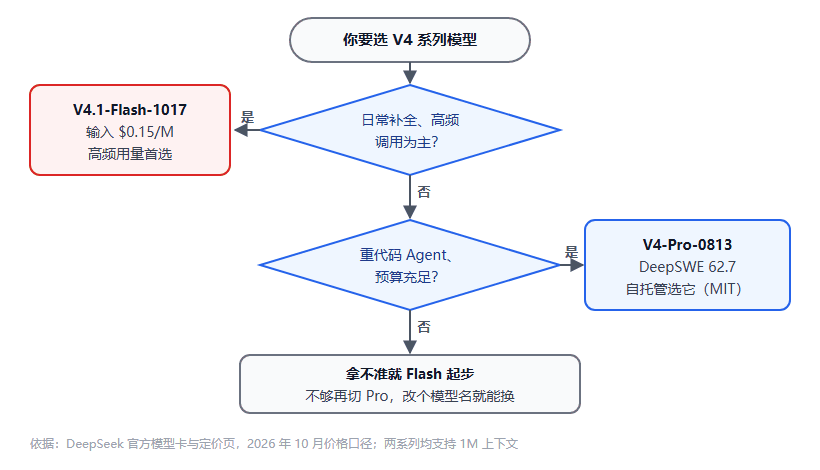
图 2:三款在售 V4 模型的选型路径,价格为 2026 年 10 月口径
我的看法没变过:大多数人用 V4.1-Flash-1017 就够了,输入价只有 Pro 谷时价的四分之一不到,那个版本的细节我们写过一篇专门的拆解。Pro 的价值集中在两处,一是复杂 Agent 任务的成功率上限,二是 MIT 权重给自托管和二次开发留的口子。这两条你都不沾,多花的钱就是白花。
优势与短板
优势说得清:Agent 和代码能力是 V4 家族天花板;1M 上下文的服务成本被架构压下来了;MIT 许可在旗舰模型里几乎独一份;三套 API 协议兼容现成工具链。
短板也别藏着。第一,它不认图,官方模型页和百度智能云文档都标注纯文本输入,不过百度百科的词条里写了「正式版首次原生支持图像推理」,两边冲突,我按官方 API 文档的口径来,这条你以自己实测为准。第二,并发上限 500,大流量场景要提前申请。第三,峰谷定价后成本涨了 2.3 到 4.5 倍,虽然横向比较仍属低价,但环比是实打实的贵了。第四,跑分是官方自报,harness 和参数都开到最满,第三方复测的数字普遍要打些折扣。
常见问题
DeepSeek-V4-Pro-0813 免费吗?
模型本身收费,走峰谷定价。但国家超算互联网提供线上调用入口,Hugging Face 权重免费下载,自己有卡的话只付电费和运维。
V4-Pro-0813 和 V4.1-Flash-1017 选哪个?
高频、预算敏感选 Flash;重代码 Agent、要自托管选 Pro。拿不准就 Flash 起步,遇到瓶颈再切,协议一样,改个模型名的事。
它支持看图吗?
官方文档口径是纯文本。个别资料写了支持图像推理,两说冲突,建议以你调用时的实际返回为准。
API 模型名填什么?
DeepSeek-V4-Pro-0813。部分第三方文档提到沿用旧名 deepseek-v4-pro 也能调到正式版,这个我没验证,保险起见用带日期的新名。
涨价后还有什么省钱的用法?
谷时跑批、缓存命中、低档思考,三个叠起来。再不够就降到 Flash 系列,能力换成本,看你的任务吃不吃得消。
结语
DeepSeek-V4-Pro-0813 是一次「补课式」的正式发布:架构原地踏步,后训练把 Agent 短板补齐,开源的诚意还在,涨价也是明着涨。放到 10 月的现在看,它的处境有点微妙——官方嘴里的后辈 V4.1-Flash 已经宣布超越了它。但跑分归跑分,Pro 的 1.6T 参数量和 MIT 权重摆在那,需要上限和需要自主权的团队,短期内找不到更好的替代。普通用户和它保持距离,把预算留给 Flash,是更划算的选法。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。