
一句话总结:Google 已经把「算法名」收进核心系统不再单独命名,百度把算法写成了一份公开的违规清单,360 和搜狗基本不公开命名,Bing 只在论文里公开原理——五家的差别,一半在技术,一半在愿不愿意告诉你规则。
做 SEO 的人迟早会碰到一个问题:客户问「百度最近又出了什么算法」,你张口就是飓风、惊雷、清风,客户再问一句「这算法官方哪年发的、管什么」,很多人就答不上来了。更麻烦的是,网上流传的算法名单里混着大量自媒体编造的名字和精确到小数点的「权重占比」。
我这次把五家搜索引擎的官方文档、备案公示、公开论文全翻了一遍,能查证的标来源,查不到的直说查不到。
先看一张 Google 的谱系图,它最能说明「算法」这个概念二十多年里是怎么变的。
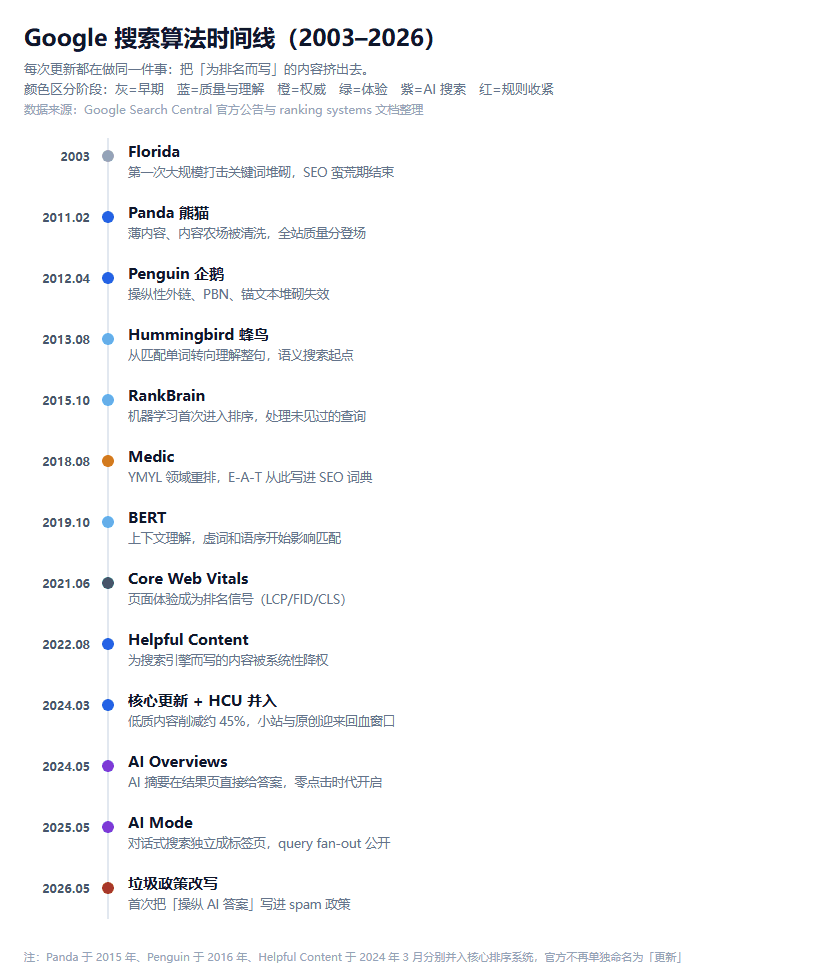
图 1:Google 从 2003 年 Florida 到 2026 年垃圾政策改写的主要节点。浅蓝是语言理解,深蓝是质量治理,紫色是 AI 搜索
先把一个坑填了:网上那些算法名,一半查不到出处
这件事必须先讲清楚,否则后面全是错的。
我拿三个例子说明。
第一个,搜狗「银河算法」「石破天惊算法」。 网上不少文章写搜狗有这两个算法,讲得有鼻子有眼。但我去翻搜狗自己的算法公示页,整页只公示了两个算法:「搜狗信息检索算法」和「腾讯内容安全算法」,前者备案编号 440305295988704230029 号,说明是「从互联网网页当中,检索召回当前用户搜索词的相关结果」。没有银河,没有石破天惊。
第二个,百度「惊雷算法 5.0」「飓风算法 4.0」。 有文章说 2025 年 Q4 上线了惊雷 5.0,还给出了 EEAT 四个维度分别占 25%、30% 的精确权重。我去查百度搜索资源平台的《百度搜索算法规范详解》,现行版本写的是惊雷算法 2.0、飓风算法 3.0。百度从来没有公布过任何排名因素的百分比权重。
第三个,360 的「奥创算法」。 有的文章叫奥创,有的叫悟空,其实是同一件事被翻译成了两个名字(Ultron / 悟空)。业内叫法本身就乱。
所以判断一个算法是真是假,标准只有三条:官方公告有没有、备案公示有没有、官方文档里还写不写。三条都不占,那多半是二手加工。
这件事背后有个更重要的结论:算法名字的公开程度,跟这家公司的治理风格直接相关,跟技术水平关系不大。 Google 早期乐意给算法起名字做 PR,现在反而在官方文档里把 Panda、PenGUIn 标成「已并入核心系统」;百度走的是行政公示路线,先公告再处罚;360 和搜狗基本不玩这套。
记住这个框架,再看五家就顺了。
Google:算法名已经「退休」,现在是系统在打分
Google 官方有一份 ranking systems guide,把还在用的系统列了一遍。有意思的是,它明确标注 Panda 在 2015 年、Penguin 在 2016 年、Helpful Content 在 2024 年 3 月分别并入了核心排序系统。
翻译成人话:这些曾经大名鼎鼎的算法,现在不再作为独立模块存在了,而是变成核心打分里的若干信号。
四层结构
理解 Google 别按算法名记,按层记。
| 层级 | 干什么 | 代表系统 |
|---|---|---|
| 抓取与索引层 | 发现、抓取、建索引 | Googlebot、Caffeine(2010,基础设施)、Mobile-First Indexing |
| 检索与排序层 | 从索引里召回候选、排序 | PageRank、RankBrain、Neural Matching(2018)、BERT(2019)、SPTAG 式向量召回 |
| 质量与反作弊层 | 判定内容质量、清理作弊 | Panda、Penguin、Helpful Content、SpamBrain(2018 起)、Reviews system |
| 结果呈现层 | 决定结果怎么排、怎么展示 | Passage Ranking、Site DiveRSIty、Deduplication、Freshness |
| AI 层(2024 后新增) | 生成摘要与答案、引用来源 | AI Overviews(2024.5)、AI Mode(2025.5)、Gemini 3(2025.11 起接入) |
六个必须记住的转折
2003 年 Florida:第一次大规模清洗关键词堆砌。此前的 SEO 就是堆词,之后不行了。
2011 年 Panda:给整个站点打质量分,不只打单个页面。这是「一个栏目烂,全站跟着掉」的源头。官方说首发影响近 12% 的英文查询。
2012 年 Penguin:打操纵性外链。买链、PBN、锚文本清一色堆同一个词,都是它的目标。首发影响约 3.1% 的英文查询。很多站当年掉下去,花了一两年才爬回来。
2013 年 Hummingbird + 2015 年 RankBrain:从「匹配词」转向「理解一句话」。RankBrain 让 Google 能处理从没见过的查询——靠向量化的语义相似度,而不是词典。
2018 年 Medic + 2019 年 BERT:Medic 让医疗、金融这类 YMYL 领域(涉及钱和健康的)被重排,E-A-T 从这时候变成行业黑话。BERT 则让「的」「for」「to」这种小词开始影响匹配结果。
2022 年 Helpful Content + 2024 年 3 月并入核心:为搜索引擎而写的内容被系统性降权。Google 当时说目标是减少 40% 的低质内容,后来官方口径是实际减少了约 45%。这个数字我倾向于认为口径偏乐观,但方向是明确的。
2024 之后,规则变了
如果只看算法名,你会漏掉这两年真正的变化。
2024 年 5 月 AI Overviews 上线,结果页顶部直接给答案。2025 年 5 月 AI Mode 独立成标签页。2025 年 11 月 18 日 Gemini 3 发布,12 月 17 日成为 AI Mode 默认模型,2026 年 1 月 27 日 AI Overviews 全面切到 Gemini 3。
Google 在 2025 年新增的官方文档里第一次公开承认了 query fan-out 这个机制:模型会把你的一句话拆成几十个子查询,分别去搜,再把结果拼成一个答案。引用谁,取决于哪个段落对得上某个子查询。
2026 年 5 月 15 日,Google 同时做了两件事:发布生成式 AI 官方指南,改写垃圾政策把「操纵 AI 答案」写进违规。官方明确点名了几种没用的做法:llms.txt 文件、专门为 AI 做的格式化、Markdown 版本页面、批量制造品牌提及。
这段话对做 SEO 的人价值很高——它等于官方承认,过去一年市面上卖得很贵的「GEO 套餐」里,有一半是无效动作。
百度:唯一把算法写成「执法条款」的一家
百度是国内唯一维护统一算法规范页的搜索引擎。这份《百度搜索算法规范详解》把现行算法按四个维度分好了组。
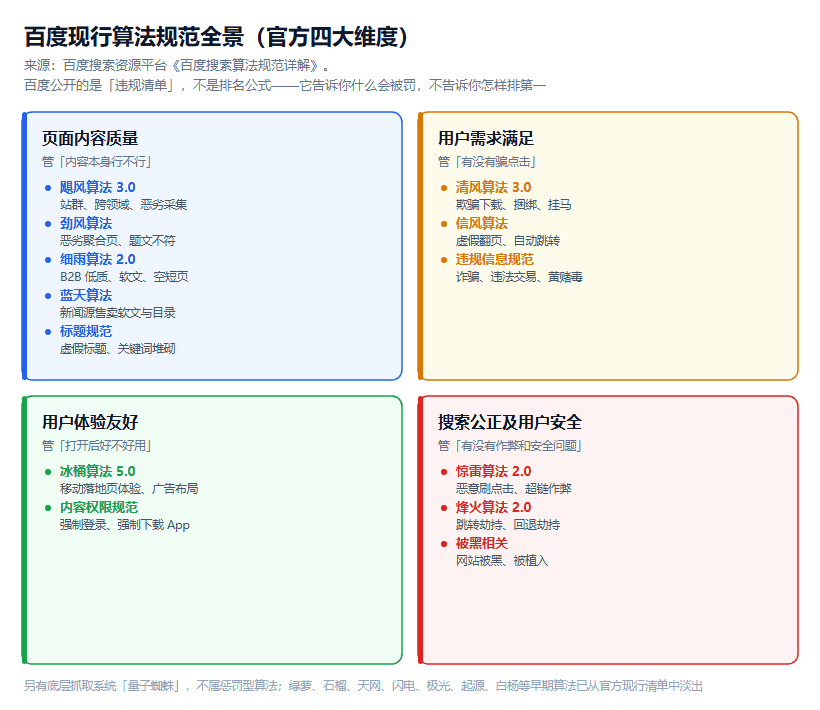
图 2:百度官方现行算法清单。注意左下和右下两个象限——它们管的是「有没有坑用户」,跟内容质量无关
现行清单
| 维度 | 算法 | 现行版本 | 管什么 |
|---|---|---|---|
| 页面内容质量 | 飓风算法 | 3.0 | 站群、跨领域内容、恶劣采集 |
| 劲风算法 | — | 恶劣聚合页、题文不符、静态搜索结果页 | |
| 细雨算法 | 2.0 | B2B 领域低质、软文、空短页 | |
| 蓝天算法 | — | 新闻源售卖软文、售卖目录 | |
| 标题规范 | — | 虚假标题、关键词堆砌 | |
| 用户需求满足 | 清风算法 | 3.0 | 欺骗下载、捆绑下载、挂马窃取隐私 |
| 信风算法 | — | 虚假翻页、自动跳转 | |
| 违规信息规范 | — | 诈骗、违法交易、黄赌毒 | |
| 用户体验友好 | 冰桶算法 | 5.0 | 移动落地页体验、广告布局、交互 |
| 内容权限规范 | — | 强制登录、强制下载 App | |
| 搜索公正及用户安全 | 惊雷算法 | 2.0 | 恶意刷点击、超链作弊 |
| 烽火算法 | 2.0 | 跳转劫持、回退劫持 | |
| 被黑相关 | — | 网站被黑、被植入 |
劲风和信风的推出年份,我查到的几种说法互相打架,就不硬写了。官方页面上它们在列,这比年份重要。
已经淡出的历史算法
这份名单更适合拿来理解百度的治理节奏。
| 算法 | 时间 | 当年打什么 | 现在 |
|---|---|---|---|
| 超链算法 | 2012 | 以被引用数量判断网站好坏,开启「外链为皇」 | 被绿萝取代 |
| 绿萝算法 | 2013.2(2.0 于 2013.7) | 买卖链接、链接中介、软文交易 | 已不在现行规范页 |
| 石榴算法 | 2013.5 | 恶劣弹窗广告、混淆主体的垃圾广告 | 并入冰桶方向 |
| 起源算法(星火计划) | 2013.10 | 原创识别,打击伪原创 | 思路并入飓风 |
| 冰桶算法 | 2014.8 首发 | 移动端强制下载 App、强制登录 | 现行 5.0 |
| 白杨算法 | 2014.12 | 本地化信息排序、扶持地方站 | 已淡出 |
| 天网算法 | 2016.8 | 网页嵌恶意代码盗取 QQ 号、手机号 | 并入烽火/安全方向 |
| 闪电算法 | 2017.10 | 移动首屏加载超 3 秒降权 | 并入冰桶体验维度 |
| 极光算法 | 2018.5 | 落地页时间因子不规范 | 已不在现行规范页 |
我个人的判断是:百度这套清单,是五家里最值得逐条对着改的。 因为它写的是「什么会被罚」,非常具体,几乎每条都能翻译成一个检查动作。Google 那边你想找对应清单,只能去翻 spam policies,颗粒度粗得多。
关于底层抓取
百度爬虫是 Baiduspider。业内还流传「量子蜘蛛」这个叫法,指其抓取调度系统,但我没在官方文档里找到对应的正式命名,姑且当绰号看。
另外「阿拉丁」「知心」这些是百度历史上有名的垂直搜索和知识图谱项目,不是惩罚型算法,别混在一起说。
360:名字最神话,官方文档最薄
360 的算法名很有意思,全是神话人物:哪吒、后羿、悟空、八戒。
问题在于,360 没有像百度那样维护一份统一的算法规范页。这些名字主要通过站长平台公告和行业整理流传,我现在能找到的多是第三方汇总,原始公告的存档已经不好找了。
| 算法 | 管什么 |
|---|---|
| ICO 算法 | Index Clear Optimize,清理索引库里的低质、重复、失效 URL,长期跑 |
| 后羿算法(1.0/2.0) | 打击采集、拼接、偷换标题、垃圾广告;保护原创 |
| 悟空算法(1.0/2.0) | 识别网站被黑、被植入,出风险提示 |
| 哪吒算法 | 打击黑帽 SEO:关键词堆砌、恶劣转载、内容与站点主题无关 |
| 八戒算法 | 控制站群、克隆站、虚假信息站 |
看下来你会发现,360 这套几乎是与百度一一对应的:后羿对飓风,哪吒对标题规范,悟空对烽火,八戒对站群治理。这不是巧合——国内搜索引擎面对的是同一批作弊手法,解法自然趋同。
真正能查到的 360 官方文本是《360搜索网页质量白皮书》,里面有比较完整的收录原则:网站要能正常打开、内容合规无挂马、不能多次跳转和大面积弹窗、要有优质原创、不能针对搜索引擎刻意优化、要有备案信息。这段话其实比算法名字有用得多。
2026 年 4 月的新变化值得单独提一句。 360 站长平台发布公告,升级网站库管理规则:未备案或备案异常的网站不予存储,历史暂存的未备案站点逐步清理,给了 30 天缓冲期,2026 年 5 月 20 日截止。
这条对做站的直接影响:以前用海外服务器、不备案也能在 360 拿到收录,现在这条路断了。
搜狗:五家里最不透明的一个
搜狗是这五家里算法信息最少的一家,而且情况正在变得更少。
官方算法公示页只列了两个算法,都是备案制要求的:搜狗信息检索算法、腾讯内容安全算法。后者其实是 OCR、ASR、NLP 的合规说明,服务的是微信、QQ、腾讯视频等内容审核,跟网页排序关系不大。
业内常说搜狗用「SogouRank」,类似 PageRank 的域名权重体系。这个说法流传很广,但我没找到搜狗官方的正式定义,按「业内说法」处理比较稳妥。
那搜狗到底看什么
从可验证的行为和官方表述倒推,能确定的有三点。
第一,微信内容是它真正的壁垒。 搜狗是少数能索引微信公众号文章的搜索引擎,这是百度做不到的。做 B2B 或者有公众号内容矩阵的,搜狗这条流量入口常常被低估。
第二,域名整体权重的影响比单页相关性大。 这是多家第三方观察一致的地方,也解释了为什么老域名在搜狗上更容易起量。
第三,对 ICP 备案的要求比百度宽松。 不过 2026 年各家都在收紧,这个差异正在缩小。
搜狗这几年的变化
2021 年 9 月,搜狗与腾讯完成合并,成为腾讯控股子公司。2022 年 8 月 8 日,搜狗搜索 App 停止服务,网页端继续运营。2026 年 2 月,搜狗搜索上线 AI 模式,由腾讯元宝提供技术支持,同时上线智能分类搜索频道。
所以现在的搜狗,本质是腾讯体系里的一个搜索入口,不是一个独立作战的搜索引擎。你做它的 SEO,思路应该偏向「腾讯的内容怎么分发」,而不是「搜狗算法怎么调」。
Bing:论文写最透,产品最不吭声
Bing 是五家里学术透明度最高的。它的核心排序算法有完整的论文脉络,可以一路追溯到 2005 年。
三代排序算法
RankNet(2005):微软研究院 Chris Burges 等人在 ICML 发表的《Learning to Rank using Gradient Descent》。核心思路是成对学习——不预测单个文档的绝对分数,而是判断「A 和 B 哪个该排前面」。用神经网络 + 概率交叉熵 + 梯度下降。这篇论文后来拿了 ICML 的 Test of Time 奖。
LambdaRank:关键洞察是训练时不需要代价本身,只需要代价对分数的梯度。
LambdaMART:LambdaRank 的提升树版本,2010 年拿下 Yahoo Learning to Rank Challenge 第一赛道冠军。这是 Bing 今天还在用的东西。
三代一脉相承,微软自己说 RankNet 谱系的算法至今仍用于 Bing 网页搜索,并且持续用新标注数据重训。
检索层:SPTAG
2019 年 5 月微软开源了 SPTAG,一个向量近似最近邻检索库,服务的就是 Bing 的语义匹配。换句话说,Bing 的召回早就不靠关键词匹配了,而是靠向量相似度在海量数据里捞候选,再交给排序层。
AI 层:Prometheus
2023 年 2 月随新 Bing 一起出现的 Prometheus,干的事是:把 Bing 的索引和 GPT 模型接起来,让模型自己发内部查询去检索,再用检索结果给自己的回答做 grounding(接地),并给出引用。中间那个调度器叫 Bing Orchestrator。
这套架构后来被 Copilot 继承。
官方六大排名因素
Bing Webmaster Guidelines 列的因素,比 Google 直白。
| 因素 | 说明 | 是否官方明确 |
|---|---|---|
| 相关性 | 内容与查询意图的匹配度,官方第一顺位 | 是 |
| 质量与可信度 | 站点声誉、作者可信度、内容完整度 | 是 |
| 用户参与度 | 点击率、停留时长、从结果页快速返回(pogo-sticking)、改写查询 | 是 |
| 新鲜度 | 内容是否更新及时 | 是 |
| 位置与语言 | 用户位置、托管位置、文档语言 | 是 |
| 页面加载时间 | 慢页面影响体验 | 是 |
| 社交信号 | 只间接影响权威度和发现,不直接加权 | 官方澄清过 |
| 精确匹配 | 关键词出现在 title、H1、Meta、首段、URL | 第三方测试结论,非官方 |
最后两行要分开看。社交信号是 Bing 比 Google 更愿意承认的间接因素,但微软也明确说过「只有社交曝光不直接影响排名」。精确匹配那条是行业测试结论,别当官方规则用。
三个实操层面的差异
IndexNow。 Bing 主导的协议,页面新增、更新、删除时主动推给搜索引擎,收录常常以分钟计。Google 不支持这个协议。对新闻站和电商库存页,这是实打实的效率差。
NOARCHIVE 会挡住 Copilot。 Bing 官方指南写明:NOARCHIVE 标签会让内容无法用于 Copilot 回答和 grounding 结果,NOCACHE 则只允许使用 URL、标题和摘要。这条很多人不知道,一不小心就把自己排除在 AI 答案之外了。
2026 年 2 月 10 日,Bing Webmaster Tools 上线 AI Performance 报告。 这是主流搜索引擎里第一个能看「我的页面被 AI 答案引用了多少次、因为哪些 grounding query 被引用」的工具。做 GEO 的人目前只有这一个可测量的官方数据源。
五家横向对比
这张表是前面所有内容的压缩版。带「经验」标注的是行业观察,不是官方口径。
| 维度 | 百度 | 360 | 搜狗 | Bing | |
|---|---|---|---|---|---|
| 算法公开程度 | 早期公开命名,现并入核心 | 最高,维护统一规范页 | 中,靠公告与白皮书 | 最低,只公示 1 个算法 | 不公开算法名,公开排名因素 |
| 排序核心 | 核心系统 + 深度语义 | 语义 + 自有内容池 + 用户行为 | 安全 + 关键词匹配 + 行为 | 域名权重 + 微信内容 | LambdaMART + 向量召回 |
| 反作弊强项 | SpamBrain、链接治理 | 惊雷、烽火、飓风 | 悟空(被黑识别) | 公开信息少 | 链接买卖、AI 操纵 |
| 新站友好度(经验) | 中 | 偏低 | 偏低 | 低 | 高,IndexNow 可分钟级收录 |
| 对 AI 内容的态度 | 不看是否 AI,看是否有用 | 禁低质采集,不因 AI 直接判罚 | 同百度 | 未明确 | 同 Google + 明确 NOARCHIVE 规则 |
| 独有流量入口 | Chrome、Android | 百家号、知道、百科 | 360 浏览器、安全卫士 | 微信、QQ、搜狗输入法 | Windows、Copilot |
| ICP 备案要求 | 无 | 强 | 2026 年起强(清退未备案) | 相对宽松 | 无 |
一眼能看出的规律:越是依赖自有内容平台的公司,越倾向于用规则清单治理;越是靠通用网页检索的公司,越倾向于用机器学习打分。 百度和 360 有浏览器、有内容平台,所以它们能"点名"处罚具体行为;Google 和 Bing 面对全球网页,只能靠模型泛化判断。
2024–2026 真正的新变量:从「排第几」到「被不被引用」
这是这两年唯一真正改变游戏规则的事,比任何一个算法更新都重要。
五家都在做同一件事:在结果页直接给答案。
- Google:AI Overviews(2024.5)、AI Mode(2025.5)、Gemini 3 接入
- 百度:AI 搜索,日均查询量已到亿级
- 360:360 智脑搜索,把大模型接进搜索入口,答案区直接放在结果页上方
- 搜狗:2026 年 2 月上线 AI 模式,腾讯元宝提供支持
- Bing:Prometheus → Copilot,2026 年 2 月给出 AI Performance 报告
三条共通的底层规则
第一,索引资格是唯一门票。 Google 官方写得很直白:AI Overviews 和 AI Mode 跟普通搜索用同一套索引、同一套排序系统,「没有额外要求」。Bing 的指南表述一样:让页面进 Bing 搜索的那套基础,同样决定它能不能成为 Copilot 的引用来源。
第二,段落比页面重要。 query fan-out 把问题拆成子查询,每个子查询找的是能独立回答的那一段。所以「一页讲透一件事」比「一页塞十个主题」更容易被引用。
第三,操纵 AI 答案已经算作弊。 Google 2026 年 5 月改写垃圾政策,明确把「通过提示词工程让模型记住某个网站」和「利用上下文学习漏洞强制输出特定内容」列为违规,处罚包括降权、移出 AI 引用、甚至从索引删除。Bing 的指南里也把 Prompt Injection 和 AI Manipulation 写进了会导致降低可见度或移除的行为。
这一点我很确定:GEO 不是什么新学科,它就是「让内容值得被引用」这件事换了个名字。 靠堆提示词、造品牌提及的路子,2026 年已经被官方堵了。
落到实操:一张自查对照表
算法名单看完就忘,是因为没跟动作挂上钩。这张表是给执行用的。
| 你要避免的事 | 谁在管 | 具体自查动作 |
|---|---|---|
| 跨领域采集、站群搬运 | 百度飓风 / 360 后羿与八戒 | 检查栏目是否都围绕站点主题;删掉与主营无关的批量内容 |
| 聚合页只有标题没有正文 | 百度劲风 | 列表页、标签页若内容为空,加 noindex |
| B2B 站标题塞关键词、冒称官网 | 百度细雨 + 标题规范 | 标题里品牌词 + 核心词各一次;没认证就别写「官网」 |
| 新闻源售卖软文、开目录 | 百度蓝天 | 关掉付费发稿入口;清理 /news/ 下的第三方投稿目录 |
| 下载站欺骗下载、捆绑安装 | 百度清风 3.0 | 下载按钮直达真实文件;不诱导装第三方客户端 |
| 翻页键跳广告、自动跳转 | 百度信风 | 翻页只翻本页内容,不跳外链 |
| 移动端首屏慢、广告遮挡 | 百度冰桶 5.0 / 闪电(历史) | 首屏 3 秒内可交互;广告不遮挡主体内容 |
| 强制登录、强制下载 App 才能看 | 百度内容权限规范 | 正文默认可见,登录只用于互动功能 |
| 刷点击、买点击 | 百度惊雷 2.0 | 停掉任何模拟搜索点击的工具,这类收益越来越低风险越来越高 |
| 网站被黑、被挂马 | 百度烽火/被黑、360 悟空 | 定期查异常目录和外链;用站长平台的安全检测 |
| 买链接、PBN、锚文本单一 | Google Penguin/SpamBrain、Bing | 导出外链,看锚文本分布是否过度集中;用 disavow 清理 |
| 为搜索引擎而写、无第一手经验 | Google Helpful Content、2026 核心更新 | 每篇加实测数据、截图、具体案例;补作者实名与背景 |
| 纯 AI 批量生成、无信息增量 | Google 规模化内容滥用、百度飓风 | 保留人工改写比例;删掉只做同义替换的页面 |
| 操纵 AI 答案、批量造品牌提及 | Google 2026 垃圾政策、Bing AI Manipulation | 停掉提示词投毒类服务;改做真实测评与可引用数据 |
| 未备案站点 | 360(2026.4 起)、百度 | 完成 ICP 备案并在站长平台提交凭证 |
五个常见问题
Q1:百度有没有「沙盒」,新站要等三个月?
官方从来没有承认过沙盒机制。新站起量慢是事实,但更可能的原因是站点权重和历史数据不足,而不是被关进某个黑箱。我倾向于把它当成经验总结,不是规则。
Q2:Google 的算法名现在还有用吗?
做技术判断有用,做服务报价没用。知道 Panda 管薄内容、Penguin 管链接,能帮你定位问题;但如果有人拿「我们专门针对熊猫算法优化」当卖点,那基本是在收智商税——这些系统早并入核心了。
Q3:360 和搜狗的算法信息这么少,怎么做优化?
回到官方文本。360 有《网页质量白皮书》,搜狗有算法公示页和微信内容收录规则。另外多看站长平台的驳回理由,那是最真实的规则说明。360 社区里站长被拒收录时,官方回复给的收录原则列表,比任何第三方整理的算法名单都准。
Q4:一家网站能不能同时适配五家?
底层能,表层不能。内容质量、技术健康、加载速度这些五家通吃;但百度要看备案和自有内容池、搜狗要看微信内容、Bing 要看社交信号和精确匹配、360 要看安全记录。共用一套内容,接口处做差异化配置,是最省力的做法。
Q5:2026 年最值得投入的一件事是什么?
让页面能被单独引用。具体做法是把每个主题写成能独立回答一个问题的段落,标题直白,第一段给结论,数据标来源。这套做法在五家都成立,因为它同时满足传统排序和 AI 引用两套逻辑。
结语
如果要给这五家下个判断:
Google 的算法体系最复杂,但规则最不透明——它只在事后告诉你「你被核心更新影响了」,不告诉你具体哪条。百度反过来,规则写得最清楚,执行也最直接,代价是自有内容占比更高。Bing 的工程链路最透明,从 RankNet 的论文能一路读到 Copilot 的实现。360 和搜狗处在中间地带,一个靠安全能力做差异化,一个靠微信内容活着。
真正该记住的不是那六十几个算法名,而是它们共同指向的一件事:所有算法都在清理「为用户之外的目的生产的内容」。 采集、堆词、刷点击、骗下载、操纵 AI 答案,本质是同一类行为的不同形态。
算法名字会继续换,这条线不会。
- 四层结构
- 六个必须记住的转折
- 2024 之后,规则变了
- 现行清单
- 已经淡出的历史算法
- 关于底层抓取
- 那搜狗到底看什么
- 搜狗这几年的变化
- 三代排序算法
- 检索层:SPTAG
- AI 层:Prometheus
- 官方六大排名因素
- 三个实操层面的差异
- 三条共通的底层规则
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。