
一句话总结:Agent 的 demo 和生产之间隔着五道坎——脏数据、长链路误差累积、工具脆弱、验收缺失、成本与权限,任何一个没解决都会让「看起来能用」变成「上线就翻车」。
今年看过太多 Agent 演示:一句话下达任务,模型自己拆步骤、调工具、改错误,一路交到成品。看完就想立刻上生产。
真上了才发现另一回事。我自己的项目里踩过完整的坑,也和几个做 Agent 产品的团队聊过,翻车的理由高度雷同。这篇把五个原因拆开讲,每个都带解法。
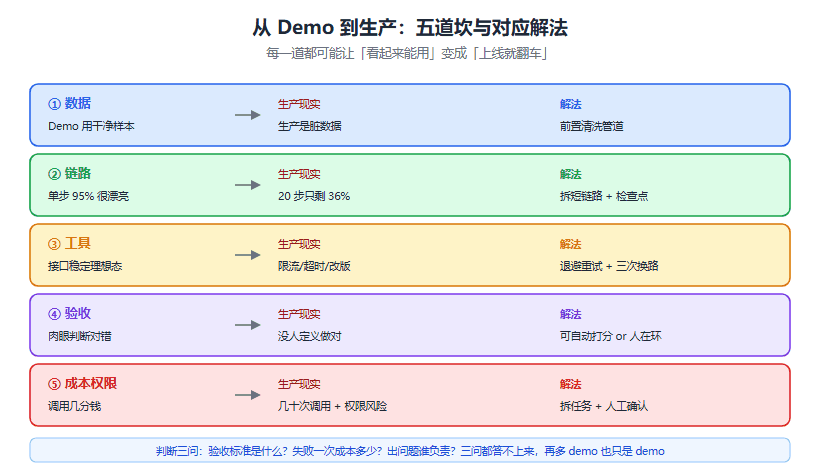
图 1:五道坎的「demo 印象 vs 生产现实」对照,右侧是各自解法
第一道坎:demo 用的是干净数据
演示时喂给 Agent 的往往是整理好的文档、格式规范的表格、结构清晰的代码库。生产环境的数据长什么样?PDF 里混着扫描件、Excel 有合并单元格、代码库有三年前的屎山。
模型不是不会处理脏数据,是处理和没处理之间差了十倍的成本。解法很土但有效:把数据清洗做成前置管道,别指望 Agent 自己在任务里顺手清理。清洗质量决定了后面所有环节的上限。
第二道坎:长链路误差累积
单步准确率 95% 听起来很好。一个任务 20 步呢?0.95 的 20 次方约等于 36%。任务越长,成功率掉得越快,而用户对 Agent 的期待是「一次成功」。
这就是为什么很多 Agent 在 3 步任务上表现惊艳,到 10 步就开始胡言乱语。对策有两个方向:一是拆短链路,把长任务切成有明确交接点的子任务,每段单独验收;二是加检查点,每几步做一次状态校验,发现偏离就回滚重来,而不是硬着头皮往下走。
第三道坎:工具是脆的
Agent 依赖的工具调用,在 demo 里都是理想状态:接口稳定、响应及时、参数永远正确。生产环境里会撞上:接口改版本、触发限流、超时、返回格式变了、权限过期。
更麻烦的是失败后的行为。我们之前写 MiMo-V2.6 时提过官方复盘的「重复调用」问题:模型遇到异常不换策略,而是反复发同样的请求直到耗尽步数。重复率从 13.45% 降到 3.83%,官方自己承认没解决。
工程上的解法是给工具层加护栏:超时重试要有退避、同类失败三次就强制换路径、关键工具失败要中止任务而不是继续瞎试。这些是工程活,不是模型能力问题。
第四道坎:没人定义「做对了」
这是最容易被忽略的一条。Demo 里「做对了」由人肉眼判断,生产环境必须自动化验收——可问题在于,很多任务的「好」根本没法自动打分。
我们在 RSI 那篇 里写过一句我很认同的话:AI 自我改进最大的瓶颈不是算力,是「谁来打分」。Agent 落地同理:没有可靠验收标准的任务,不适合交给 Agent 全自动完成。要么人留在环里做验收,要么把任务拆到能被程序验证的程度(比如「代码能编译且测试通过」)。
第五道坎:成本、延迟和权限
一条任务触发几十次模型调用、十几次工具调用,单次几分钱累积起来很可观。延迟同理:用户等 3 分钟看结果,和等 3 秒,产品体验完全不同。
比成本更硬的是权限。真让 Agent 操作生产数据库、发邮件、改线上配置?出一次事故的成本远超省下的人力。所以生产环境的 Agent 大多被关在「提议 + 人工确认」的笼子里——这不是技术不行,是风险收益比不划算。
什么样的 Agent 真的在跑
看下来能稳定跑的场景,有共同特征:
- 任务窄且有边界:客服工单分类、日志初筛、代码格式化,而不是「帮我做完这个项目」
- 验收可自动化:结果对错能程序判断,不依赖主观审美
- 失败可回滚:做错了能撤销,不是不可逆操作
- 人留在关键节点:高风险动作前必须确认
按这四条筛,能上生产的场景其实不多,但每一个都能实实在在省人力。剩下的场景等模型和工程成熟,急不来。
怎么判断一个 Agent 方案靠不靠谱
三个问题够用:你的验收标准是什么?失败一次的成本多少?出问题谁负责? 三个都答得上来,可以试;答不上来,再多 demo 也是 demo。
Agent 不是不能用,是被过度承诺了。把预期从「替代人」调成「替人干最枯燥的那一段」,成功率立刻正常。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。