
一句话总结:MiniMax 10 月 19 日发布 M3.1 Flash,428B 总参数每次只激活 23B,1M 上下文、文图视频输入,输出速度 200+ TPS、价格降到 M3 的一半,AA 智能指数 42 分,但「思考常开」和 93% 的幻觉率是两个实打实的代价。
10 月 19 日晚发布的 M3.1 Flash,其实是「转正」:之前匿名跑的 Space Bunny(太空兔)就是它的早期版本,9 月下旬上线三天就冲上 OpenRouter 和 OpenCode 的 Token 日调用量第一,累计处理了超过 200 万亿 token。匿名测出来的成绩,比发布会上的 PPT 有说服力。
这篇不讲参数罗列,讲三件事:它凭什么这么快、便宜到什么程度、以及哪里不能信。
规格与两个核心卖点
| 项目 | 规格 |
|---|---|
| 架构 | 稀疏 MoE,总参数 428B,每 token 激活约 23B |
| 上下文 | 1,000,000 tokens,无长上下文附加费 |
| 输入 | 文本、图像、视频 |
| 思考模式 | 常开,用 effort 调档(low → max,默认 max),关不掉 |
| 速度 | 日常输出 200+ TPS,P50 稳定 170+ TPS |
| 价格 | $0.15 输入 / $0.60 输出 / $0.015 缓存(每百万 token) |
| 权重 | 10 月 23 日放出,协议未公布 |
卖点一:速度。官方说线上推理比 M3 快近 3 倍,靠的是更激进的稀疏注意力。23B 的激活量摆在那儿——同代模型里这属于「轻负载」档,每 token 的算力开销只有旗舰的三分之一左右。
卖点二:价格。输入输出都砍到 M3 的一半以下,缓存读取降到 $0.015。国内口径另有人民币价:输入 1 元、输出 4 元、缓存 0.1 元每百万 token。两个口径别混着算,一个美元一个人民币,换算差了七倍。
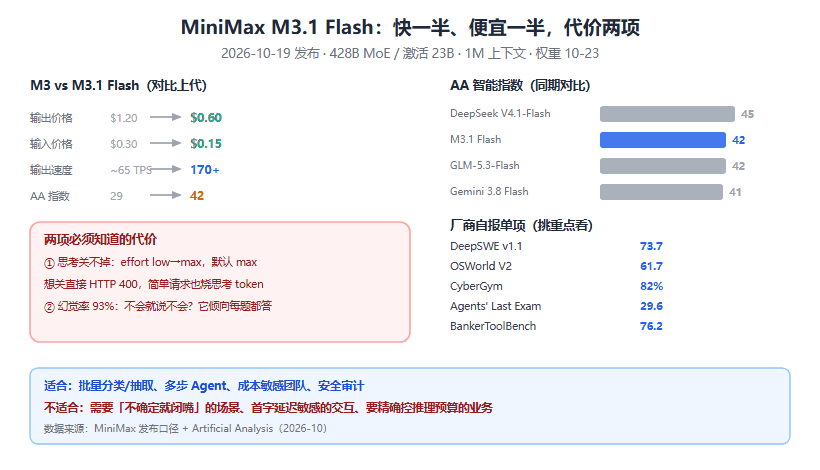
图 1:左为对比上代的四项变化,右为同期 AA 指数与厂商自报单项
榜单:Flash 档里的第一梯队
厂商自报 + Artificial Analysis 的第三方读数混着看:
- AA 智能指数 42 分,比上代 M3 高 13 分;同期 GLM-5.3-Flash 也是 42,Gemini 3.8 Flash 41,DeepSeek V4.1-Flash-1017 是 45
- HLE 48%:比 DeepSeek 和 GLM 都高
- CritPt 22%:研究级物理推理,输给 DeepSeek 的 24%,但赢 GLM 的 15%
- AA-Omniscience 事实准确率 56%:GLM 28%、DeepSeek 43%,这一项差距很大
- DeepSWE v1.1 73.7、OSWoRLd V2 61.7、Agents' Last Exam 29.6、BankerToolBench 76.2、CyberGym 82%
Agent 和编程是主战场,这组数字在「Flash 档」里确实能打。我们写过 DeepSeek V4.1-Flash,两家的分工很清楚:DeepSeek 软件工程更稳,M3.1 Flash 在跨系统业务流程和网络安全任务上更强。
两个代价:思考常开与 93% 幻觉
思考关不掉,这是设计选择不是 bug。M3.1 Flash 的 thinking 始终开启,只能调 effort 档位,从 low 到 max,默认 max。想传「关闭思考」会直接返回 HTTP 400。这意味着什么?每个简单请求都要先烧一段推理 token。官方给的解法是把 effort 调低,但调低之后那 42 分的成绩还成不成立,得自己测。
93% 的幻觉率。Artificial Analysis 的观察很直白:这个模型倾向于「对每道题都作答」,而不是在不确定时承认不知道。93% 指的是在被问及它不知道的内容时仍然编答案的比例。这不是小毛病——用在客服、法务、医疗类场景,一个不知道装知道的回答可能直接造成损失。
我的判断:这项比榜单分数更该看。42 分说明它聪明,93% 说明它不自知,两者不冲突。
谁该用,谁别用
适合:高并发的批量任务(分类、抽取、摘要)、需要多步骤工具调用的 Agent、成本敏感的团队、网络安全相关的分析与审计类工作。速度快、单价低,跑量场景优势明显。
别用:需要「不确定就闭嘴」的场景、对延迟极敏感的前台交互(思考常开会抬高首字延迟)、需要完全可控推理预算的业务(关不掉思考就没法精确控成本)。
常见问题
M3.1 Flash 和 M3 差在哪?
激活参数更小、稀疏度更高,速度快近 3 倍,价格砍半,AA 指数从 29 涨到 42。代价是思考不能关,以及幻觉率偏高。
国内价格和美元价格怎么换算?
人民币口径是输入 1 元、输出 4 元、缓存 0.1 元每百万 token;美元口径是 $0.15 / $0.60 / $0.015。按当前汇率算下来基本一致,但别拿人民币数字去跟其他家的美元价直接比。
权重什么时候放?
官方口径是 10 月 23 日,协议未公布。想自建的团队建议等协议出来再评估——MOE 大模型的自建门槛不只看参数。
能接 Claude Code 吗?
可以,API 兼容 Anthropic 和 OpenAI 两套协议,改 base_url 和模型名即可。
effort 档位怎么选?
日常任务用 low 或 medium 省钱,复杂 Agent 任务才上 max。max 是默认值,不显式降档就会一直用最贵的那档。
结语
M3.1 Flash 的位置很清晰:它是「便宜且快」的那一档,用一半的价格买到一个 42 分的模型,代价是接受它的思考开销和幻觉倾向。这不是缺点的堆叠,是产品定位的选择——Flash 就是给你跑量的,不是给你拍板用的。
想在 Agent 场景省成本,它现在是最优解之一。想拿它当唯一决策源,先把幻觉这条防线补上。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。