
一句话总结:Qwen3.8 在 8 月连发三款——2.4 万亿参数的 Max 旗舰、Apache 2.0 的 27B、以及 Qwen4 架构预览版 Flash-Next,三档从 API 到本地全覆盖,但开放权重和许可证的门槛差异比参数差异更值得研究。
阿里的节奏这两年一直很快,但 Qwen3.8 这一波还是有点特别:8 月 3 日 Max 上线,8 月 12 日放 2.4 万亿的开放权重,8 月 14 日又扔出一个 Apache 2.0 的 27B,8 月 27 日再补一个 Flash-Next 架构预览。半个月四件事,三档定位,一套比一套复杂。
很多人看到「Qwen3.8 开源了」就冲,结果下回来一个纯文本、强制思考、还带商用门槛的 2.4T 权重。这篇把三档拆开说清楚,包括那份容易被跳过的许可证。
三档定位:一个家族,三种玩法
| 型号 | 参数 | 上下文 | 定位 | 许可 |
|---|---|---|---|---|
| Qwen3.8-Max(API) | 2.4T 稀疏 MoE,激活约 95B | 1M | 旗舰、Agent 与全栈开发 | 闭源,仅 API |
| Qwen3.8-27B | 27B 稠密 | 262K→1M | 单卡/单机本地部署 | Apache 2.0 |
| Qwen3.8-Flash-Next | 125B MoE,激活 6B | 262K→1M | Qwen4 架构预览 | Qwen Community 1.0 |
| Qwen3.8-2.4T-A95B(权重) | 2.4T / 95B | 262K | 开放权重版 | Qwen3.8 自定义许可 |
关键差异就在表格末行。开放的 2.4T 不是 Max 的等价物:它是纯文本模型,且强制思考模式,没有视觉、没有非思考档。想用带视觉的 Max,只能走 API。这一点厂商在模型卡里写得清楚,但传播过程中被「2.4 万亿开源了」这句话盖过去了。
27B 反而是这批里最实在的:稠密架构、原生支持图像和视频输入、可以按请求关掉思考、单台 Mac Studio 上 68GB 内存就能跑到 64K 上下文。Apache 2.0,无门槛。
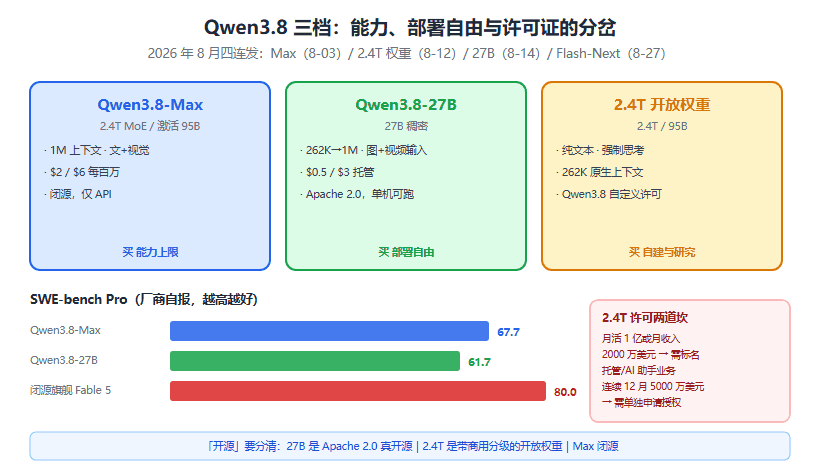
图 1:三档的核心差异在「部署自由」和「许可证」,不在参数大小
跑分:第三方和自报要分开看
厂商自报的口径(Qwen 官方表):Max 的 Terminal-Bench 2.1 是 86.6,SWE-Bench Pro 67.7,GPQA Diamond 92.6,HLE 43.6;Flash-Next 则是 CoWorkBench 73.9、GPQA-D 91.7、SWE-bench Pro 62.5、HLE 35.9。27B 的模型卡报 SWE-bench Pro 61.7、OSWoRLd 84.3——一个 27B 稠密模型在软件工程上只比 2.4 万亿旗舰低 6 分,这个性价比很扎眼。
第三方口径:Artificial Analysis 智能指数给 Qwen3.8-Max 45.4 分,在当时的国产阵营里排第二,仅次于同期的小米 MiMo-V2.6(46.3)。我们写过 MiMo 那篇,两家分数咬得很紧。
但短板也明摆着:SWE-bench Pro 67.7 对闭源旗舰 Fable 5 的 80 分,差 12 分多。Agent 和编程的「上限」上,国产旗舰还没到能说追平的程度。我自己更看重这个差距,跑分表里挑高的看很容易自我安慰,实际接一个大仓库改需求,差 12 分就是反复失败和一次通过的差别。
价格:三档差多少
API 口径(美元/百万 Token):
- Max:输入 $2.00、输出 $6.00、缓存命中 $0.25
- 27B 托管:输入 $0.50、输出 $3.00、缓存 $0.10
- 第三方平台(如 AIHubMix 折算):Max 约 $1.69 / $5.07
按单任务算更有体感:一次 3 万输入 + 2 万输出的重活,Max 约 $0.18,27B 约 $0.075。差 2.4 倍,不是数量级。所以小团队没必要为了省钱硬用 27B,除非你能本地跑,那才是真省钱。
许可证:三个门槛要看清
Qwen3.8 的 2.4T 权重用的是自定义 Qwen3.8 许可,条款里有两道坎:
- 月活超 1 亿或月收入超 2000 万美元的商业产品,必须在界面显著标注模型名称
- 做模型托管服务或 AI 办公助手业务、连续 12 个月收入超 5000 万美元的,需要单独向 Qwen 申请授权
内部部署不受限,只要模型和输出不出公司。这三条不是「开源协议」,是「开放权重 + 商用分级」,性质跟 Apache 2.0 完全不同。想拿它做产品底座的团队,法务得先看一遍。
27B 反而是干净的 Apache 2.0,商用、修改、再分发都行。这也是我给多数人的建议:先上 27B,真不够再考虑 2.4T。
三个容易踩的认知差
「开源」不等于「能商用」。前面说了,2.4T 有分级条款,27B 才是真 Apache。看到「Qwen3.8 权重已发布」先确认是哪一个。
2.4T 开放版不等于 Max。纯文本、强制思考、262K 原生上下文(要自己扩到 1M),跟 API 版的多模态、1M、可关思考完全是两个东西。
Flash-Next 不是量产型号。它是 Qwen4 架构的预览,官方措辞是 experimental preview,适合研究架构,不适合当生产模型选型。
常见问题
Qwen3.8 到底开源了什么?
两个权重:Qwen3.8-2.4T-A95B(自定义许可、纯文本、强制思考)和 Qwen3.8-27B(Apache 2.0、支持图像视频、可关思考)。Max 本身闭源。
27B 能跑在什么硬件上?
官方演示是单台 Mac Studio(68GB 内存,64K 上下文)。量化版在消费级显卡上也能跑,但要牺牲上下文或精度。
27B 和 Max 差距大吗?
厂商自报 SWE-bench Pro 差 6 分(61.7 vs 67.7),日常任务差距更小。重活和复杂推理仍推荐 Max。
要不要等 Qwen4?
Qwen4 在 9 月云栖只公布了四个型号名(Max/Flash/Plus/27B),10 月官推暗示「大小双发」,但截至现在没有权重也没有规格。等是赌,用 Qwen3.8 是确定性——我的建议是先用 27B 把流程跑通,Qwen4 出来再换,成本很低。
API 兼容什么协议?
OpenAI 和 Anthropic 两套都支持,现有客户端改个 base_url 和模型名就能切换。
结语
Qwen3.8 这三档里,真正值得马上下手的是 27B:Apache 2.0、单机可跑、能力接近旗舰的八成。Max 适合有预算、要视觉和多模态、不想自己运维的团队。2.4T 开放权重更像「给研究和大厂自建用的」,许可证门槛摆在那儿,别被「开源」两个字带偏。
阿里的产品矩阵能力是国产里最完整的,但完整也意味着选择成本。先想清楚你要的是「能力上限」还是「部署自由」,这题就有答案了。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。