
一句话总结:让模型稳定吐出能直接 json.loads 的 JSON,光靠 prompt 里写一句"请返回 JSON"不管用,得靠生成时约束、解析后修复、语义级重试三层防御;本文用 24 个按文档失败模式构造的脏样本实测,裸解析通过率 29.2%,三层全上后期望一次可用率 91.0%。
做 AI 应用第一个坎,往往不是模型聪不聪明,而是它吐出来的东西能不能直接进你的代码。我见过太多 Demo:prompt 里写着"请以 JSON 格式返回",控制台打印出来确实带大括号,json.loads 一上去就炸。要么外面包了层 markdown 代码围栏,要么结尾多一个逗号,要么先客套半页"好的,这是您要的数据:"再给正文。
结构化输出这事,社区讨论常走极端。一派说 prompt 里描述清楚就行,另一派说必须上约束解码。我的实测结论在中间:prompt 约束能对付八成情况,剩下两成靠工程兜底。但兜底的姿势很多人搞错了,拿到模型输出只会 try/except 包一层,解析失败就重试,重试再失败就报错,完全不看它到底坏在哪。
这篇把整条链路跑一遍:三种官方结构化机制怎么选、一条跨平台修复链的逐级通过率、schema 校验为什么要单独做一层、错误反馈重试的期望收益。修复链的数字全部来自本地实测,官方机制的数字标注了文档口径,两者别混读。
模型吐 JSON,到底会坏在哪
修东西之前先列故障。我按各家文档和 issue 区里出现过的失败模式,把脏输出归成两类:解析级和语义级。区别很关键,解析级是"文本不合法",语义级是"文本合法但数据不对"。
| 故障 | 长什么样 | 裸 json.loads 能过吗 |
|---|---|---|
| markdown 围栏 | 前后三个反引号把 JSON 包起来 | 不能 |
| 对话前缀 | 好的,这是结果:{...} | 不能 |
| 对话后缀 | {...} 后面跟"还需要别的吗" | 不能 |
| 尾随逗号 | {"a": 1,} | 不能 |
| 单引号 | {'a': 1} | 不能 |
| 花引号 | {"a": 1}(中文引号) | 不能 |
| 全角冒号 | {"a":1} | 不能 |
| 行内注释 | // 备注、/* 备注 */ | 不能 |
| Python 字面量 | True、None | 不能 |
| 串内裸控制符 | 字符串里出现真换行 | 不能 |
| 输出截断 | {"a": 1, "b": [ 戛然而止 | 不能 |
| 缺必填键 | 少了 schema 要求的字段 | 能过,业务挂 |
| 类型错误 | {"age": "30"} 字符串冒充整数 | 能过,业务挂 |
| 额外键 | 多返回一个没申请的字段 | 能过,strict 模式挂 |
| 根节点错误 | 该返回对象给了数组 | 能过,schema 挂 |
前十一类靠 try/except 能发现,后四类 try/except 完全放行,错误数据静悄悄流进你的数据库。这就是为什么光会 catch 异常不够,校验必须单独做,后面会拿实测数字说话。
三种官方机制:把 schema 焊进解码过程
修复是事后补救,官方机制是事前预防。思路是在解码时用有限状态机约束 Token 采样,让模型在结构上就不可能吐出非法 JSON,一条路走到黑。
| 平台 | 用法 | 约束手段 | 官方口径合规率 | 主要限制 |
|---|---|---|---|---|
| OpenAI | response_format.type = "json_schema" + strict: true | 约束解码 | ≈99.9% | 全字段必须 required、每个对象显式 additionalProperties: false、不支持 $ref、嵌套最多 5 层 |
| Anthropic | 定义单个工具 + input_schema + 强制 tool_choice | 工具调用即结构化 | ≈99.8% | 没有 strict 开关,得用工具模式绕 |
| Gemini | response_mime_type + response_schema | 约束解码 | ≈99.7% | 不支持递归 schema,enum 过多会被拒 |
| 纯 prompt | 在提示词里描述 schema | 无 | 85~92%(第三方汇总) | 全看模型心情 |
OpenAI 那串限制值得展开说。想让 strict 真正生效,schema 得这么写:每个对象所有字段进 required,每个对象挂 additionalProperties: false,描述尽量写进字段的 description 里帮模型理解。官方口径里这套写法的合规率接近满格,但要说清楚:这是文档数字,不是我的实测,我这次没接付费 API 跑这个对比,复现前以你账号的实际表现为准。Anthropic 那边没有对标能力,社区惯用法是把 schema 包成唯一一个工具、强制模型选它,曲线救国,效果也不差。
需要泼盆冷水:这几个数字是各家文档口径,第三方复测有出入,而且平台更新很快。我记录这些限制的时间是 2026 年 10 月,你写代码前以当前文档为准,别直接把本文的清单当圣旨。
我的实测:24 个脏样本过一遍修复链
官方机制虽好,有三个躲不开的场景:你在调不支持约束解码的模型、你要同时接三四家 API 不想写四套适配、或者你的 schema 本身就写错了导致约束解码约束出一个错误结构。所以修复链该写还是得写,关键是写对。
我构造了 24 个脏样本,照着上面那张故障表往脏了造,覆盖围栏、前后缀、尾逗号、单/花引号、注释、全角冒号、Python 常量、串内裸换行、截断、缺键、类型错、schema 不匹配。然后写了一条修复链,每一步做完立刻试 json.loads,过了就短路返回,不过才继续救。这个"先试原样、坏了再救"的顺序很重要,原因下一节说。
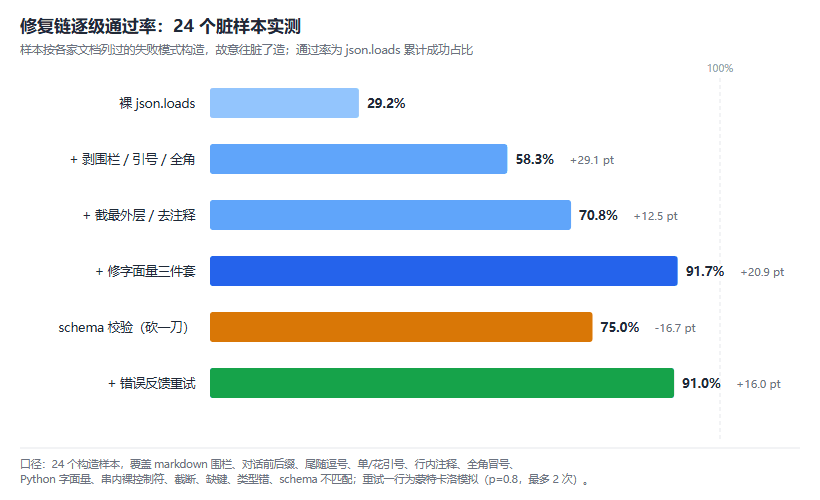
图 1:24 个脏样本实测,修复链逐级累计通过率。注意末尾两根柱子:schema 校验砍一刀,反馈重试补回来。
| 阶段 | 累计通过率 | 本级新救回 |
|---|---|---|
裸 json.loads | 7/24(29.2%) | — |
| + 去 BOM/首尾空白 | 7/24 | 无 |
| + 剥 markdown 围栏 | 11/24(45.8%) | 3 个围栏样本 + 1 个 BOM 混围栏 |
| + 花引号规范化 | 12/24(50.0%) | 花引号定界位 |
| + 全角冒号转半角 | 13/24(54.2%) | 全角冒号 |
| + 单引号转双引号 | 14/24(58.3%) | 单引号 |
| + 截最外层 + 去注释 | 17/24(70.8%) | 对话前缀、后缀、行内注释 |
| + 修尾随逗号 | 19/24(79.2%) | 对象尾逗号、数组尾逗号 |
| + Python 字面量替换 | 21/24(87.5%) | True/None,外加一个五毒俱全的混合样本 |
| + 串内控制符转义 | 22/24(91.7%) | 字符串里的真换行 |
| schema 校验 | 18/24(75.0%) | 砍掉 4 个语义错误 |
| + 错误反馈重试 | 21.84/24(91.0%,期望) | 蒙特卡洛模拟,假设见下文 |
三个数字要对着读。裸解析 29.2% 说明"直接 loads"在脏样本面前基本裸奔,但这 24 个样本是照故障表故意造脏的,比真实场景的平均水平差得多,别拿它当线上概率。修复链把解析级错误全救回来了,22/24 能 loads,剩下的 2 个是截断,这条链救不了,原因第四节讲。最值得看的是校验那一行:通过率不升反降,从 91.7% 掉到 75.0%,因为 4 个语义错误混在"能 loads"的队伍里。这四个样本分别是:缺 age 的;age 长成字符串 "30" 的;name 是 null 的;根节点给了数组的。json.loads 对它们一律放行。
我认为修复链最大的价值不是这几个百分点的通过率,是它跨平台、零依赖,一段代码同时兜 OpenAI、Claude、Gemini 和任何 OpenAI 兼容端点。官方 strict 模式很香,但你锁不锁平台是另一个决策。
修复链每一步的代码和坑
核心是一个字符串状态感知的扫描器:从第一个 { 或 [ 开始做括号配对,途中识别字符串字面量,字符串里的括号、//、注释符全部不当真,截到最外层配平为止。对话前缀、后缀、围栏,一步全清。
def extract_outermost(s):
    """从第一个 { 或 [ 开始做括号配对,截出最外层完整 JSON。
    扫描器感知字符串与注释:字符串里的 // 和括号不动,注释整体跳过。"""
    start = -1
    for i, ch in enumerate(s):
        if ch in "{[":
            start = i
            break
    if start < 0:
        return None
    open_ch, close_ch = s[start], ("}" if s[start] == "{" else "]")
    depth, in_str, esc, out, i, n = 0, False, False, [], start, len(s)
    while i < n:
        ch = s[i]
        if in_str:  # 字符串里的一切都是字符,包括括号和注释符
            out.append(ch)
            if esc:
                esc = False
            elif ch == "\\":
                esc = True
            elif ch == '"':
                in_str = False
        elif ch == '"':
            in_str = True
            out.append(ch)
        elif ch == "/" and i + 1 < n and s[i + 1] == "/":  # 行注释:跳到行尾
            j = s.find("\n", i)
            i = n if j < 0 else j
        elif ch == "/" and i + 1 < n and s[i + 1] == "*":  # 块注释:跳到 */ 之后
            j = s.find("*/", i + 2)
            i = n if j < 0 else j + 2
        elif ch == open_ch:
            depth += 1
            out.append(ch)
        elif ch == close_ch:
            depth -= 1
            out.append(ch)
            if depth == 0:
                return "".join(out)
        else:
            out.append(ch)
        i += 1
    return None  # 括号没配平:输出被截断
第一个坑就在这里。很多人图省事用正则删注释:
# 错误示范:正则一把梭,URL 当场腰斩
s = re.sub(r"//.*", "", s)
# "url": "https://api.example.com/v1" 会变成 "url": "https:扫描器按字符串状态走,https:// 躺在引号里,// 根本不在代码段,伤不到。这不是我臆想的坑,是实测样本里专门埋的一个 case。
第二个坑是单引号转换。模型吐 {'name': 'Alice'} 很常见,但值里带撇号时 {'name': "Alice's"} 这种混合写法,无脑替换会把引号配对全打乱。我的做法是全文没有双引号时才整体转换,保守但稳:
def fix_singlequotes(s):
    if '"' in s:      # 有双引号说明是混合写法,不碰,交给重试
        return s
return re.sub(r"'([^']*)'", r'"\1"', s)第三个坑是字面量修复别碰字符串内容。{"note": "True story"} 里的 True 是单词不是布尔值,一刀切替换会改坏数据。按正则切出字符串段,只改代码段:
def fix_literals(s):
    parts = re.split(r'("(?:[^"\\]|\\.)*")', s)  # 奇数下标是字符串
    for i in range(0, len(parts), 2):
        parts[i] = re.sub(r"\bTrue\b", "true", parts[i])
        parts[i] = re.sub(r"\bNone\b", "null", parts[i])
    return "".join(parts)
花引号、全角冒号同样按这个套路处理。中文模型吐 {"name":"Alice", "age":30} 的概率不低,全角冒号转半角也走掩码,值里的"时间:12:00"不受影响。
还有个设计决定值得单独讲:整条链每一步之后都立刻试 json.loads,成功就短路。这样"本来合法、只是长得怪"的输出永远不会被后续步骤改坏。修复链是救护车,不是整形医院。
解析成功不等于数据能用
跑完修复链,22/24 能 loads。然后我在外面套了一层 schema 校验,校验 required 字段和递归类型。通过率当场从 91.7% 掉到 75.0%。砍掉的四个样本有个共同点:json.loads 一律放行。缺 age 的能过,age 长成字符串 "30" 的能过,name 是 null 的能过,根节点给了数组的也能过。你要是只做到 loads 这一层,这些错误数据此刻已经流进业务代码了。
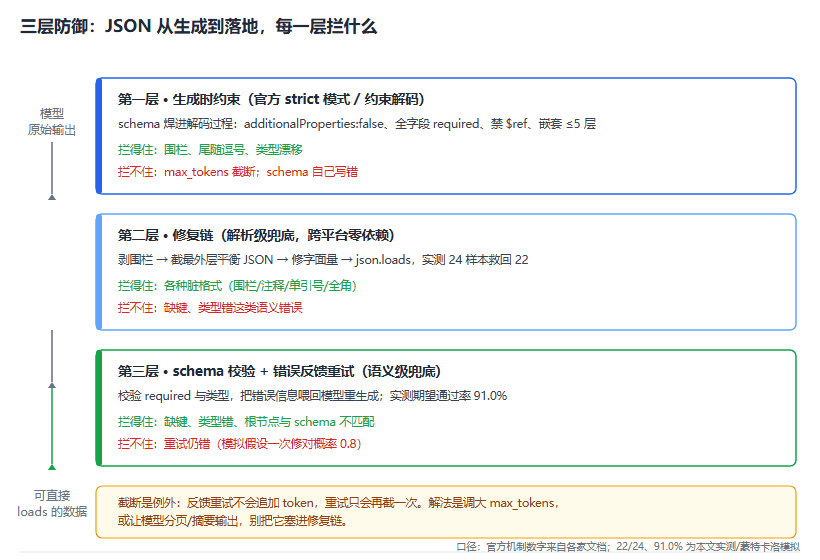
图 3:三层防御各拦什么。第一层在生成时就把结构焊死;解析级的脏数据交给第二层;语义级错误只有第三层能管。截断是链外问题。
校验失败之后的正确动作不是自己瞎猜补默认值,是把错误信息喂回模型重生成:
errs = validate(obj, schema)   # ["缺必填键 age", "age: 期望 integer,实得 str"]
if errs:
    feedback = ("你上次返回的 JSON 没过校验:" + ";".join(errs)
                + "。请只返回修正后的 JSON,不要任何解释。")
    resp = call_llm(feedback)  # 带上下文重试,最多 2 次
这个循环的期望收益我做了蒙特卡洛模拟:假设一次反馈修对的概率是 0.8,最多重试 2 次,单例修好概率 1-(0.2)²=0.96,四个语义错误全修好的概率 85%,整体期望通过率 91.0%。说清楚,0.8 这个数是我拍的,没有实测依据,真实数字取决于模型和错误类型,你得拿自己的场景测。类型错误和缺键这类反馈通常一轮就修好,schema 自己不靠谱时模型会反复在错误结构里打转。
截断是唯一的链外问题。反馈重试不会给模型追加 token,同样的 max_tokens 只会得到同样的截断。解法是调大 max_tokens,或者让模型分页输出、先给摘要再给明细。把截断塞进修复链是常见误区,我在样本里埋了两个截断 case,链一步都救不回来,最终靠改参数解决。
合规率账本:三条路线怎么选
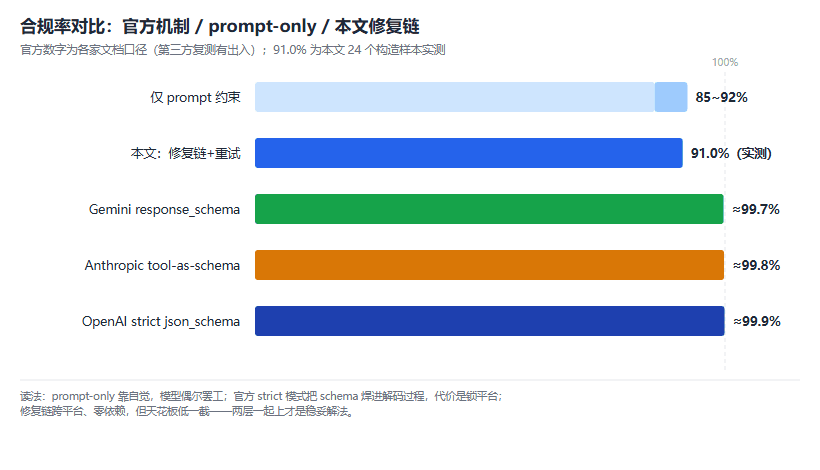
图 2:官方机制、prompt-only 与本文修复链的合规率对比。官方数字为各家文档口径,91.0% 为本文实测/模拟。
路线就三条,按场景选:
- 纯 prompt 约束:第三方汇总口径 85~92%。说实话这个数字我不敢直接上生产,夜里跑批,5000 条里挂 300 条是什么后果可想而知。适合一次性脚本、人工复核的场景。
- 官方 strict 模式:≈99.7~99.9%,生成时就焊死。适合主力链路,代价是锁平台,换模型要改适配层,schema 还得按那堆限制写。
- 修复链 + 反馈重试:实测期望 91.0%,跨平台零依赖。适合多模型混合、老模型、本地部署,以及给官方机制当第二道保险。
我个人的组合建议:主力模型走官方 strict 模式拿 99.9%,外面套修复链兜住换模型、改 schema、平台抖动的情况,再套一层 schema 校验和反馈重试管语义错误。三层不是堆砌,每层拦的东西不一样,少一层就有一类错误裸奔。纯粹为了"不用官方功能"而手写全套,我不推荐,那是跟自己过不去。
现成工具:instructor、outlines、llGUIdance
不想手写的话,工具链里有现成轮子。调 API 场景用 instructor:Pydantic 模型直接当 schema,自动重试、自动把错误喂回去,OpenAI、Anthropic、Gemini 都包了一层,心智负担最低。本地部署场景用约束解码库,outlines 和 llguidance 都能把正则或 JSON schema 编译成采样掩码,vLLM 圈子常用 xgrammar 做这事。
选型逻辑一句话:有官方 strict 就用官方的,要跨平台或接老模型用 instructor,模型完全自主可控再上 outlines。手写修复链的价值在透明,出问题你能定位到是哪一步救的、哪一步救不了,库的黑盒在报错时可读性差一截。
优势与短板
这套三层防御的真实短板,摆在这里:
- 修复链有天花板。我测出来解析级能全救,但混合引号加撇号、注释里带引号这类刁钻组合,链会失灵,只能靠重试。
- 重试收益是假设值。91.0% 里带模拟成分,别当承诺。
- schema 写错时三层全白给。约束解码只会忠实地约束出一个错误结构,修复链和校验也发现不了"需求理解错了"这类问题。
- 官方限制清单变得快。本文记录的 OpenAI strict 限制以我查询时的文档为准,可能已经更新。
FAQ
用了 OpenAI strict 模式还要写修复链吗?
要。strict 管格式,管不了 max_tokens 截断,管不了你 schema 自己写错,更管不了你哪天接了家不支持的厂商。修复链几十行,跨平台复用,成本极低。
修复链会把本来合法的 JSON 改坏吗?
设计得当就不会。每步修复前先试 json.loads,能过就短路返回,修复只对解析失败的文本生效。这是"先试原样、坏了再救"的顺序,反过来写就会误伤。
instructor 和手写修复链怎么选?
调多家 API、想少写代码,用 instructor。要接本地模型、或者业务对 JSON 结构有古怪要求,手写链更透明。两者不冲突,可以 instructor 在外、修复链在内。
模型返回被截断,重试能解决吗?
不能,反馈重试不追加 token,同样的参数只会得到同样的截断。调大 max_tokens,或者改造输出结构:分页、先摘要后明细、把大数组拆成多次调用。
怎么评测自己系统的 JSON 一次可用率?
攒 100 到 200 条真实模型输出,人工标一遍"能不能直接用",算一次可用率当基线。别用干净样本自嗨,我这次故意造脏的样本通过率 29.2%,跟真实场景的 85%+ 完全两个世界,样本构成直接决定数字。
结语
结构化输出没有银弹。这四样东西分工不同:prompt 约束全凭模型自律,strict 模式从生成端焊死结构,修复链专门救解析级的脏数据,反馈重试负责收拾语义错误。我的判断很直接:生产环境上官方 strict 加修复链加 schema 校验,截断单独用参数解决,别信任何单层方案。这套东西写一次能用很久,下一篇讲 Function Calling,模型能稳定吐 JSON 之后,就该让它调你的接口了。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。