
一句话总结:本地跑模型的门槛不在技术,在一笔账:7B 模型 Q4 量化后要 4.7GB 显存,RTX 2060 这类 6GB 卡刚好卡在门口;我用这台机器实测了 Ollama 从安装到出字的全流程,也把「什么时候该换 vLLM」的账算清楚了。
前八篇都在调 API,模型在别人机房。这篇把模型搬回自己机器。理由通常有三个:数据不想出门、用量大了想省 Token 费、或者就是要离线能用。本地跑早就不是极客玩具了。Ollama 的 GitHub star 过了 18 万,2026 年一季度下载量 5200 万次,主流开源模型发布当天就能 ollama run 拉起来。
但本地部署的第一个坑不是装不上,是显存算不平。这篇的顺序是:先算账,再装机,然后测速,最后讲什么时候该把 Ollama 换成 vLLM。
先算账:一块 6GB 的卡能装下什么
本地部署的所有决策都从一道乘法开始:模型参数量 × 每参数字节数。Q4 量化大概是 0.6-0.65 字节/参数,7B 模型就是 4.2-4.6GB,我查了 Ollama registry 的 manifest,qwen2.5:7b 默认量化的模型层是 4.68GB,对得上。这还没完。KV 缓存要占 1-2GB,CUDA 上下文再吃几百兆,所以「模型放得下」和「跑得起来」之间还隔着一笔余量。
| 模型(Q4) | 显存需求 | 能跑的最低常见卡 |
|---|---|---|
| 1.5B | ~1.1 GB | 4GB 亮机卡 |
| 3B | ~2.0 GB | 4GB |
| 7B(qwen2.5) | 4.68 GB(实测) | 6GB 起步,紧张 |
| 8B(llama3.1) | ~4.9 GB | 6GB 起步,紧张 |
| 14B | ~8.9 GB | 12GB(3060 12G) |
| 32B | ~19.5 GB | 24GB(3090/4090) |
| 70B | ~40 GB | 48GB(A6000 或双卡) |
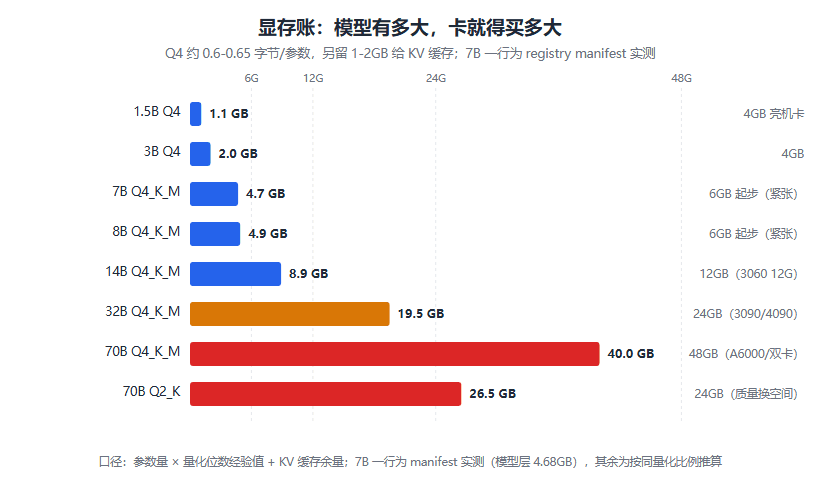
图 1:参数量乘量化位数就是底账,7B 是 6GB 卡的分水岭,再往上一个台阶就要换 12GB 卡。
我手上这台是 RTX 2060 6GB,正好压在 7B 的门槛上。这篇文章的所有本地实测都在这台机器上跑,结论对「手里有一张老卡」的人最有参考价值:能跑什么、跑多快、什么时候该放弃,全是真实数字。
装机实测:Ollama 从零到第一次出字
Ollama 的安装没啥可讲的,Windows 下是个安装包,装完 ollama run qwen2.5:7b 一条命令拉模型加起服务。我记录了几个关键数字:模型层 4.68GB,本机直连 registry 单流实测 685KB/s,从零拉要约两个小时(本文图省事用 8 连接并行预置权重,ollama pull 1.9 秒就完成了,只写了 manifest);模型落地 4.36GiB;第一次加载 6.2 秒,含预填充的首请求总耗时 11.5 秒。加载完之后 nvidia-smi 看显存占用 4530MiB,6GB 的卡用掉 74%,剩下的连个浏览器标签页都紧张,属于「能跑,别想同时干别的」。
然后测速度。用 /api/generate 发一个固定 prompt,让它生成 300 个 token,计时:
| 指标 | GPU(RTX 2060 6G) | 纯 CPU(同一台机器) |
|---|---|---|
| 首 token 延迟 | 2.1 秒 | 11.9 秒(含 7.8 秒模型重加载) |
| 生成速度 | 26.3 tok/s | 4.7 tok/s |
| 显存/内存占用 | 显存 4530/6144 MiB | 内存约 4.7GB(mmap 映射权重,进程 WorkingSet 只显示 89MB) |
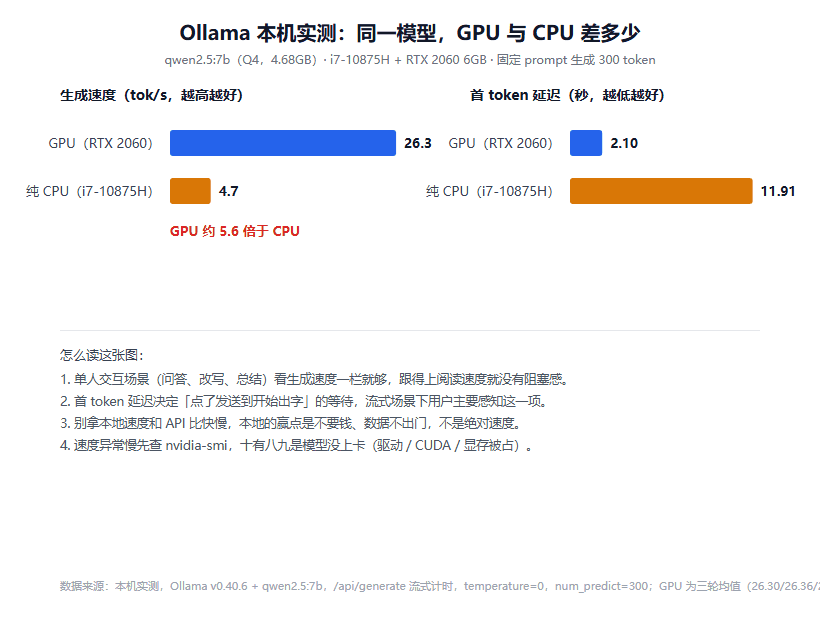
图 2:同一台机器,同一模型,GPU 快 5.6 倍,这就是为什么本地部署第一件事是确认显卡在干活。
我的解读分两层。第一,这个速度单人用完全够:26.3 tok/s 意味着阅读速度跟得上,做问答、改写、总结这类交互场景没有阻塞感。第二,别拿它跟 API 比。API 背后是数据中心级 GPU,单请求速度通常更快,本地赢在不要钱和不出门,不在快。
有个细节值得单独说,因为它就发生在本文写作的这台机器上。第一轮测试时生成速度只有 9 tok/s 上下,我第一反应是 2060 老了。查了 ollama serve 的日志才发现真问题:驱动版本 512.89,nvidia-smi 里写着 CUDA VeRSIon: 11.6,而 Ollama 0.40.6 捆绑的是 CUDA 12 和 13 两套运行时。CUDA 初始化直接失败,日志里 cuda_v12 和 cuda_v13 两条设备枚举都是空的,最后静默回退到 Vulkan 后端。Vulkan 能用,但比 CUDA 慢一截。那 9 tok/s 里也有升频的功劳:显卡刚从 1019MHz 的怠速往上爬,短生成把爬升过程平均进去了;预热之后三轮稳定在 26.30/26.36/26.15 tok/s,此时时钟 1679-1903MHz、功耗 43-93W,显卡确实在干活。更新驱动走 CUDA 这条路我没在这台机器上验证,不敢把话说死,但方向没错:速度异常慢的时候,先 nvidia-smi 看驱动支持到哪个 CUDA 版本,再看 ollama 日志选的是哪个后端,比盲目换模型管用。
接现有代码:改一行 base_uRL
本地服务对开发者最友好的一点是 API 兼容。Ollama 在 11434 端口同时提供自己的 /api/* 和 OpenAI 兼容的 /v1/*。前面几篇文章里所有调 OpenAI 的代码,把 base_url 改成 http://localhost:11434/v1 就能跑,SDK 都不用换:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
resp = client.chat.completions.create(
    model="qwen2.5:7b",
    messages=[{"role": "user", "content": "用三句话讲清 KV 缓存"}],
)
print(resp.choices[0].message.content)我把前几篇的三个场景在本地跑了一遍,结论如下。结构化输出:format 参数传 JSON schema,让它把「五一去成都玩三天」整理成 JSON,一次返回,json.loads 直接过:{"city": "成都", "days": 3, "reason": "游玩和体验当地文化与美食"}。工具调用这里有个坑:qwen2.5:7b 在 OpenAI 兼容的 /v1/chat/completions 上传 tools,正常返回结构化调用(get_weather,参数 {"city": "北京"});但在原生 /api/generate 上传 tools,两次都没拿到结构化 tool_calls,一次返回空 message,一次把 get_weather("北京") 这段调用语法直接写进了正文。本地模型的能力边界跟调用姿势有关,这点跟闭源 API 的成熟度差距明显,不是换个 prompt 就能补平的。我的建议是本地场景把 prompt 写得更死、schema 定得更严,用确定性换稳定性。
什么时候必须换 vLLM
Ollama 的定位是个人和开发场景,一旦要服务多个用户,就该换引擎了。这个结论有硬数据:Red Hat 2026 年在同一块 T4 上用 Qwen2.5-7B 做基准,128 并发时 vLLM 聚合吞吐约 793 tok/s,Ollama 约 41 tok/s,差 19 倍;但 1 并发时两者几乎持平(约 200 对 170)。H100 上同样的模式差距是 8-9 倍。
差距来自两个机制。PagedAttention(arXiv 2309.06180,SOSP 2023)把 KV 缓存按固定块分页管理,像操作系统管虚拟内存,按需分配、用完归还,还能让相同前缀的请求共享物理页。连续批处理则让新请求在 token 级别插进正在运行的批次,不用等整批跑完。Ollama 底层 llama.cpp 是顺序队列,没有页级 KV 管理,也没有中途插批,所以它的吞吐曲线是一条平线,vLLM 的是上升斜率。
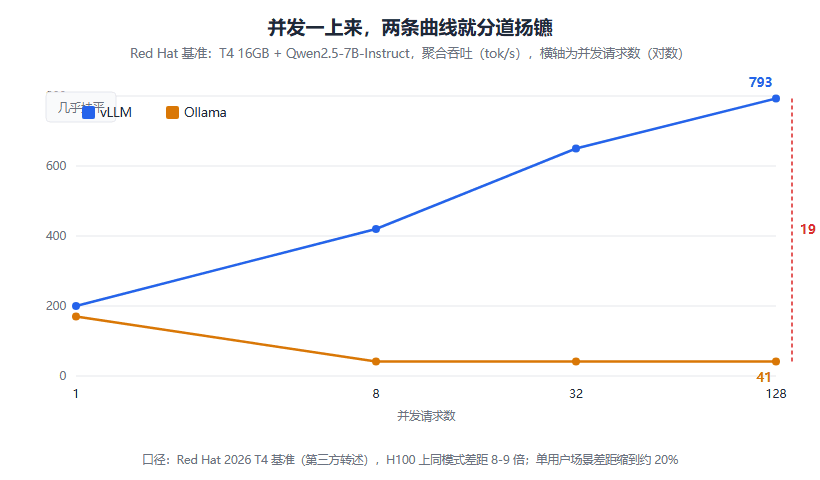
图 3:单用户时两者打平,并发一上来就分道扬镳。切换信号不是「够不够快」,是「同时有几个人用」。
具体的切换信号,我按优先级排:稳定超过 4-8 个并发请求;Agent 集群反复锤同一个模型;批处理任务(评测、批量摘要)要压满 GPU;需要 70B 以上模型的多卡张量并行。反过来,个人使用、开发调试、CPU/Mac 环境、边缘部署,vLLM 的复杂度买不到任何东西。最常见的形态是混合:开发用 Ollama,生产用 vLLM,两边都是 OpenAI 兼容 API,迁移就是改 base_url。
部署决策:本地、云端还是混合
| 场景 | 推荐 | 理由 |
|---|---|---|
| 数据不能出门(医疗、财务、未公开代码) | 本地 Ollama | 隐私是硬约束,速度成本都得靠边 |
| 个人助手、学习实验 | 本地 Ollama | 零边际成本,7B 质量够用 |
| 内部小工具(<5 人) | 本地 Ollama | 并发压力不存在 |
| 面向用户的产品 | 云端 API | 峰值流量、多模型、稳定性 |
| 高并发自有服务 | 自建 vLLM | 量大后自建比 API 便宜,但要养 GPU |
| 混合 | Ollama 开发 + API 生产 | 同一套代码两套后端 |
我的看法:多数人真实需要的是「Ollama 加一个云端 API 兜底」。本地跑 7B 处理日常和敏感请求,搞不定的走 API。别一上来就规划自建 GPU 集群,那是模型量真的起来之后才算得清的账。
FAQ
6GB 显卡现在还能干什么?
7B Q4 模型能跑,速度 26.3 tok/s 上下(本文实测,Vulkan 后端下)。聊天、总结、改写、RAG 问答都够。14B 以上不用想,显存就不够。如果只有 6GB 又想跑大模型,看看 Q2 量化或者 MoE 架构的模型,后者激活参数少,70B MoE 在 24GB 卡上也有得玩。
Ollama 和 llama.cpp 什么关系?
Ollama 是套壳,llama.cpp 是引擎。Ollama 负责模型管理(拉取、量化、版本)、服务封装和 API 兼容,推理本身是 llama.cpp。所以 Ollama 的性能天花板基本等于 llama.cpp 的天花板,想更深度的控制(自定义采样、底层参数)可以直接用 llama.cpp,代价是自己搭服务。
本地模型做 RAG 效果会不会差一截?
检索那部分不受影响,该用向量库还用向量库。差距在生成:7B 模型的指令遵循和长上下文稳定性弱于旗舰 API,我的经验是 prompt 要写得更短更死,上下文控制在 4K 以内,检索精度要求更高,因为模型对噪声的容忍度更低,错一条证据它就敢编。
vLLM 能在 Windows 上跑吗?
能,但别扭。vLLM 的主战场是 Linux 加 NVIDIA,Windows 上要 WSL2 或者接受部分功能缺失。如果团队是 Windows 开发机,现实路径是开发用 Ollama,测试和生产环境上 Linux 跑 vLLM。别在 Windows 上硬刚 vLLM,时间成本不值。
本地部署最大的隐藏成本是什么?
电费和你的时间。一张 2060 满载约 120W,跑一个月电费几十块,比 API 便宜,但硬件折旧和折腾时间经常被忘掉。我的算法很简单:月 token 量乘 API 单价,超过本地硬件折旧加电费,再考虑自建,否则云 API。
结语
本地跑模型在 2026 年已经是个工程选择,不是信仰问题。算清三笔账就行:显存账决定能跑多大的模型,速度账决定能干什么活,并发账决定用 Ollama 还是 vLLM。我在这台 6GB 老卡上得到的答案很朴素:7B 够日常,14B 要换卡,多用户要换引擎。还有一条差点忘了:跑不动先查驱动和后端日志,别急着判硬件死刑。
下一篇收尾这个系列:把这些东西组合成一个真正上线的应用:部署形态、成本核算、监控告警,一篇讲完从原型到生产的最后一公里。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。