
一句话总结:Function Calling 的难点不是让模型吐出一次调用,而是让它调对。两套 schema 实测 20 个查询差出 11 个,三道校验闸全部放行的调用里,仍有 16.5% 是选错了工具。
上一篇讲结构化输出,模型能稳定吐 JSON 之后,下一步自然就是让它调你的接口:查库存、下单、发消息、读数据库。这套机制各家叫法不一样,OpenAI 叫 function calling,Anthropic 叫 tool use,Gemini 也叫 function calling,底层是同一回事:把工具定义塞进请求,模型返回一个结构化的调用意图,执行不执行由你的代码决定。
麻烦也从这里开始。「返回了调用」和「调对了」是两件事。我这次做了三组本地实验,加一轮文献梳理,结论有点不客气:工具定义写得含糊,20 个查询只对 5 个;而哪怕三道校验闸全部放行,仍有 16.5% 的调用属于执行成功、但压根不该调。这篇文章把这些数字和对应打法摊开讲。
失败的五种样子,参数问题占六成
先看别人踩过的坑。工程社区和 BFCL(Berkeley Function-Calling Leaderboard)相关讨论里有一个流传较广的汇总口径,Function Calling 失败大致分五类:
| 失败类型 | 占比(第三方汇总) | 典型样子 |
|---|---|---|
| 参数不匹配 | ~38% | 要 order_id,它给 order_no |
| 类型强转出错 | ~24% | 字符串 "3" 传给 int 参数 |
| 选错工具 | ~18% | 该查物流,它去搜索订单 |
| 缺必填参数 | ~12% | date_range 整个不出现 |
| 幻觉工具名 | ~5% | 调用一个根本不存在的 get_order_v2 |
这是第三方汇总口径,不是我的实测。我的实测在后面几节,测的是另外几件事:schema 怎么写、工具挂多少、并发怎么发、防护闸拦得住哪一层。
BFCL v4(2026 年 4 月快照)里 Claude Opus 4.5 的 FC 配置总成绩 77.47%,拆开看结构更有意思:单轮 AST 88.58%,多轮 68.38%,记忆 73.76%。单轮已经接近解决,多轮和记忆是失分点。多轮掉二十个百分点,原因不复杂:每一轮的返回值都要进上下文,前面任何一次选错都会污染后面的决策,错误会复利。
这也是社区常引的一组数字:单次调用成功率 90%,三轮之后剩 73%,五轮 59%,十轮只剩 35%。做单轮工具 demo 和做能跑十轮的 Agent,中间隔着一条复利曲线。
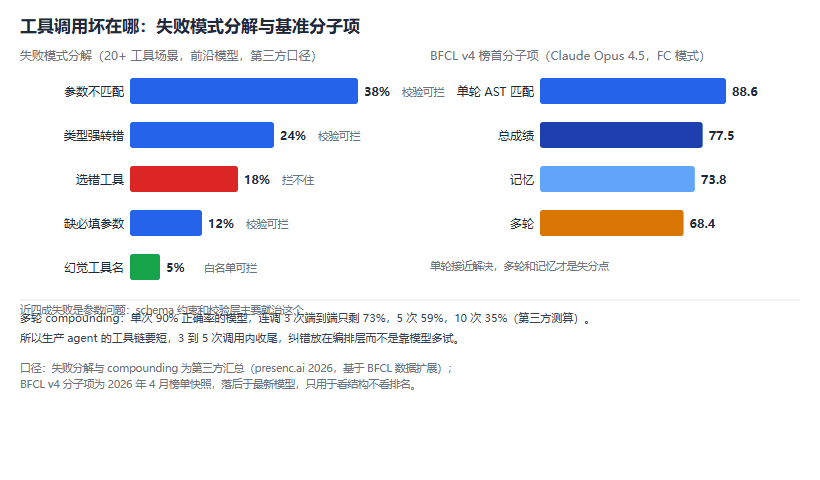
图 1:左图是五类失败的占比(第三方汇总口径),右图是 BFCL v4 分子项,单轮接近解决,多轮和记忆明显掉分。
schema 军规:含糊和精确,20 个查询差出 11 个
我写了个模拟器:同一批 8 个工具,两套 schema,跑 20 个查询加 5 个「不该调任何工具」的负例。模拟方法是让模型按词面重合度打分(工具名权重 2、描述 3、参数 1),谁分高选谁,再加一点噪声。
- 含糊 schema:名字是
get2、do_query这种简写,描述一句话,参数没类型没约束 - 精确 schema:名字动词开头带对象,描述里写清什么时候用、什么时候不要用,参数带 enum 和示例
结果差距很大:
| schema | 选对 | 选错 | 漏调 | 平均分辨边际 |
|---|---|---|---|---|
| 含糊 | 5/20 | 5 | 10 | 0.52 |
| 精确 | 16/20 | 3 | 1 | 4.56 |
分辨边际是 top1 减 top2 的得分差,可以理解为模型「犹豫的程度」。含糊那套的 10 次漏调全是负例查询,像「今天天气怎么样」,工具和查询的词面重合度太高,模型没有世界知识帮忙,分不开。
需要说清楚:这是模拟模型,不是真模型。真实模型有世界知识,含糊 schema 的真实差距会比 5 比 16 小。但差距是结构性的,方向不会反。两套 schema 差的是信息量,这个跟模型强不强无关。
由此几条军规,我认为每条都值回票价:
- 工具名动词开头带对象,
query_order_logistics比get2好一万倍 - 描述里写「什么时候不要用」,这一句比写十句用途管用
- 参数能用 enum 收窄就别给自由文本
- 必填参数尽量少,缺一个整次调用报废
- 嵌套结构不超过两层,模型对深结构的遵从度掉得厉害
{
  "name": "query_order_logistics",
  "description": "查询订单的物流轨迹。仅当用户明确询问配送状态、到哪了、什么时候到时使用;查订单金额或商品清单不要用这个。",
  "parameters": {
    "order_id": {"type": "string", "description": "订单号,如 SO2024001"},
    "carrier": {"type": "string", "enum": ["sf", "yt", "zto"], "required": false}
  }
}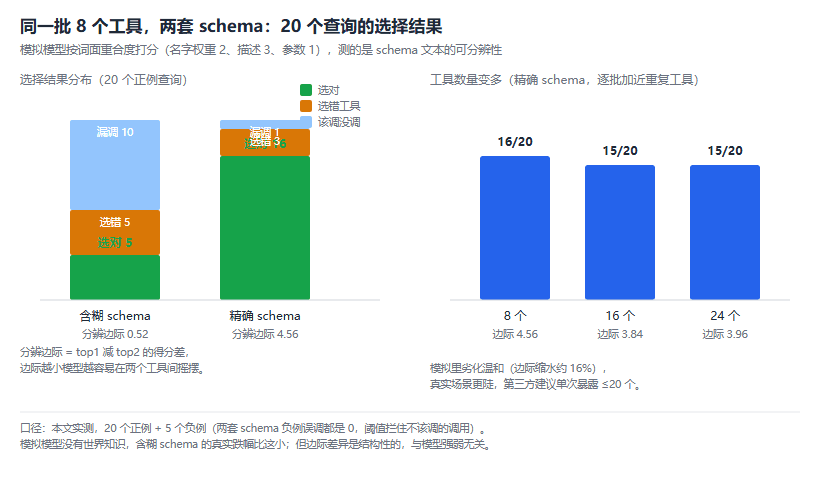
图 2:左图是两套 schema 在同样 8 个工具、20 个查询下的选择结果;右图是工具数量加上去之后,分辨边际的变化。
工具挂到 24 个,边际只掉了 0.6
那工具是不是越多越好?显然不是,但劣化的曲线和直觉不太一样。我把同一套精确 schema 的工具从 8 个加到 16 个再到 24 个(多出来的里有一半是词汇高度重叠的近重复工具,query_order_logistics / search_orders / query_user_orders 这种),选对数是 16/20、15/20、15/20,分辨边际 4.56、3.84、3.96。
从 8 到 16 掉了 0.72,从 16 到 24 只掉 0.12。说明泛化类工具的干扰有上限,真正的分水岭是近重复工具。两个工具名字像、描述像,模型就真的分不清。
Anthropic 的文档口径:多个 MCP server 的工具定义加起来能占大约 55,000 Token。这是文档数字,我没接那么多 server 实测。但按这个口径算,工具定义本身就是一笔不小的上下文开支。
我的建议:单次暴露给模型的工具控制在 20 个以内,超了做分类路由:先让模型选目录(「这是物流问题」),再把该目录的工具给它。图 2 右面板的三根柱子支持这个判断:8 到 16 已经吃掉大部分劣化,再往后加,边际收益趋近于零。
并发的账:6 个调用,1.8 秒和 0.3 秒的差距
模型一轮返回多个 tool_call 的时候,很多人图省事顺序执行。我测了墙钟:6 个互不依赖的调用,每个 sleep 0.3 秒模拟网络往返,三轮平均:顺序执行 1.80 秒,线程池并行 0.30 秒,加速 6.0 倍。用户视角就是「卡了一下」和「秒回」的区别。
LLMCompiler(arXiv 2312.04511,ICML 2024)测的是同一件事:并行函数调用相比 ReAct 串行模式,延迟最高降 3.7 倍、成本降 6.7 倍,准确率还高约 9 个百分点。延迟和成本好理解,准确率也涨是因为中间结果能同时可见,少了几轮「等结果再想」的信息损失。
但有依赖链的救不了。我构造了一个三步链(查订单 → 查物流 → 查签收),并行之后还是 0.90 秒,关键路径压不掉。实践里的做法是:解析一轮返回的全部 tool_call,按依赖关系分波次发射,波次内并行,波次间等待。OpenAI 和 Anthropic 的 API 都支持一轮返回多个调用,代码里别写死「一次只能调一个」。
OpenAI 侧有两个坑来自官方文档,我没有对应账号实测,转述如下:微调模型在一轮多调用场景会禁用 strict 结构化模式;gpt-4.1-nano 在并行批处理时会重复调用同一个工具。用这两个组合的时候,自己加一层按 call_id 去重。
三道闸 200 次注入:全绿之后还有 16.5% 是错的
最后是重头戏。我设计了三道防护闸,注入 200 次调用看拦截效果:
- 闸 1 参数校验:JSON Schema 验类型、required、enum
- 闸 2 白名单 + 业务前置:工具名必须在注册表里,参数过业务检查(比如订单号真实存在)
- 闸 3 反馈重试:把校验错误写回给模型,让它改,最多改 2 次
注入分布和结局:
| 阶段 | 成功数 | 成功率 |
|---|---|---|
| 无防护裸执行 | 67/200 | 33.5% |
| 闸 1+2 之后工具层全绿(执行没崩) | 197/200 | 98.5% |
| 加上闸 3 反馈重试,真正做对(工具对 + 参数对) | 164/200 | 82.0% |
细节:白名单拦下幻觉函数名 12 次(含重试产生的新幻觉);schema 校验拦下参数错 65 次、缺必填 23 次;反馈重试修好 97 次,3 次没修回来。p=0.8 是我拍的假设值,即模型看到错误能改对的概率,真实值取决于模型和错误类型,这个数字存疑,结论的方向不受影响。
真正的教训在最后一行。200 次里有 33 次选错工具的调用,三道闸全绿放行:参数合法、工具注册过、重试也通不过错误信息发现不了它,因为参数本身没毛病。这 33 次占 16.5%,是「执行成功但事办错了」的幽灵。工具层的闸拦得住形式错误,拦不住语义错误,后者只能靠两件事:schema 写得好(回到上一节),以及端到端评测,用真实业务 query 打分,而不是只看调用成功率。
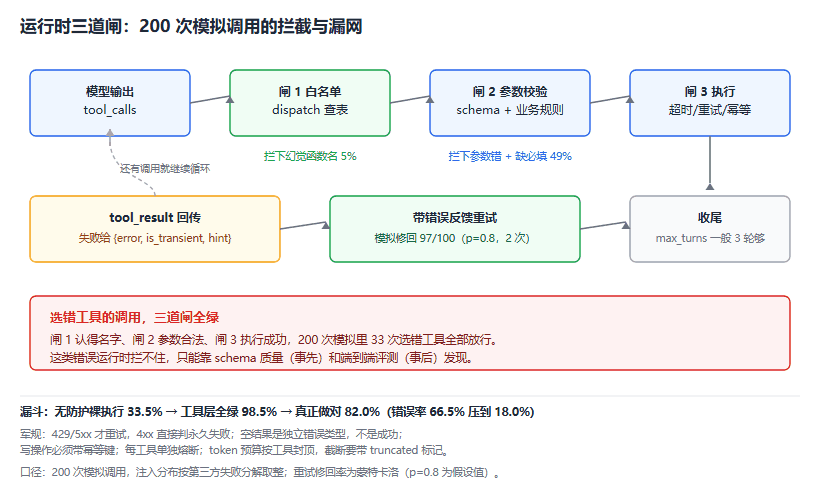
图 3:上部分是三道闸的拦截顺序,红框是最容易被忽视的漏网场景;下部分是 200 次注入模拟的漏斗。
工具返回值:别把 8000 字符塞回上下文
调完工具只是上半场,返回值怎么处理同样要命。OPENDEV 那篇论文(Bui 2026)的做法是按类型摘要:搜索结果给摘要列表、表格给行数统计、API 响应抽关键字段。超过 8000 字符的内容卸载到 scratch 文件,上下文里只留 500 字符预览加一个文件路径。峰值上下文降了约 54%。
翻译成大白话:一次搜索返回三十个网页全文,全塞回去,上下文直接爆,后面的决策质量跟着跳水。我的习惯是给每个工具配一个「裁剪函数」,返回什么类型就裁成什么形状,这个函数和工具定义写在一起,改的时候一起改。
运行时军规
几条踩坑攒下来的规则,条条带血:
- 只有 429 和 5xx 才重试,4xx 是永久失败,重试只是烧钱
- 空结果是独立错误类型,空列表不等于出错,把「查无此单」和「接口挂了」分开处理
- 写操作必须带幂等键,重试和并行都会让同一个下单调两次
- 每个工具单独熔断,一个工具挂了别拖着整个请求陪葬
- token 预算按工具封顶,超限的返回截断并带
truncated标记,让模型知道信息不全 - Anthropic 的每个 tool_use 必须有匹配的 tool_result,出错就用
is_error: true传结构化错误,不能留空
最后一条是我觉得最容易被忽略的。tool_use 没有对应 tool_result,API 直接报错,而报错信息离现场很远,排查起来很烦。
FAQ
Function Calling 和结构化输出是一回事吗?
不是。结构化输出约束的是模型回复的格式,Function Calling 约束的是「回复内容本身必须是一次合法的工具调用」。实践中常配合使用:用 strict 模式保证调用参数是合规 JSON,再用业务校验兜底。
工具执行报错,该不该告诉模型?
该,而且要告诉得结构化。Anthropic 的做法是 is_error: true 加错误详情,让模型在下轮自己修正。但注意 4xx 类的永久错误,告诉模型也没用,直接走熔断或降级,别浪费轮次。
一轮里模型要调 5 个工具,全都执行吗?
先看依赖关系,能并行的并行。但要防「顺手多调」:模型有时会调一个用不上的工具凑数。做法是执行前过一道业务前置检查,或者接受少量浪费,取决于单个工具的副作用和成本。
怎么评「调对了」?AST 是什么?
AST 指抽象语法树匹配,BFCL 用的指标:把模型调用解析成语法树,和标准答案比对参数名、参数值、嵌套结构。它解决了「JSON 合法但参数值是错的」这类漏网,但测不出「调错了工具」,所以端到端业务评测还是省不掉。
MCP 和 Function Calling 什么关系?
MCP 是工具定义的供给协议,Function Calling 是调用机制。一个 MCP server 把工具清单喂给客户端,客户端再转成各家的 function calling 格式下发。两者是上下游,不是竞品。
结语
回到开头的问题:Function Calling 做到什么程度算能用?我的答案是:schema 精确到能过 20 个查询里对 16 个,工具暴露控制在 20 个以内,调用并行发射,三道闸把执行崩溃压到 1.5% 以下,再配一套端到端业务评测盯着那 16.5% 的语义错误。做到这些,demo 到生产的距离就只剩运维了。
下一篇讲 Agent:把单轮工具调用串成多步任务循环,那时候多轮复利曲线就该正式登场了。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。