
一句话总结:AI 编程工具的账单差异,八成来自计量方式和用量形态的错配,两成来自模型选择;这篇把一次 Agent 任务的 Token 消耗拆给你看,再给三种用量形态的月成本测算和六个省钱杠杆。
前面两篇横评里反复提到计量方式,这篇专门算账。起因是有个朋友拿着 Cursor 的账单来问我:明明买的是 20 美元的 Pro,怎么第二周就提示额度不足?答案很简单:他以为 20 美元买的是「无限用」,实际买的是「约 20 美元的第三方模型 API 额度」,而他全周都在用 Claude 模型跑 Agent。这不是 Cursor 坑人,是他没看计费说明。这类错账太常见了,值得单独写一篇。
先说口径:文中模型单价取 2026 年官方页常见值(Claude Sonnet 类按输入 3 美元、输出 15 美元每百万 token 估算),汇率按 7 算,所有测算都是估算,你的实际用量才是唯一的真账本。
你的钱花在哪:一次 Agent 任务的 token 结构
要算账,先得知道一次委派任务消耗多少 token。拆一个中等复杂度的任务(读十个左右的文件、改三个文件、跑一次测试):
| 环节 | 大致 token 量 | 说明 |
|---|---|---|
| 读代码库 | 15-40 万(输入) | 大头。每轮对话都要把相关文件喂进去,多轮就翻倍 |
| 思考与规划 | 1-3 万(输出) | Agent 的中间推理也按输出计费 |
| 写代码 | 1-5 万(输出) | 比你想的少,输出从来不是大头 |
| 重试与修复 | 全程的 20-40% | 测试不过、编译报错再来一轮,这部分最容易被低估,我认为它是最该盯的一项 |
我的结论是:一次中等委派任务,总消耗在 20 到 60 万 token 之间,输入占九成。按 Sonnet 类模型 API 价粗算,一次任务约 1 到 3 美元。这就是为什么各家要用订阅制把你圈起来——按 API 价裸跑,重度用户一个月轻松烧出三四位数。
这个结构还解释了两个现象。第一,为什么「上下文缓存」是各大平台的必争之地:重复前缀命中缓存后输入按一到两五折计,Agent 场景的重复前缀极多,命中率高时能省一半。第二,为什么读文件策略比模型档次更影响账单:能少读两轮文件的 Agent,比用便宜模型的 Agent 更省钱。
三种用量形态的月成本测算
| 用量形态 | 典型构成 | 最省方案 | 月成本 | 不差钱方案 | 月成本 |
|---|---|---|---|---|---|
| 补全为主 | 每天 200 次补全、10 次问答 | 国产免费档或 Copilot Free | 0 | Copilot Pro | $10 |
| 混合 | 每天 2-3 小时 IDE + 每周几次委派 | 国产 Pro 档(59-99 元) | 59-99 元 | Cursor Pro 或 Claude Pro | $20 |
| 重度 Agent | 每天 4-6 小时委派,每周五天 | Claude Pro 触顶后升 Max 5x | $100 | Cursor Ultra 或 Claude Max 20x | $200 |
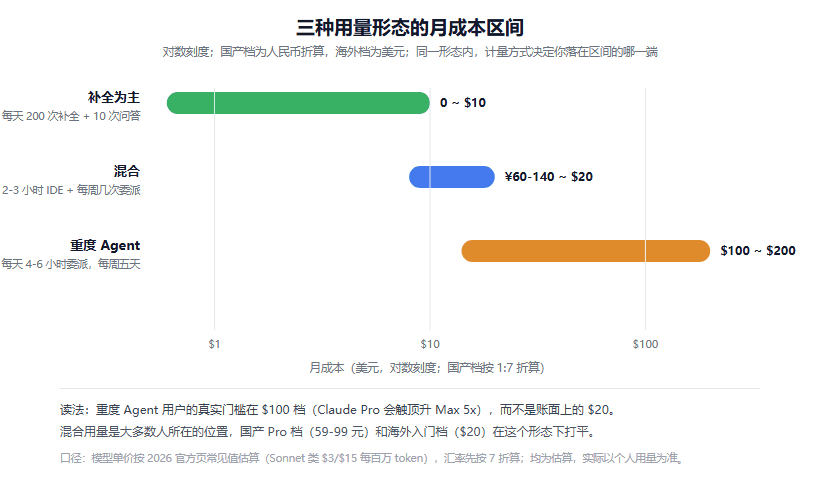
图 1:用量形态决定了成本量级,计量方式决定你落在区间的哪一端。
几个测算里值得展开的点。重度 Agent 用户选 Claude Pro 大概率会在第二周触顶(周上限),升 Max 5x 是常见归宿,所以这个档位的实际门槛是 100 美元不是 20 美元。Cursor Pro 在混合用量下够用,但重度 Agent 下第三方模型额度会烧穿,之后按 API 价继续扣,账单弹性很大。国产 Pro 档的积分制介于两者之间,积分扣多少不透明,需要自己观察一两周才能摸清自己的消耗速度。
免费额度地图(2026 年 10 月版)
免费档是这个市场变化最快的部分,以下是采集时点的状态,仅供感知量级:
| 工具 | 免费档内容 | 最近变化 |
|---|---|---|
| Trae | 签到送积分,当日有效 | 两个月连降三轮:200 → 150 → 100,不再提前通知 |
| Qoder CN(通义灵码) | 赠 300 Credits + 2 周 Pro 试用 | Qwen3.8-Flash 计费系数 0.0×,活动延期、结束时间未公布 |
| CodeBuddy / WorkBuddy | 基础积分每月发放 + 活跃赠送 | 新户另有 14 天有效的注册积分;限免权益以官方通知为准 |
| 文心快码 | 补全永久免费 + 注册赠 10 元额度 | 额度用尽自动切免费模式(150k tokens/小时),不断供 |
| ZCode(智谱) | 新用户总量 1 亿 token,每日发放当日过期 | 只限客户端,不能调 API |
| Copilot Free | 2000 次补全 + 50 次 chat / 月 | 长期稳定 |
| Cursor Hobby | 有限 Agent 请求 | 付费档补全不限量 |
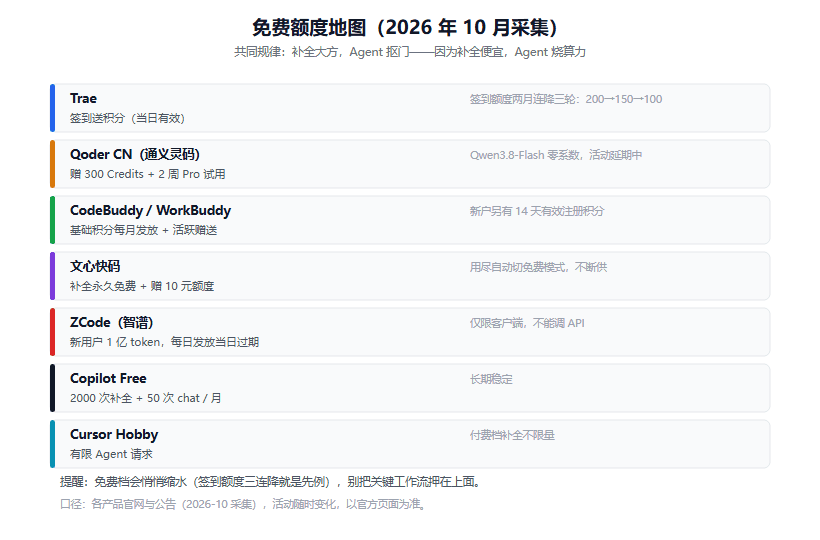
图 2:免费档的共同规律是「补全大方、Agent 抠门」,因为补全便宜而 Agent 烧算力。
从这张表能读出一个规律:所有家都愿意免费给你补全,没有一家愿意免费给你 Agent。原因是成本结构,补全单次几十个 token,Agent 一次几十万。所以「白嫖党」的现实上限就是补全加轻量问答,想白嫖 Agent 只能靠限时限量的活动积分,而活动的方向是越来越抠。
六个真正有用的省钱杠杆
一、把缓存用满。Agent 场景里系统提示、项目规则、常用文件都是重复前缀,命中缓存后输入按一至二五折计。如果你的工具支持自定义规则文件,把常驻内容固化进去,命中率自然上去。
二、模型分层。补全和问答用便宜模型(国产免费模型、各家 mini 档),委派任务才上旗舰。多数工具支持按任务路由,配一次管很久。
三、用量不稳定就按量,稳定才订阅。一个月摸几次工具的人买订阅纯属捐钱,Cline 这类自带 key 的工具按 token 实付更便宜。反过来,每天固定跑 Agent 的人,窗口制订阅比按量省一半以上。
四、积分比价用统一口径。别比「谁家积分多」,比「跑同一个模型一百万 token 花多少人民币」。国产篇里那个归一化表就是干这个用的,六倍的价差真实存在。
五、离线任务走批处理。各家 API 的 batch 模式普遍半价,评测、批量重构、文档生成这类不吃延时的活都该走 batch。
六、别买顶配,先买入门跑两周。Max 和 Ultra 是给「每月多次触顶」的人准备的。你的用量数据比任何推荐都准。
四个账单陷阱
积分过期清零。Trae 的积分 31 天有效,签到的当日有效,攒着不用就是白扔。
免费档悄悄缩水。Trae 的签到额度三个月降了三轮且不提前通知,这不是个例,是行业惯例。别把关键流程押在免费档上。
第三方模型按 API 价。Cursor 和 Copilot 的额度池里,Claude、GPT 这类第三方模型按 API 原价扣,速度比你想的快得多。想控账单,优先用平台自家模型。
汇率与计价货币。GLM Coding 今年在人民币和美元定价之间反复横跳,Kimi 国内站和海外站不是同一个价。充值前看清楚是哪个站的哪个货币口径。
FAQ
一个月 20 美元到底够不够用?
补全加轻量问答,够,还有富余。每天数小时的重度 Agent,不够,实际门槛在 100 美元档。先跑两周记录自己的触顶频率,比看任何测算都准。
怎么知道我的积分扣在哪了?
各家透明度不一,有的能看到按请求的消耗明细,有的只有总余额。透明度差的(这点连腾讯自己的对比文章都承认 CodeBuddy 有待改进),建议先用小额度试用摸清自己的单任务消耗,再决定档位。
缓存真的能省一半吗?
Agent 场景下可以,因为重复前缀占比极高。普通问答场景命中率低些,省一到三成比较现实。
按量付费会不会失控?
给 key 设消费上限(多数平台支持),再在工具里设好单任务的最大轮数。双保险之后,失控风险基本归零。
最便宜的正经用法是什么?
国产免费档管补全和问答,重要任务在限免活动期集中跑,真有硬活再按量买旗舰模型。月成本可以压到两位数人民币,代价是要多动手配置和切换。
结语
算账这件事的门道很简单:你的用量形态决定成本量级,计量方式决定你在量级里的位置,模型选择只影响尾巴。所以别从「哪个工具便宜」开始算,从「我每天到底怎么用它」开始算。把这个问题想清楚,账单焦虑就解决了一半;剩下一半,靠这篇的六个杠杆。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。