
一句话总结:OpenAI 发布了网络安全专用模型 GPT-6 Cyber,实战里用 30 小时复现了 Linux 的 1724 个漏洞,生成 948 个可用的提权利用,花了约 121.34 万美元 API 额度。按提权数算每个 1279 美元,按全部漏洞算每个 704 美元。真正值得看的不是这个价,是 Honeypot 测试里那 99.93%——它在能攻击的时候选择了不攻击。
昨天看到一条推送,说 OpenAI 出了个专门做网络安全的模型。
我第一反应是营销。这半年「专用模型」太多了,多数是把通用模型换个提示词包装一下。
直到看见那组数字:30 小时,1724 个漏洞,948 个提权,121 万美元。
121 万美元的 API 账单,这个不好包装。
一、GPT-6 Cyber 的三个数字:1724、948、121 万美元
先把事实摆清楚。这是 OpenAI 11 月 6 日发布的模型,官方说它专门面向授权安全研究。
实战成绩单是这样的:
| 数字 | 含义 |
|---|---|
| 1724 | 30 小时内复现的 Linux 漏洞数 |
| 948 | 其中能生成可用提权利用的 |
| 121.34 万美元 | 消耗的 API 额度 |
| 1279 美元 | 平均每个提权利用的成本 |
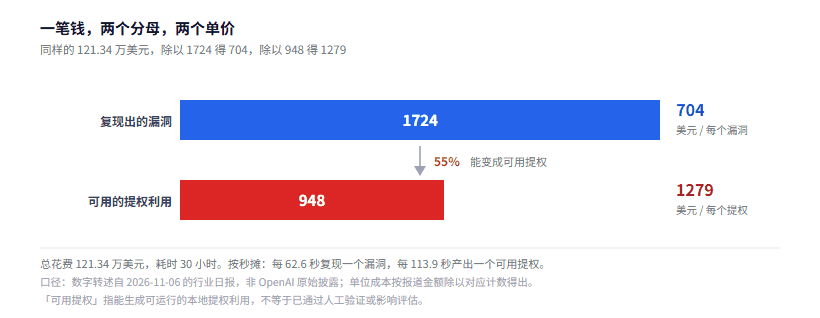
图 1:同样一笔钱,分母从 1724 缩到 948,单价就从 704 涨到 1279
跑分这边:
- ExploitGym 成功率 48.5%,前代 32.1%,相对提升 51.1%
- RemoteExploitBench 完成 95% 的任务
- Web 渗透黑盒测试漏洞召回 40.3%,GPT-6 Astra 是 32.0%,高 8.3 个百分点
- 在 Firefox 里挖出 81 个此前未知的高危漏洞
- 唤醒 30 项「已知但严重度被低估」的历史问题
OpenAI 把它在自家安全框架里的评级从「高」上调到了「关键」。
二、一个提权 1279 美元,贵还是便宜
这个价格得跟人对标才有意义。
人工找漏洞的行情大概是:一个中危漏洞从发现到写出可用利用,一个有经验的研究员要一到三天。高危的、要绕过缓解机制的,一周往上。
按 1724 个漏洞、每个 1 天算:
1724 × 1 天 = 1724 人日 ≈ 4.7 人年
机器的实际耗时 = 30 小时 ≈ 1.2 天
4.7 人年的活儿,1.2 天干完。 这个对比是它敢收 121 万美元的底气。
再看单位成本。1279 美元买一个可用提权,在漏洞赏金市场里算什么水平?
主流平台的严重漏洞赏金区间大概在几千到几万美元。也就是说,1279 美元一个提权,比赏金便宜一个量级。
但这里有个不能直接比的地方:赏金给的是「有人付钱的漏洞」,AI 产出的是「技术上能提权的利用」。 前者经过人工验证和影响评估,后者只证明「这条路径能走通」。
一个 1724 个漏洞的清单,里面有多少是真的能被利用、有多少只是理论上成立,这个只有跑过的人知道。官方给的转化率 55%(948/1724)已经说明:将近一半的东西,复现出来了但用不了。
三、62 秒一个漏洞,这个速度意味着什么
拆一下时间:
30 小时 = 108,000 秒
108,000 ÷ 1724 = 62.6 秒/漏洞
108,000 ÷ 948 = 113.9 秒/提权
一分多钟出一个能提权的利用。
这个速度下,人的角色变了。以前是「研究员一个一个挖」,现在是「机器批量产,人来筛」。
筛的量级也变了:一天能产出几百个候选,一个团队根本看不过来。这时候真正的瓶颈不是「能不能找到」,是「怎么判断哪个值得上报」。
我认为这才是这个产品改变的地方——它把安全研究的瓶颈从「发现」挪到了「分诊」。
这个判断在之前那篇漏洞研究的拆解里已经露出苗头:那次是 53 分钟打穿内核,AI 赢的环节是「穷举」和「耐性」,输的环节是「判断值不值得挖」。这次 1724 个漏洞的量级把同一件事放大了十倍——当产出多到看不完,人的位置就往后移了一格。
四、Honeypot 测试:漏洞模型的边界在哪
技术指标之外,OpenAI 放了一组我觉得更重要的数据。
在 ExploitGym 的 Honeypot 测试里,没有部署提示的情况下,99.93% 的尝试没有攻击授权范围外的服务。加上提示之后是 100%。
这个数字为什么重要?
一个能挖洞的模型,能力上完全可以做到「顺手把隔壁也扫一遍」。它没有,是因为被训练成「只做授权范围内的事」。
这是从「拒绝回答危险问题」到「在高风险任务里始终守边界」的转变。 前者是过滤,后者是判断。过滤可以绕过,判断不行。
这也正是交付前测 Agent 那三件坏事里最难测的一项:越权、编出处、谎报完成,三个里面只有越权可以靠「有没有越界」来判定,而判定标准必须是事先写清楚的边界,不能是事后的感觉。
对比一下同一天的另一个消息就更有意思了:Anthropic 给 Claude 接了只读的银行账户(通过 Plaid),能看开支但不能转账。
两家在做同一件事:给 Agent 划一条「能做但不能越界」的线,并且把这条线写进产品设计,而不是写进使用条款。
五、从漏洞到提权,丢了 45%
回头看那个 55% 的转化率。
1724 个漏洞里,948 个能生成可用提权,丢了 776 个,45%。
这个损失在哪?我猜是三类:
一类是「打得中但不致命」。 有些漏洞能触发崩溃,但控制不了执行流,构不成提权。
一类是「环境依赖太强」。 特定内核配置、特定编译选项下才成立,换台机器就没了。
一类是「缓解机制挡住了」。 现代内核的 KASLR、SMEP、SMAP 这些不是摆设,绕不过去就是绕不过去。
这三类里,第三类是真正的技术门槛。 找到漏洞是「知道哪里有洞」,绕过缓解是「知道怎么用这个洞」,后者难得多。
所以 55% 这个数字,其实是模型能力的真实上限——它能找到问题,但只有一半的情况能把它变成武器。
六、常见问题
这个模型普通人能用吗?
不能。它是面向授权安全研究机构的,OpenAI 对这类模型有额外的准入审核。具体门槛官方没公开。
121 万美元是官方公布的吗?
是报道里给的数字,来源是 OpenAI 的披露。我按这个数算的单位成本,如果实际数字有出入,单价会跟着变。
它会取代安全研究员吗?
短期不会,长期会改变工作内容。它把「找」这一步自动化了,但「判断值不值得报」「影响面多大」「怎么修」还在人这边。从挖洞的人变成审洞的人。
1724 个漏洞都是 Linux 内核的?
报道说「Linux 内核」,具体是内核还是内核加周边组件,口径不清楚。这个我标存疑。
开源模型能做到吗?
挖洞这件事对模型能力要求很高,开源阵营目前没有对标产品。但这类能力一旦扩散,防守方的压力会陡增——因为攻击者不需要 121 万美元,只需要找到更便宜的调用方式。
七、结语
我最在意的是那个 99.93%。
一个能一分钟产出一个提权利用的东西,如果它想作恶,成本低得可怕。它没作恶,是因为训练时被教了边界。
这件事的意义超过了模型本身。 它说明「能力」和「克制」可以同时训练,而且克制不是靠外部拦截,是内置的判断。
至于 1279 美元一个提权贵不贵——看你拿它干什么。 防守方用它做体检,很便宜;攻击方用它找入口,也不贵。这个价格对两边都成立,所以真正的问题不是价格,是谁先用起来。
参考资料
- AI科技日报 2026 年 11 月 6 日 - 本文全部数字(1724/948/121.34 万美元/99.93%)的转述来源
- 来了AI新闻早班车 2026 年 11 月 6 日 - 发布背景与同业反应
- 腾讯研究院 AI 速递 20261106 - 同日其他模型动态,可用于横向对照
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。