
一句话总结:一篇短文拿 CursorBench 4.0 上 DeepSeek V4.1 的一个点(约 47.7 分、单任务约 0.98 美元)推出「全面压过 Grok 4.7」。可图上一个点只能说明那个价位有更优选择,说明不了全面。而且「成本」这一轴里,有一半是 token 消耗,不是单价。
那篇短文的逻辑很短:横轴单任务成本、纵轴分数,DeepSeek V4.1 落在约 47.7%、单任务约 0.98 美元的位置,Grok 4.7 更贵且分数压不过,于是「不知不觉已经全面压过」。它自己也补了一句,Opus、Sonnet 那一档在高价区还能往上顶。
我不是要给 Grok 4.7 说话。我想说的是这张图能证明什么、不能证明什么,中间差得比看上去远。
一个点,一条线,两种证据强度
成本-能力图上,一个模型画成一个点,前提是它在这套测试里的平均成本和中位分数各只有一个值。这两个值被压成坐标之后,方差、任务类型分布、失败率全丢了。
所以「A 的点比 B 更靠左上」严格读出来是:在这套基准、这批任务、这个采样配置下,A 的平均性价比更高。它推不出「A 在所有任务上更强」,更推不出「全面」。
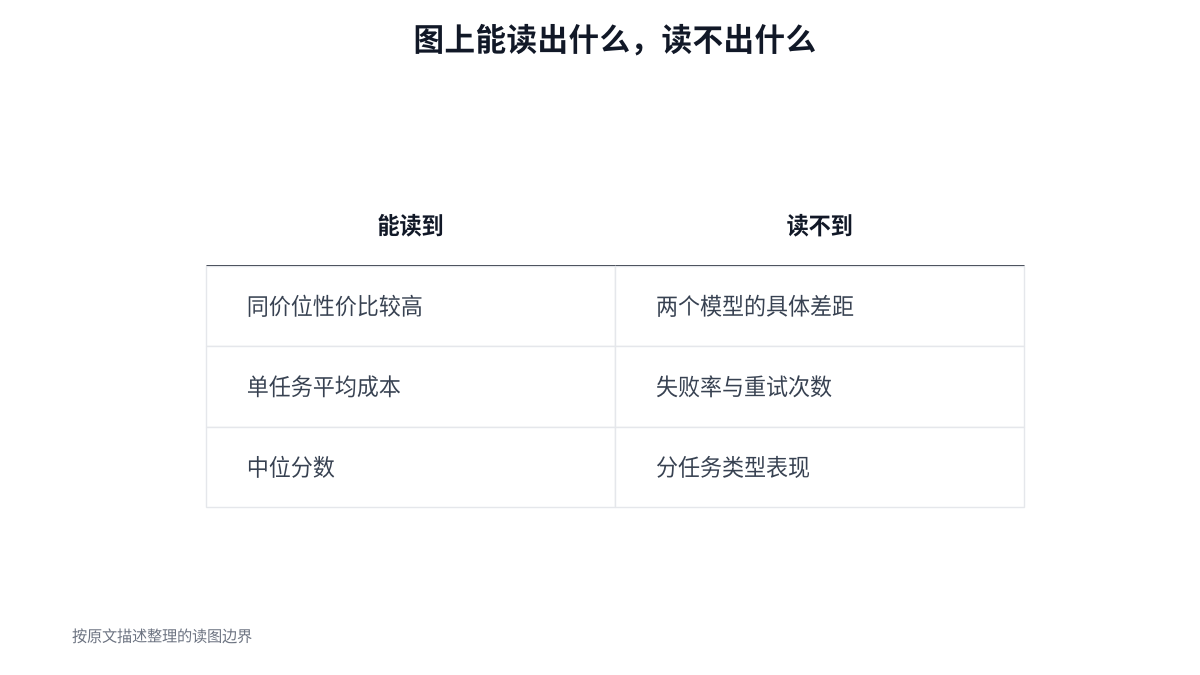
图 1:右边那列,才是「全面压过」需要的东西 原文说 Grok 4.7「更贵且分数压不过」,但没给它的具体坐标。少了这个数,读者没法自己判断差了多少,只能接受作者的目测。这是我最在意的一处。
便宜这件事,一半不在定价表上
横轴是单任务成本,不是每百万 token 单价。这两个数经常被混着用,但它们的关系是乘法:单任务成本 ≈ 单价 × 完成任务消耗的 token 数(再乘上重试次数)。
站内同一天 14 条调价那篇算过一个反例:有的模型输入价降了 75%,账单只降了三成多,因为输出和步骤数没跟着降。反过来也成立,单价不便宜但少走弯路的模型,单任务成本能更低。
所以「V4.1 便宜」这个结论里,有多少来自定价,有多少来自它少犯错误,图上看不出来。这两件事对使用者的含义完全不同:定价优势随时会被对手跟平,效率优势得靠真实的工程能力,跟起来慢。
还有一个隐藏变量:重试。agent 任务跑挂了重来一遍,成本翻倍,而基准测试通常只统计成功路径的平均值。这一点我没有证据说原文的口径包含重试,只能说图上没标。
分数 47.7%,基线在哪
47.7% 这个数字单独看是没法判断的。满分是多少、及格线在哪、同期其他模型分布如何,决定了它是「中上」还是「勉强能用」。
我查了 Cursor 的官网和公开页面,没有找到 CursorBench 4.0 的完整榜单页可以核对这个数,只确认了产品本身在跑 coding agent 这件事。所以这个 47.7 我只能当作原文的转述,不当成核实过的事实。
这不是挑刺。写这类对比文,最容易出问题的地方就是把某一个瞬间的榜单快照写成趋势判断。榜单会变,模型版本会变,一个月后同一张图上点的位置就不一样了。
真要比较,得看三个数
拿两个模型给自己的活儿选型,我会看三样,都在成本-能力图之外。 第一是失败率。同样跑 100 个任务,A 挂 5 个、B 挂 20 个,平均成本再低也没用,因为人工返工的时间没算进去。
第二是任务分布。benchmark 的平均分掩盖了结构差异,有的模型强在短任务,有的强在长链路。你的活儿更接近哪一类,比总分重要。
第三是价格稳定性。站内OpenRouter 那笔日收入账算过,调用量第一和收入第一从来不是同一个模型。厂商调价是常态,按今天的性价比做的预算,下个季度就可能失效。
我的判断
在「日常写代码、跑 agent」这个场景里,DeepSeek V4.1 的性价比确实是当前第一梯队,这一点我不反对。它便宜得实在,能力也够用。
但「全面压过」是个太强的说法。要成立,至少得给出 Grok 4.7 的坐标、两者的失败率,以及同一批任务上的分项得分。三样缺一样,就只能说「在这个价位上我更愿意选它」。
如果只是想给自己的项目选个模型,其实不需要等这些证据。跑一遍自己的任务集,比看十张榜单准。我做站内工具选型时就是这么干的,跑失败的次数直接记下来,比任何平均分都诚实。
FAQ
Q:DeepSeek V4.1 真的比 Grok 4.7 好吗?
在原文引用的那套基准上,它的单任务性价比看起来更高。但「全面更好」需要失败率和分项得分支撑,这些原文没给。
Q:单任务成本 0.98 美元怎么算的?
是基准测试的平均值,等于单价乘以消耗的 token 数,通常不含失败重试。不同 harness 下的口径差异很大。
Q:成本-能力图能当选型依据吗?
可以当筛选的第一道,把明显不合适的排除掉。最终决定还得看你自己任务集上的失败率和长任务表现。
Q:为什么说便宜分两种?
一种是单价低,对手跟价就能追平;一种是单位任务消耗少,靠模型少走弯路,这种优势更难被追上。
参考资料
- Cursor(CursorBench 的发布方,榜单页我没能定位到)
- DeepSeek API Docs(V4.1 的定价与规格)
- tmlDecode · 不知不觉,DeepSeek V4.1 已经全面压过 Grok 4.7 了(本文的起点)
这篇只有一个数是我自己核过的:DeepSeek 与 Cursor 的官网可访问,其余坐标都来自原文转述。47.7% 和 0.98 美元我没能在公开榜单页面上找到对应行,所以全文按「原文这样说」处理,没当成已知事实。你要是手上有完整榜单,把 Grok 4.7 那两个坐标补上,这个比较才算完整。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。