
一句话总结:火山引擎 11 月 11 日发的 Doubao-Seed-Code 报了两个数——综合成本比行业平均低 62.7%,国内首个支持视觉理解的编程模型。前者是相对口径,后者是真差异,两者的可信度不一样。
11 月 11 日这天国内发了四个模型:美团开源 LongCat-2.5、MiniMax 开源 H3-Image、百度 ERNIE 5.5 Flash Preview,还有火山引擎的 Doubao-Seed-Code。前三个是通用能力,第四个只做一件事——agentic 编程。
它报的两个数字里,62.7% 这个降本幅度最抓人。但"比行业平均低"是个相对口径,得先问清楚拿谁当分母。
豆包编程模型的成本降 62.7%,分母是谁
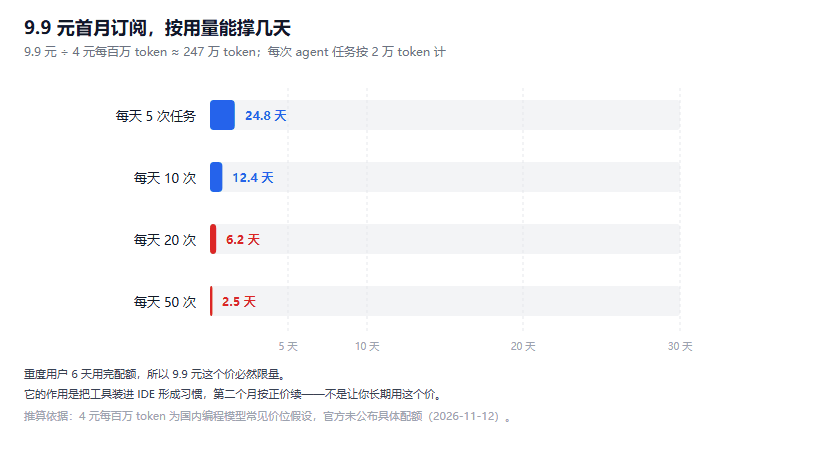
图 1:按 4 元/百万输入 token、每次 agent 任务 2 万 token 估算;纯属推算,官方未公布配额
官方表述是"综合使用成本较行业平均降低 62.7%,达国内最低"。这里有两个含糊的地方。
第一,"综合"指什么。 编程 agent 一次任务要跑几十到上百轮工具调用,输入里既有代码库上下文也有工具返回结果,输出里既有代码也有解释。这些 token 的价格不一样,加权方式不同,算出来的"综合成本"能差一倍。
第二,"行业平均"是算术平均还是加权平均。 如果取国内七八家厂商的价格做算术平均,那这个平均值会被几个高价旗舰拉高;如果是按调用量加权,结果又会偏低。官方没说。
能确定的是换算关系:如果一家团队现在月支出 1 万元用同类编程 agent,降 62.7% 意味着降到 3730 元。这个换算跟分母无关,只看自己的账单。
我自己更在意的是一个隐含前提:62.7% 是不是包含缓存命中。 编程 agent 的上下文有大量重复——同一份代码库每一轮都要重读。如果这个降本幅度是靠缓存价撑起来的,那它对"每次都读新代码"的场景就不成立。
视觉编程:截图变代码,省的是哪一步
"国内首个支持视觉理解能力的编程模型",这句话的具体含义是:可以参照 UI 设计稿、截图、手绘草图生成代码。
这一步省的不是写代码,是把视觉稿翻译成结构描述。以前流程是:设计师给 Figma 或截图 → 前端看图写出 HTML 骨架 → 再调样式。中间那一步全靠人眼读图。
现在模型直接看图输出代码,省的是这一步的沟通和转录。真正的价值不在"少写几百行 CSS",在于改图之后的返工:设计改一版,人要看图找差异、手改 class,模型可以整段重出。
但这里有个我没验证过的点:看图生成的代码,能不能对上项目已有的组件体系。 如果项目用的是自研组件库,模型生成的是一套独立 CSS,那接进去的成本可能比手写还高。这个只有拿真实项目试才知道,官方 demo 都是干净的新页面。
9.9 元首月的账:成本低到这个程度意味着什么
个人开发者可以通过 Coding Plan 首月 9.9 元订阅。同一天,千问 Go! 会员也是 9.9 元起,Qwen4-Max 预览版限时最低一折,智谱、MiniMax、阿里云、Qoder 在天猫五折卖 Token。
一天之内五家同时打折,这不是巧合。
9.9 元这个价格,卖的不是算力,是习惯。 按国内编程模型常见的 4 元/百万输入 token 量级,9.9 元能买 247 万 token。一个程序员一天如果跑 20 次 agent 任务、每次 2 万 token,一天就是 40 万,一周用完。
所以 9.9 元必然是限量的,官方叫"首月",量上通常有配额。这个价的作用是让人先把工具装进 IDE,形成肌肉记忆,第二个月按正价续。
对使用者来说这是个真实的窗口期:首月把想试的场景全试完,别留到下个月。 试完再判断值不值正价。
| 项目 | 数字 | 性质 |
|---|---|---|
| 综合成本降幅 | 62.7% | 相对行业平均,口径未明 |
| 首月订阅 | 9.9 元 | 限量,通常有配额 |
| 上下文 | 未公布 | 官方未披露 |
| SWE-Bench-Verified | SOTA | 未给具体分数与版本 |
兼容 Anthropic API,迁移成本有多低
这个细节容易被忽略,但对工程团队是决定性的:Doubao-Seed-Code 兼容 Anthropic API。
意思是已经用 Claude Code 或基于 Anthropic SDK 写的 agent,改一个 base_url 和环境变量就能切过来。不用重写工具调用协议、不用改提示词结构。
我之前写过 Fable 5.2 的发布,那次讨论的是能力上限;这次讨论的是替换成本。能力差 3 个点、切换成本 0,和能力强 3 个点、切换要两周,选哪个是清楚的。
兼容也带来一个副作用:它把编程模型的竞争压到了纯价格和纯能力两个维度。 接口一样,中间没有平台锁定,用户随时能跑。这对厂商是压力,对买方是好消息。
SWE-Bench 拿 SOTA,成本优势不等于能进生产
SWE-Bench-Verified 是修真实 GitHub issue 的基准,拿 SOTA 说明在"给定 issue 和代码库,能不能改对"这件事上它在前列。
但这个基准和生产环境差三层。
第一层是 issue 的质量。 基准里的 issue 有清晰描述、有复现步骤、有维护者确认。真实工单经常是一句"登录有问题"。
第二层是代码库的规模。 基准的仓库通常在几万行,企业项目动辄百万行,检索和上下文管理是另一套工程。
第三层是验收。 基准用测试用例判定,生产用 code review 和线上监控。测试通过但 review 不过的改动,在真实团队里占多大比例,这个数字比基准分数更能说明问题。
所以我的判断是:SWE-Bench SOTA + 62.7% 降本,适合做"第一轮候选",不适合直接替换现有的主力模型。 先拿自己仓库里过去三个月的真实 PR 跑一遍,看它改出来的东西能不能过 review,这比任何榜单都准。
谁该试,谁可以等
该试的: 前端团队(视觉能力对 UI 还原是直接收益)、已经在用 Claude Code 的团队(切换成本接近 0)、对成本敏感的初创(62.7% 如果是真的,一年省下的钱够招人)。
可以等的: 后端核心服务(对正确性要求高,等社区跑出真实 PR 通过率)、已经有稳定 agent 工作流的团队(迁移本身有风险,收益不确定)、需要私有化部署的(权重没开源)。
还有个变量值得盯:LongCat-2.5 是同一天开源的。 一个是闭源 API 降价,一个是开源权重自部署,两条路对成本的影响完全不同。API 降价省的是运营成本,开源省的是边际成本但前期投入大。LongCat-2.5 的部署账我算过,745GiB 权重的最低配置是 16 张 80GB 卡,那笔钱够买好几年的 API。
参考资料
- 火山引擎发布豆包编程模型 Doubao-Seed-Code:中国日报网,2026-11-11
- Doubao-Seed-Code 上线火山方舟:火山引擎官方,2026-11-11
- SWE-Bench Verified 基准说明:官方基准页
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。