
一句话总结:三个工具不是竞品关系而是三种定位——Ollama 是命令行服务端、LM Studio 是图形化体验、vLLM 是生产级吞吐引擎,选错的代价是白折腾一晚上;附 RTX 2060 上的实测数据和踩坑记录。
本地跑模型这件事,工具选错比模型选错更常见。我见过有人为了「体验一下」装了 vLLM,卡在 CUDA 版本上一整晚;也见过生产环境用 Ollama 扛并发,然后困惑为什么吞吐上不去。
这篇按定位把三个主流工具拆开讲,数据来自我自己的笔记本(i7-10875H + RTX 2060 6GB),同型号机器的读者可以直接对号。
三者定位完全不同
Ollama:命令行优先的本地模型服务。一条 ollama run qwen2.5:7b 就能跑,模型管理、量化版本、API 服务一体。它的设计目标是「像用 Docker 一样用模型」,适合脚本调用和开发联调。
LM Studio:图形化本地推理。带界面的模型商店、聊天窗口、参数调节,模型加载和显存占用可视化。适合先摸清楚「本地模型能干什么」的阶段,也适合不写代码的用户。
vLLM:生产级推理引擎。核心卖点是 PagedAttention 和连续批处理,高并发下的吞吐是前两者的数倍到数十倍。代价是部署复杂、对 CUDA 版本要求高、没有面向小白的封装。
用一句话概括:Ollama 解决「方便」,LM Studio 解决「看见」,vLLM 解决「扛量」。
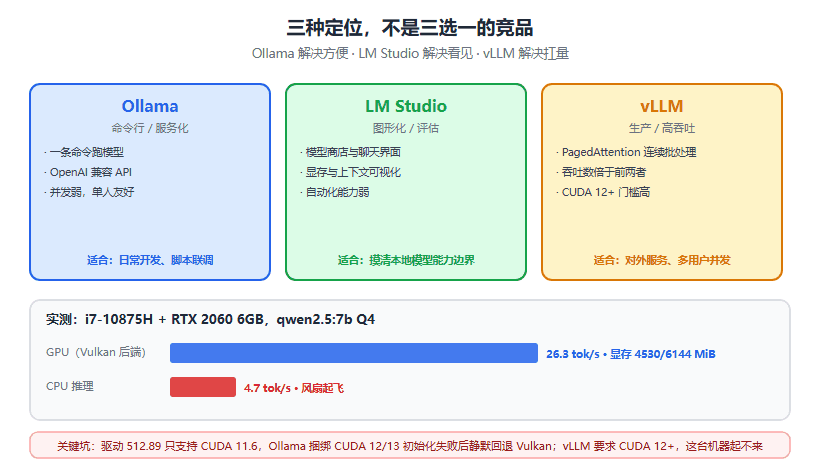
图 1:三张定位卡 + 2060 上的实测速度,底部是关键坑
实测数据:2060 上的真实数字
同一台机器、同一个模型(qwen2.5:7b,Q4 量化),Ollama 的实测结果:
| 场景 | 速度 | 备注 |
|---|---|---|
| GPU(Vulkan 后端) | 26.3 tok/s | 显存占用 4530 / 6144 MiB |
| CPU 推理 | 4.7 tok/s | 风扇起飞,基本不可用 |
这里有个必须交代的坑:这台机器的驱动 512.89 最高只支持 CUDA 11.6,而 Ollama 捆绑的运行时是 CUDA 12 / 13,初始化直接失败,静默回退到 Vulkan 后端。26.3 tok/s 是 Vulkan 的成绩,不是 CUDA 的。想跑 vLLM 更没戏——它要求 CUDA 12 以上,这台机器根本起不来。
这段经历的价值在于:看教程之前先查自己的 CUDA 上限。nvidia-smi 右上角那个版本号,决定了你能用哪些工具,比任何评测都重要。
各自的实际体验
Ollama 的甜点区是中低配机器和小团队内部工具。模型拉取像 docker pull,API 兼容 OpenAI 格式,几行代码就能接进自己的应用(站内 Ollama 与 vLLM 部署实战 有完整写法)。缺点是并发能力弱,默认单请求处理,多人同时用会排队。
LM Studio 的甜点区是评估阶段。加载模型时直接显示显存够不够、能开多长上下文、量化等级怎么选,这些信息在命令行工具里要自己算。缺点是自动化和集成能力弱,做不了服务端。
vLLM 的甜点区是「多用户、高吞吐」的生产场景。同样的硬件,vLLM 靠连续批处理能把吞吐拉到 Ollama 的几倍。但如果只是自己用,它的复杂度纯属负担——部署、调参、监控样样要投入。
选型就看三个问题
- 给谁用?自己或小团队 → Ollama;完全不懂技术 → LM Studio;对外提供服务 → vLLM。
- 要多快?单请求够用就行 → 前两个都行;要扛并发 → 只有 vLLM。
- 硬件什么水平? 8GB 以下显存 → Ollama + 小量化模型;多卡或高端卡 → vLLM 才有意义。
我个人的组合是:日常开发用 Ollama,模型评估用 LM Studio 看一眼参数,生产环境才考虑 vLLM。三个都装不冲突,各干各的活。
三个通用坑
显存不够会静默降级。很多人以为模型加载成功就是 GPU 在跑,实际上可能一半层在 CPU 上。Ollama 用 ollama ps 看,LM Studio 界面直接显示,vLLM 看启动日志的 KV cache 分配。
上下文越长,显存吃得越多。 7B 模型 Q4 权重只占 4GB 左右,但 32K 上下文能把 KV cache 再吃掉 2-3GB。2060 这种 6GB 卡,实际能用的上下文比标称小得多。
量化等级别一味求小。 Q2 虽然省显存,但输出质量掉得厉害,7B 模型建议 Q4 起步,Q5 是性价比甜点。
收尾
工具本身没有优劣,只有匹配。真正决定体验的是「硬件上限 + 使用场景」这两个约束——先把 CUDA 版本和显存搞清楚,再选工具,能省掉大半折腾。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。