
一句话总结:Agent 的本质是一个 while 循环加三个干预点。我用 2000 次模拟实测了步数复利、上下文管理和跑偏纠偏,16 步任务单次执行只剩 26.4%,ReAct 重试能拉回 65.3%,而 30 步长程任务里上下文怎么管,完成率差出近 3 倍。
上一篇讲 Function Calling,模型会调工具了,离 Agent 就差一个循环:调完工具看结果,决定下一步调什么,直到任务完成。听起来简单,真写起来才发现坑全在循环里头:错误会复利,上下文会膨胀,模型会跑偏。这篇文章把这三件事各做了一组实测,再给一个能跑的循环骨架。
先分清三个词:工作流、Agent、多 Agent
这三个词在招聘 JD 和售前 PPT 里基本是混用的,但 Anthropic 那篇《Building Effective Agents》给了个清爽的分法,我认为到今天仍然适用:
- 工作流:通过预定义代码路径编排 LLM 和工具。步骤写死在代码里,LLM 只负责每一步的执行
- Agent:LLM 动态指挥自己的流程和工具使用,自己决定下一步做什么、什么时候收尾
- 多 Agent:多个 Agent 分工协作,通常是一个主 Agent 派活、若干子 Agent 并行干
分清楚的意义在于选型。明确定义的任务用工作流,可预测、好测试、成本低;开放式任务才上 Agent,用延迟和成本换灵活性。Anthropic 跟几十个团队合作后的原话是:最成功的实现采用简单可组合的模式,而不是复杂的框架。他们甚至建议开发者从直接调 LLM API 开始,别一上来就铺框架。框架那层抽象会把 prompt 和响应的细节藏起来,出问题时你都不知道模型到底看见了什么。
工作流那五种模式(提示链、路由、并行化、编排器-工作者、评估器-优化器)我不逐个展开,只强调一点:判断标准就一个,你的任务步骤能不能在写代码的时候数出来。数得出来就写工作流,数不出来才考虑 Agent。
REACt 的本来面目
2022 年的 ReAct 论文(arXiv 2210.03629,ICLR 2023)是现在所有 Agent 循环的老祖宗。核心机制就一句话:让模型把「想」和「做」交替进行。先写一段推理(Thought),再执行一个动作(Action),环境返回结果(Observation),接着想下一轮。
论文在 ALFWoRLd 上把成功率从 45% 拉到 71%,FEVER 上 60.9% 对 CoT 的 56.3%。更有意思的是它的失败分析:纯 CoT 的失败里幻觉占 56%,ReAct 的幻觉是 0%,但 ReAct 自己的失败有 47% 是推理错误、23% 是搜索结果没有信息量。翻译一下:接地气的查询治好了编造,治不了想不通。
还有一个 2026 年的现状值得知道:在推理模型上,显式的「Thought:」提示词已经是多余甚至有害的。模型内部本来就在推理,你再逼它把思考过程写出来,只是浪费 Token。ReAct 的思想活着,形式变了,现在的主流是模型直接吐结构化的工具调用,思考留在内部。
实测一:16 步任务,单次执行只剩四分之一
回到工程问题。一个任务需要多步工具调用,每步都有出错概率,端到端成功率怎么算?我跑了组蒙特卡洛:每次工具调用 8% 概率出错,其中 70% 是可观察错误(工具报错、返回空),剩下 30% 是静默错误(返回值看着正常,内容是错的,重试也发现不了)。两种策略对比:单次执行,任何一步失败任务就失败;ReAct 循环,可观察错误重试,最多 2 次。
| 任务步数 | 单次执行 | ReAct 循环 | 差距 |
|---|---|---|---|
| 1 步 | 92.7% | 97.4% | +4.7pp |
| 4 步 | 71.0% | 90.1% | +19.2pp |
| 8 步 | 51.2% | 81.8% | +30.5pp |
| 16 步 | 26.4% | 65.3% | +39.0pp |
单步 92.7% 听起来还行,16 步乘下来只剩 26.4%。这就是社区常说的复利曲线:单次 90%,五轮 59%,十轮 35%。ReAct 循环把曲线掰回来一大截,但注意它的天花板:静默错误重试治不了,所以 65.3% 就是上限附近,再加重试次数也榨不出多少。
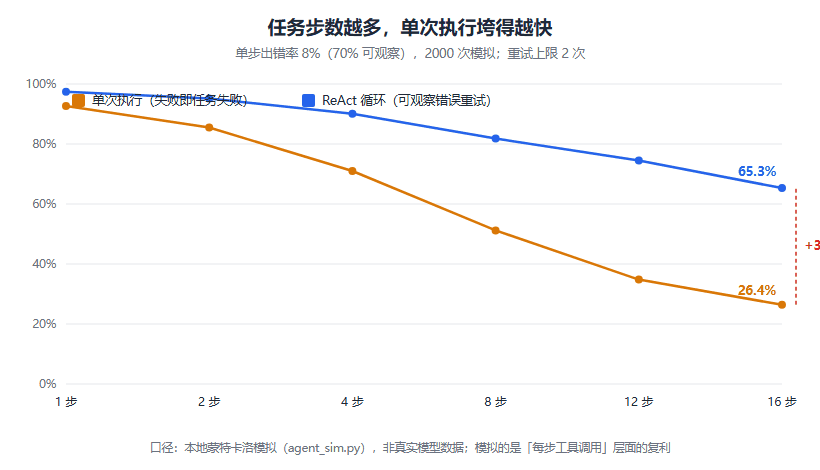
图 1:步数越多,单次执行垮得越快;ReAct 循环的增益来自对可观察错误的重试,静默错误无解。
这张表我认为是整篇文章最重要的:它解释了为什么「demo 里跑得挺好,一上生产就翻车」。你 demo 里测的是三四步的任务(71% 上下),生产里跑的是十几步的任务(三成上下)。不是模型变差了,是数学没站在你这边。
实测二:30 步长程,上下文压垮注意力
比错误复利更隐蔽的是上下文压力。Agent 每一轮都把工具返回值往上下文里堆,而模型在越满的窗口里表现越差。Anthropic 管这个叫注意力预算,窗口里每个 token 都在分模型的注意力。我模拟了一个 30 步长程任务:每步加 200 token 工具输出,窗口 8000 token,满窗时单步错误率升到 3.7 倍。三种上下文管法对比:
| 策略 | 完成率 | 平均存活步数 | 理论峰值占用 |
|---|---|---|---|
| 原样累积 | 8.2% | 12.8 | 6,000 token |
| 定期压缩(每 10 步留摘要) | 17.1% | 14.6 | 2,690 token |
| 子任务隔离(每 5 步只回结论) | 23.5% | 15.8 | 1,150 token |
原样累积基本跑不完,平均第 13 步就崩。压缩和隔离把峰值占用砍掉一半到八成,完成率翻倍还多。这正是 Anthropic 上下文工程那套做法的思路:压缩(compaction,临近上限时总结开新窗口)、清理旧工具结果、把嘈杂的探索塞进子 Agent 只回蒸馏摘要(他们多智能体研究系统里每个子 Agent 只往回传 1,000-2,000 token)。
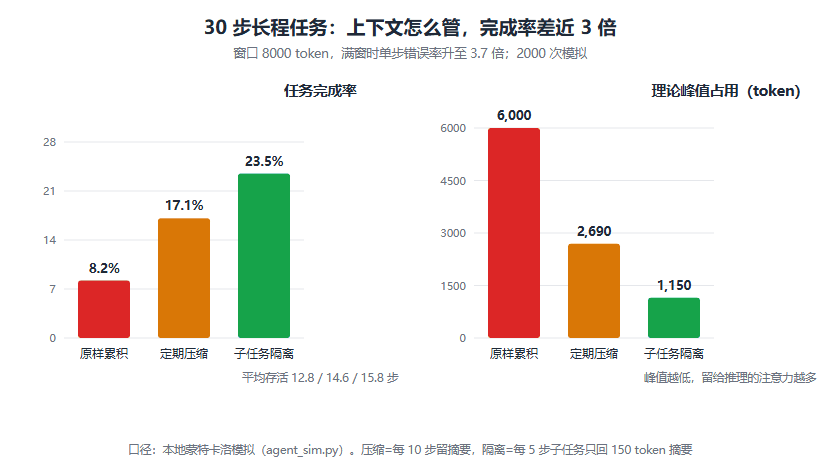
图 2:完成率差距接近 3 倍,代价只是写几十行摘要逻辑。这是我认为性价比最高的一处工程投入。
需要标注清楚:2.7 倍的衰减系数是我为了模拟「注意力随窗口填充而衰减」拍的,真实模型的衰减曲线没这么线性,也跟具体任务有关。但方向性的结论,不管理上下文的 Agent 跑不长,在各种真实系统的复盘里都能看到。
实测三:模型会跑偏,todo 是最便宜的纠偏
第三个坑最反直觉:模型不是只会失败,还会「顺手做点别的」。我模拟了跑偏场景:每步 15% 概率漂移(调一个跟目标无关的工具),漂移状态下不干预会有 60% 概率继续漂;有 todo 清单对照时,85% 概率下一步被拉回正轨。8 步任务的结果:自由发挥平均浪费 5.00 步(总步数膨胀 162.5%),带 todo 检查点浪费 3.19 步(139.8%)。
别看只省了 1.8 步。漂移的真正代价不是浪费步数,是上下文被无效调用污染,进而推高下一轮出错率。跟实测二叠加起来,跑偏的任务基本没有善终。Claude Code 把 todo 列表做成产品功能,Anthropic 的上下文工程文章把它叫结构化笔记,都是同一个东西:让 Agent 定期把「我走到哪了」写下来,下一步之前先对照。
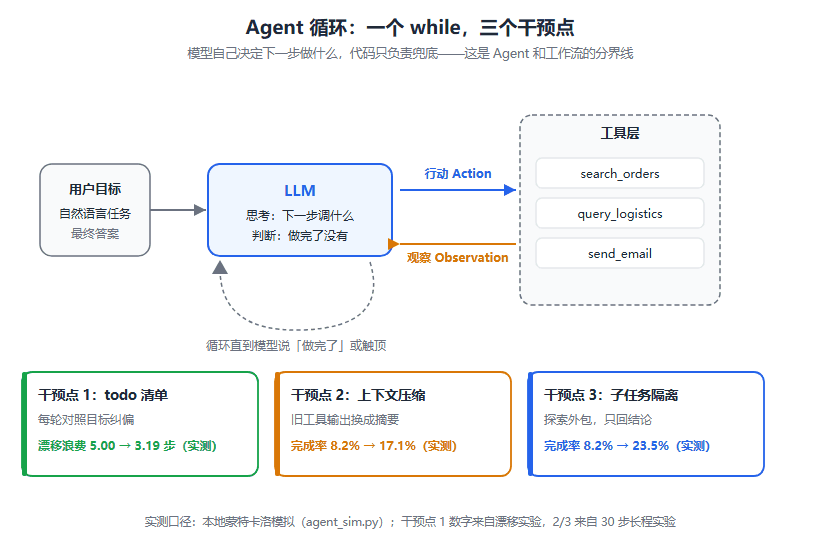
图 3:循环本身十行代码就能写,真正决定成败的是循环外面的三个干预点。
多 Agent:90.2% 的提升,15 倍的账单
单 Agent 搞不定的时候,很自然会想:多上几个 Agent?Anthropic 的多智能体研究系统给了目前最详细的公开数据:Opus 4 当主 Agent、Sonnet 4 当子 Agent 的配置,在他们内部研究评测上比单 Agent Opus 4 强 90.2%。BrowseComp 评测里,token 用量单独一项就解释了 80% 的性能方差。多 Agent 有效的机制说穿了不神秘:花更多 token,并行探索。
代价同样明确:Agent 交互的 token 消耗约为普通对话的 4 倍,多 Agent 系统约为 15 倍。所以 Anthropic 自己划了边界:适合信息量超过单窗口、任务能拆成多个独立方向的活(比如研究报告);不适合所有 Agent 需要共享上下文、或者子任务之间强依赖的活。他们点名多数编码任务就不适合,因为真正能并行的部分没那么多。
我的看法:多 Agent 是给「值钱任务」准备的工具。一个任务跑一次值 50 块钱,15 倍 token 无所谓;值 5 分钱,多 Agent 就是把公司跑垮的方式。多数团队的真实需求是单 Agent 加一个好用的子 Agent 封装,别一上来就建 Agent 群。
60 行写一个能跑的循环
概念讲完,上代码。下面是个单文件骨架,模型调用部分留了接口,你可以接任何一家的 API:
import json

class Agent:
    def __init__(self, tools, max_steps=15):
        self.tools = {t["name"]: t for t in tools}
        self.max_steps = max_steps
        self.todo = []

    def run(self, goal):
        for step in range(self.max_steps):
            # 1. 问模型:下一步做什么(带 todo 和最近的观察)
            reply = self.ask_model(goal, self.todo)
            if reply["action"] == "finish":
                return reply["answer"]
            # 2. 执行工具,带白名单和参数校验(上一篇的三道闸)
            name, args = reply["action"], reply.get("args", {})
            if name not in self.tools:
                self.observe(f"工具 {name} 不存在,可用:{list(self.tools)}")
                continue
            result = self.tools[name]["fn"](**args)
            # 3. 观察进上下文前先裁剪:超长只留摘要
            self.observe(trim(result))
            # 4. 更新 todo:完成了打勾,跑偏了拉回
            self.sync_todo(reply, self.todo)
        return "达到步数上限,任务未完成"

    def ask_model(self, goal, todo):
        # 接真模型:system + 目标 + todo + 最近 3 条观察
        raise NotImplementedError

    def observe(self, text):
        self.history.append(text[-2000:])  # 简单裁剪

    def sync_todo(self, reply, todo):
        # 让模型每轮回报进度,跟 todo 对照;偏了写进上下文纠偏
        pass

def trim(text, liMIT=800):
    return text if len(text) <= limit else text[:limit] + "……[已截断]"
这骨架刻意砍掉了三样东西:框架依赖、隐式状态、以及任何「智能」的假象。循环就是循环,模型负责决定,代码负责兜底。白名单拦幻觉工具名,裁剪防上下文爆炸,todo 防跑偏,步数上限防失控。Anthropic 那句话值得再念一遍:最成功的实现是简单可组合的模式。
失败模式清单
最后给一份我踩坑和读复盘攒的清单,做 Agent 的基本都会遇到:
- 死循环:模型反复调同一个工具、同一个参数。解法:检测重复调用,连续 3 次相同直接熔断或换策略
- 静默错误:工具返回 200,内容是错的,Agent 拿着错答案往下走三步才发现。解法:关键步骤加结果验证,别信「执行成功」
- 上下文爆炸:30 步之后窗口里全是过期工具输出。解法:裁剪、压缩、子 Agent 隔离,三件套按需上
- 跑偏:做着做着开始干无关的事。解法:todo 对照,每轮问一句「这步跟目标有关系吗」
- 步数失控:没有上限的循环等于没有循环。解法:max_steps 是硬闸,触顶就带着已有结果交卷,别硬撑
FAQ
Agent 和工作流到底怎么选?
看任务步骤能不能提前数出来。数得出来(退货审批五步、报表生成三步)写工作流;数不出来(「帮我调研这个行业」)才上 Agent。Anthropic 的建议更保守:先试单次 LLM 调用加 RAG,不够再逐级加复杂度。
我的 Agent 老在几个步骤之间打转,怎么破?
先看是不是死循环:把每轮的工具名和参数打进日志,肉眼找重复模式。八成是同一个错误参数反复触发同一个错误,而模型看不到自己的历史。解法是把「你刚才已经试过 X,结果 Y」显式写进上下文,比换模型管用。
多 Agent 是不是一定比单 Agent 强?
不一定,看任务。Anthropic 的数据:breadth-first 的研究任务强 90.2%,但强依赖共享上下文的任务反而更差,token 还贵 15 倍。判断方法:你的子任务能不能拆成互不打扰的几路?拆不出来就别拆。
上下文压缩丢东西怎么办?
压缩不是删档,是换格式。该留的是决策和结论(「已确认订单号」「方案 B 不行因为 X」),该扔的是原始过程(三十个搜索结果全文)。Claude Code 的 todo、NOTES.md 都是这个思路:让 Agent 自己写笔记,比事后总结可靠。
ReAct 那一套 Thought/Action 提示词现在还要写吗?
推理模型(o 系列、Claude 的 extended thinking 等)内部就在推理,显式 Thought 提示词收益很小甚至负收益。但 ReAct 的循环结构:行动、观察、再决策,仍然是标配,只是「想」这一步藏进了模型内部。
结语
把这篇文章压缩成三句话:Agent 是个循环,循环的敌人是复利、上下文和跑偏;复利靠重试和验证兜,上下文靠裁剪压缩隔离管,跑偏靠 todo 纠;多 Agent 是给值钱任务准备的奢侈品,别当默认配置。
判断一个 Agent 能不能上生产,我的标准就一条:15 步以上的任务跑 100 次,成功率能稳定在多少。跑不到六成,回去打磨工具定义和上下文管理,比换模型实在。下一篇讲本地部署,模型不放在本地,很多应用连Demo 都不算完整。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。