
一句话总结:我们站现在一天能发多篇稿,靠的不是更快的键盘,是把「选题、核数据、写稿、质检、配图、发布」这串动作固化成一条能重复跑的流程。这篇把它拆开写,包括三个把我们卡住的坑,以及我建议你别自动化的那一步。
写这篇的起因很实际:站上的文章从 407 到 416 连着十篇,是我一个人在这套流程上跑出来的。有读者在评论区问,能不能把这套东西讲清楚。
先说结论。真正省时间的地方在「每次都不用重新想格式」,「让 AI 写」本身省不了多少。内容仍然要人定,可那部分是创造性工作,快的空间本来就不大;慢的是那些重复动作,标题多长、摘要多少字、标签从哪查、图片怎么出、链接该带什么属性。
先想清楚要自动化哪一段
一篇技术文章从前到后有六个环节。我按「能不能规则化」排了一遍: 选题不能规则化,它决定这篇文章有没有人搜,得人拍板。核事实不能完全规则化,但能给定标准,比如必须有两个外部原始来源。写稿是创造性工作。格式、质检、配图、发布这四步全是规则。
所以我的做法是:前三步人工主导,后四步交给脚本。这条线划歪了会很痛苦,把写稿也交给 AI 的结果通常是「像稿」,过了字数也过不了读者。
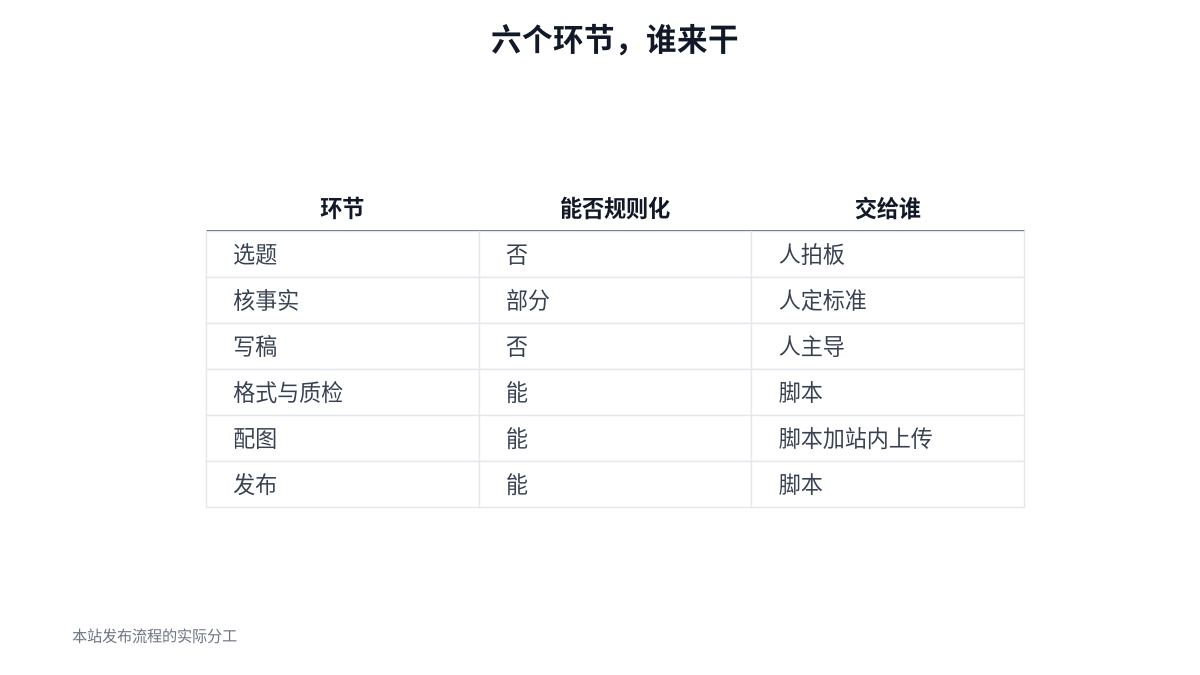
图 1:后四步能规则化,前三步交出去会出「像稿」
准备三样东西
第一样是服务端。站用的是 Z-Blog,装了一个 MCP 插件,对外暴露一个带令牌认证的接口。你在自己站点装同类插件也一样,要确认三件事:地址对不对、令牌怎么用、支持哪些方法。
第二样是客户端。四十行的 Node 脚本就够,我在写 MCP 客户端那篇里给过完整代码,这里不重复。你要的只是能发一次 tools/call。
第三样是质检脚本。这是最关键的一样,也是最多人省掉的一样。没有它,流程只解决了「发得快」,没解决「发得对」。
步骤一:把发布参数写成一份稿子文件
不要直接在脚本里拼参数。我的做法是先落一份 JSON,字段固定:标题、别名、摘要、分类、标签、正文。
{
  "title": "标题,18 到 30 个字",
  "alias": "英文别名,进 URL 用",
  "intro": "摘要,80 到 130 字",
  "cate_id": 2,
  "tag": "工具调用,开源工具",
  "content": "正文 HTML"
}
落文件的好处有三个:质检脚本能读它、出问题能重跑、正文和参数不会混在一起改。 分类那栏用的是数字编号,我们站的对应关系是 1 资讯、2 编程、3 品牌优化、4 逆向、5 软件工具。你自己的站要按后台实际编号填,填错不会报错,只会在前台挂到错的栏目。
步骤二:质检卡一道硬门槛
我的质检脚本只管五件事:标题字数、摘要字数、正文长度、小标题数量、站内链接数量,外加十几条措辞禁忌。 规则不是拍脑袋来的,是失败攒出来的。比如先否定再抬高的句式出现超过一次扣分,比如文末不许拿「总结一句」当开头,比如破折号超过三处就提醒。
门槛设在 85 分,不过就不发。这条我建议你也设,而且别设在八十分以下。 理由很直接:低于八十五分时,通常已经有一项硬伤,比如没有内链、摘要超长、小标题数量跟前面所有文章一样。这些东西单看都不严重,堆在一起就是「一眼像批量生产」。
步骤三:配图必须是可核实的
图我分两类:能核实的和不能核实的。项目截图、数据表、流程图算前者,拿模型生成的插画算后者。 站上的数据图都是脚本画的,一张表一条柱,数据来源写在图下方一行小字里。这么做的原因不是审美,是可信度:读者能顺着那行小字点回原始仓库,图上每个数字都能被复核。
生成完要上传到站内媒体库,拿到正式地址,再把地址替换进 HTML。别用外链图床,图挂了文章就废了,而且外链图片没法进 sitemap 里的图集。
步骤四:发之前把状态定成公开
调用发布接口时有个状态字段,我一开始没传,文章进了草稿箱,我以为接口挂了,排查了半小时。 显式传公开状态最稳。发完立刻回读一次,确认返回里有文章 id 和正式 URL,拿到才算成功。
要改已发布的文章,同一个接口再传一次 id 就是更新,不会新建一篇。这个用法很实用:质检建议改版式时,我不用去后台手点。
const res = await rpc({ jsonrpc: '2.0', id: 2, method: 'tools/call', params: {
  name: 'zblog_write_article',
  arguments: { ...draft, status: 0 } } });
三个把我们卡住的坑
第一个:媒体库同名文件写不进去。重传时报「读不到返回内容」,实际是服务端拒了同名覆盖。配图文件名带版本号就能绕开,别用 cover.png 这种通用名。
第二个:握手第二步是通知,服务端一个字都不回。若把所有请求统一按 JSON 解析,这里必崩。判据看方法名前缀,notifications/ 开头的一律不等回包。
第三个:回包形态不统一。同一份代码换个服务端,可能从纯 JSON 变成 data: 开头的单行。两种都接住,才谈得上可移植。
这三个坑的共同点是:它们都不在文档的主线里,都在「服务端实现差异」这一层。所以流程里我留了一步「先用最小请求探一下」,不假设任何服务端行为。
我建议你别自动化的那一步
审核。哪怕全套流程跑得再顺,最后那一步我也坚持人看一遍:事实有没有错、结论是不是过强、有没有把推测写成确定。
理由不是不信任工具,是这类错误的代价不对称。格式错了改一下就行,事实错了会挂在站上好几年,还会被引用。写去 AI 味那篇时我提过一句:流程能管形式,管不了「这个说法到底对不对」。
顺带说个反面:我也不建议全手动。省略质检这一步,你刷出来的是一堆格式各异、没有内链、摘要超长的稿子,短期看着勤快,长期是在给站点挖坑。
再说它的适用边界。它适合「有明确素材、需要稳定输出」的场景:工具拆解、版本更新、实测记录。它不适合需要长期采访、需要独家信息、需要判断力的选题。 还有一个我没解决的问题:这套流程目前只有我一个人跑。多人协作时,谁改了稿、谁改的质检规则、两次发布之间发生了什么,靠文件命名约定撑着,没有真正的版本记录。要上多人,得先把这层补上。
如果你也在运营一个技术站,我的建议是先做质检那一步,再接发布。顺序反过来,你会发得很快,然后花更多时间回头改。
FAQ
Q:必须用 Z-Blog 吗?
不必。这套流程的本质是「稿子文件加质检加接口发布」,WordPress、Halo、Typecho 都能套,只要它有可调用的发布接口。
Q:AI 负责写到什么程度?
我的用法是让它出骨架和初稿,观点、判断、数据核对由人做。纯生成的稿子通常过不了质检里的措辞项。
Q:质检规则要自己写吗?
要。而且应该是从你自己的失败里长出来的,抄别人的规则表只能挡住一部分。
参考资料
- MCP 规范 · 2025-06-18(工具调用与通知的语义)
- Z-Blog 官网(插件与应用中心的安装方式)
口径与核验说明。这篇里哪些是站内实况:流程六个环节、质检的五项硬指标与 85 分门槛、配图必须站内上传、状态字段不传会进草稿、同名媒体上传失败、通知无回包、SSE 回包,都是这套流程在我们站上跑出来的经验,不是转述别人的教程。分类编号是我站的对应关系,你的站不同。发布接口的参数名各插件不一样,以你的服务端 tools/list 返回为准。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。