
一句话总结:动态调试卡在第一步,通常不是调试器坏了,而是目标有反调试。这篇把五类常见手段(系统标志、时间差、断点扫描、异常处理、结构检测)的实现位置和识别方法列清楚,再给一套三步排查流程,让「附加就崩」变成可定位的问题。
调试器附加上去,进程立刻退出;或者跑着跑着速度变成十分之一;又或者单步到某一行就崩溃,异常地址还在 ntdll 里。这三种现象背后是同一件事:程序在检查自己有没有被调试。
这类代码在游戏、商业软件、部分恶意样本里到处都是。看反作弊那篇讲的检测面,其中「客户端自查」这一层就是本篇的内容。识别的意义不只是绕过,更实际的是:你在分析别人的程序时,得先让它跑起来才能看逻辑。
示例继续用虚构靶场《星陨 Online》,偏移仍为虚构。工具是上一篇的 x64dbg。
先分清五类,再谈怎么认
反调试方法看着杂,归到实现层面只有五类。这个分类很重要,因为同一类的手段识别方式几乎一样,认出一类就等于认出一片。
| 类别 | 典型手段 | 实现位置 | 现象 |
|---|---|---|---|
| 系统标志 | IsDebuggerPresent、NtGlobalFlag、堆 Flags | PEB 字段 | 附加即退出,无提示 |
| 时间差 | rdtsc、QueryPerformanceCounter | 函数入口/循环内 | 能跑但极慢,或中途退出 |
| 断点扫描 | 扫描代码段 0xCC、读 DR0–DR3 | 启动时或定时线程 | 断点不命中,或断下就崩 |
| 异常处理 | SetUnhandledExceptionFilter、SEH 陷阱 | 初始化阶段 | 断在 ntdll 的异常分发里 |
| 结构检测 | TLS 回调、父进程检查、窗口枚举 | 入口点之前 | 还没到主函数就已退出 |
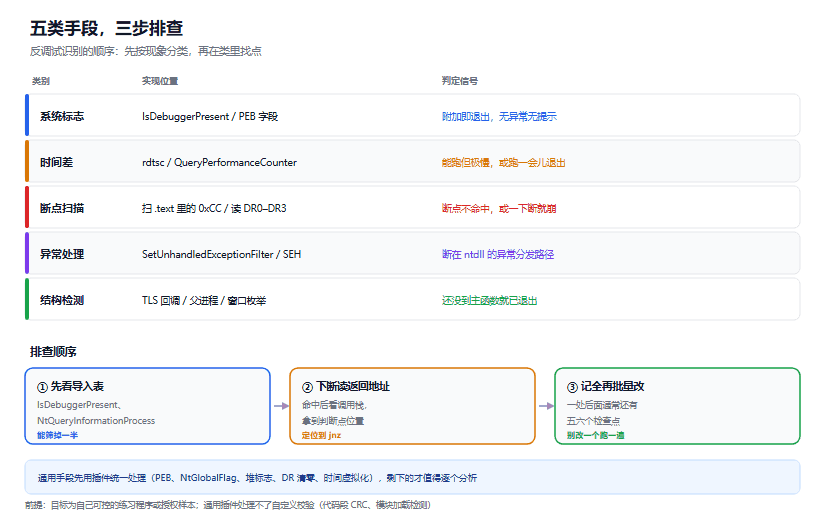
图 1:上半按现象对照五类手段,下半是排查顺序
我对这张表的用法是:先按现象定位类别,再在那一类里找具体点。反过来做(先猜具体 API)效率低得多。
第一步:静态看导入表,能筛掉一半
最省力的入口是导入表。绝大多数程序不会手写 syscall 去读 PEB,而是直接调现成的 API。x64dbg 打开目标后,符号窗口(Symbols)切到 starfall.exe,能看到它导入的所有函数。
值得立刻警惕的几个:
IsDebuggerPresent/CheckRemoteDebuggerPresent:最直白的一类NtQueryInformationProcess:参数里带ProcessDebugPort(7) 或ProcessDebugFlags(0x1F) 的调用OutputDebugString:配合GetLastError做「有没有调试器」的判断,是很老但还在用的技巧QueryPerformanceCounter/GetTickCount64:本身正常,但如果和rdtsc一起出现且调用点很密集,值得看一眼
我的一般判断:导入表里出现 IsDebuggerPresent 且调用点只有一两处,说明是简单检查;出现 NtQueryInformationProcess 且被多次调用,说明可能有多层。
第二步:把检查点断下来,看谁在调
静态看不出来的时候,动态断。做法和上一篇的「谁访问了这个地址」同一个思路,只是目标换成 API。
bp IsDebuggerPresent
bp NtQueryInformationProcess
bp CheckRemoteDebuggerPresent跑起来,命中的时候看调用栈。这一步的价值在于你会拿到检查代码的返回地址,也就是判断点的位置。往上翻几行通常能看到:
call    IsDebuggerPresent
test    eax, eax
jnz     short loc_140002A31     ; 有调试器就跳去退出
看到 jnz 后面跟着 ExitProcess 或者一个循环,这就是判断点。改法很朴素:把 jnz 改成 jz,或者直接把 test eax,eax 之后的值清掉。
但先别急着改。 一个检查点后面往往还有五六个。改一个跑一遍,改到不崩为止,这是最笨也最可靠的办法。聪明的做法是一次把所有命中的返回地址记下来,然后批量处理。
PEB 的三个字段:多数「静默退出」都在这
不用 API 直接读 PEB 是最难静态发现的一类,因为没有任何导入表痕迹。x64 下 PEB 在 gs:[0x60],三个字段最常被查:
| 字段 | 偏移 | 正常值 | 被调试时 |
|---|---|---|---|
BeingDebugged | PEB+0x2 | 0 | 1 |
NtGlobalFlag | PEB+0xBC | 0 | 0x70(堆调试标志) |
ProcessHeap->Flags | PEB+0x30 → +0x70 | 2 | 含 0x40000062 之类的位 |
ProcessHeap->ForceFlags | PEB+0x30 → +0x74 | 0 | 非 0 |
x64dbg 里可以直接看:
dump gs:[60]         ; 跟随 PEB
byte(gs:[60]+2)      ; 读 BeingDebugged
表达式语法在不同 snapshot 上可能有差异,以命令窗口补全为准。
手动改的话,把 BeingDebugged 写成 0、NtGlobalFlag 写成 0 基本能过掉最常见的一层。堆的 Flags 稍微麻烦,改错会让堆管理器异常,宁可改 NtGlobalFlag 不碰堆。
这里补一句我的经验:这类检查通常被放在最前面,而且检查完会立刻 ExitProcess。如果你附加后进程「无声无息地没了」,连异常都没抛,优先怀疑这一类,别去查断点冲突。
时间差检测:跑得慢就是信号
原理很直接:单步调试时指令间隔被拉长,程序测两次取时间戳的差值,超过阈值就认为是调试器。
两种实现:
rdtsc:直接读 CPU 时间戳计数器,精度高,一次几十个时钟周期QueryPerformanceCounter/GetTickCount64:精度低但更隐蔽
识别方法不太一样。rdtsc 在反汇编里是独立指令,搜一下就能看到成对出现:
rdtsc
shl     rdx, 20h
or      rax, rdx
mov     [rbp+var_18], rax     ; 记第一次
; ... 一段代码 ...
rdtsc
; 相减后与常量比较
判定的阈值常量是个好线索:出现 cmp rax, 186A0h(100000)这类「整数得不像业务逻辑」的比较,八成是时间阈值。
QueryPerformanceCounter 的识别靠断点加调用栈。这类手段的现象很特别:程序能跑,但是慢得离谱,或者跑一会儿突然退出。你如果发现单步时某段代码特别慢,先怀疑这里。
断点扫描与 DR 检查:专治下断点的人
有一类代码不检查「有没有调试器」,而是检查「有没有下断点」。两种做法:
扫代码段找 0xCC。 软件断点会把首字节改成 0xCC(int3)。程序把 .text 段读一遍,统计 0xCC 的数量,超过预期的(编译器也会生成少量 int3 做填充)就认为被下了断点。
识别方法:如果你下了断点但从来不命中,或者一下断点程序就退化到异常退出,基本就是这个。对策是改用硬件断点,不修改内存。
读调试寄存器。 GetThreadContext 拿到的 CONTEXT 结构里有 Dr0–Dr3,非零说明有硬件断点。这类检查不常见但确实存在,识别方式是给 GetThreadContext 下断,看调用者是不是在比较这些字段。
异常与结构检测:藏在入口之前
SetUnhandledExceptionFilter:程序故意触发一个异常(比如除零),如果调试器在场,异常会先交给调试器;没人处理时走自己的 SEH。通过「异常有没有被我的处理函数收到」反推有没有调试器。
识别:在这类 API 上下断,或者观察崩溃时是不是断在 ntdll 的异常分发路径里。这类手段的麻烦在于它和正常的异常处理混在一起,改起来容易引入新问题。
TLS 回调:代码在入口点之前执行,反调试往往放在这里。识别方式是看 PE 的 TLS 目录有没有回调(x64dbg 加载后入口点不在主模块起点,或者你在入口点下断却从没命中,就要怀疑)。
父进程检查:读父进程名,正常启动的父进程是 explorer.exe,从调试器启动时可能不是。这类检查用 NtQueryInformationProcess 或 CreateToolhelp32Snapshot 实现。
一次处理全部:插件比手动靠谱
上面这些逐个手改,工作量不小,而且容易漏。实际工作中更常见的选择是用插件统一处理。ScyllaHide 是这类插件里用得最广的一个,x64dbg 有对应版本,能一次性处理 PEB 字段、NtGlobalFlag、堆标志、DR 清零、时间差虚拟化这几项。
我的建议是先用插件跑一遍,看看还剩什么。剩下的才是这个目标特有的手段,值得逐个分析。反过来先手工一个个试,会在通用手段上浪费大量时间。
不过插件也不是万能的:它处理的是「已知的通用手段」,遇到自定义检查(比如校验自己代码段的 CRC、检测特定模块有没有被加载)照样失效。这也是为什么上面的分类和识别方法还得自己会。
坑清单
坑一:把「附加后进程消失」当成程序 bug。 大概率是 PEB 类检查加 ExitProcess。先在 ExitProcess 上下断,看调用栈,一步就能确认。
坑二:改了判断点但程序行为异常。 反调试代码常和业务逻辑共用寄存器或栈空间,草率改跳转可能破坏后续计算。改完要跑一遍完整功能,别只看「不崩了」。
坑三:用软件断点查断点检测类,然后陷入死循环。 断点本身触发了检测。换硬件断点。
坑四:时间差检测被插件虚拟化后,程序逻辑也跟着错。 有些程序用时间做业务计算(超时、冷却),虚拟化时间戳会让这些逻辑异常。遇到这种就把时间虚拟化关掉,改用单步跳过检查点。
坑五:只处理了主模块,漏了注入的检查线程。 反调试经常跑在独立线程里,定时轮询。线程窗口里看看有没有可疑的循环线程,比在反汇编里找快。
坑六:以为过了反调试就没事了。 过了反调试只是能调试,后面还有完整性校验、反注入、行为检测。别把这一步当终点。
边界
这篇的所有操作都在你自己可控的程序上:自己的遗留项目、靶场、明确授权的分析样本。反调试识别是安全研究和逆向工程的基础技能,正经用途包括恶意样本分析、崩溃排查、老系统维护。对在线游戏或他人软件使用同类手法,后果在反作弊那篇里说过。
要继续往下走,两个方向:一是学写 IDA/Ghidra 脚本批量定位反调试模式,靠特征而不是靠人眼;二是从防守侧理解,自己写一个带反调试的练习程序,体会哪些手段真的有效、哪些一改就废。写过一遍防守代码,再看到别人的实现就能猜到意图。
参考资料
- x64dbg 官方文档与插件列表
- ScyllaHide 反反调试插件
- Microsoft PEB 与 ProcessDebugFlags 相关文档
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。