
一句话总结:纯向量检索对错误码、型号、专有名词基本无感,纯关键词检索又理解不了同义表达;BM25 加向量双路召回、用 RRF 融合、再上重排,是当前性价比最高的一套组合,本文给可运行的实现。
站里早前写过 RAG 的切片和召回参数(RAG 实战),但那套是纯向量。真实语料里有一类查询向量检索永远搞不定:「CVE-2026-111497 影响哪些版本」「MiniCPM5-2B 的显存要求」。
这类查询的关键是精确串匹配。向量把「CVE-2026-111497」编码成一个语义点,和「CVE-2025-12345」几乎一样近,结果就是召回一堆错文档。
解法很直接:两条路一起走,再合并。
前置条件
| 项目 | 建议 |
|---|---|
| 语料 | 几百到几万条,纯文本或 Markdown |
| 关键词检索 | rank_bm25(小语料)或 SQLite FTS5(要持久化) |
| 中文分词 | jieba |
| 向量检索 | faiss / chromadb,embedding 用 bge-m3 或同类 |
| 重排 | bge-reranker-v2-m3 或任意 cross-encoder |
| 生成 | 任意模型,本地或 API |
重排不是必需,但在混合召回之后加一层重排,Top-3 命中率通常能再涨一截。语料小的时候可以先跳过。
第一步:切分别切坏语义
import re

def split_md(text, size=600, oveRLap=80):
    """按段落聚合到目标长度,保留重叠,避免切断表格和代码块"""
    paras = re.split(r"\n{2,}", text)
    chunks, buf = [], ""
    for p in paras:
        if len(buf) + len(p) <= size:
            buf += p + "\n\n"
        else:
            if buf:
                chunks.append(buf.strip())
            buf = buf[-overlap:] + p + "\n\n" if overlap else p + "\n\n"
    if buf.strip():
        chunks.append(buf.strip())
    return chunks
600 字是起点,不是标准答案。文档结构强(有明确小节)就按标题切,效果比按长度切好。
第二步:建两路索引
import jieba
from rank_bm25 import BM25Okapi
from sentence_transformers import SentenceTransformer
import numpy as np

chunks = split_md(open("corpus.md", encoding="utf-8").read())

# 关键词路:中文必须分词,直接用空格切会全废
Tokenized = [list(jieba.cut(c)) for c in chunks]
bm25 = BM25Okapi(tokenized)

# 向量路
embedder = SentenceTransformer("BAAI/bge-m3")
vectors = embedder.encode(chunks, normalize_embeddings=True)
分词这步是中文场景的分水岭。不做分词,BM25 会把整句当一个 token,等于没有关键词检索。
第三步:双路召回 + RRF 融合
RRF(Reciprocal Rank Fusion)只关心排名不关心分数,所以不用担心 BM25 分数和余弦相似度量纲不同:
def rrf_fuse(rank_lists, k=60, top_n=10):
    """rank_lists: [[id1, id2, ...], [...]],按各路排名给分"""
    scores = {}
    for ranks in rank_lists:
        for pos, doc_id in enumerate(ranks, start=1):
            scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + pos)
    return sorted(scores.items(), key=lambda x: -x[1])[:top_n]


def hybrid_search(query, top_k=10):
    # 关键词路
    q_tokens = list(jieba.cut(query))
    kw_scores = bm25.get_scores(q_tokens)
    kw_ranks = np.argsort(kw_scores)[::-1][:20].tolist()

    # 向量路
    q_vec = embedder.encode([query], normalize_embeddings=True)
    sims = (vectors @ q_vec.T).squeeze()
    vec_ranks = np.argsort(sims)[::-1][:20].tolist()

    fused = rrf_fuse([kw_ranks, vec_ranks], k=60, top_n=top_k)
    return [(chunks[i], s) for i, s in fused]
k=60 是 RRF 的经典取值,作用是压低头部排名的绝对优势。语料小、两路质量差距大时,可以调小到 20–30 让强的那一路更突出。
第四步:重排(可选但推荐)
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")

def rerank(query, candidates, top_n=3):
    pairs = [(query, c) for c, _ in candidates]
    scores = reranker.predict(pairs)
    order = np.argsort(scores)[::-1][:top_n]
    return [candidates[i][0] for i in order]
Cross-encoder 把「查询+文档」一起编码,精度比双塔高,代价是慢。所以流程是「召回 20 → 重排取 3」,不是「全库重排」。
第五步:拼上下文并强制引用
def answer(query, model_client):
    cands = hybrid_search(query, top_k=10)
    docs = rerank(query, cands, top_n=3)
    ctx = "\n\n---\n\n".join(f"[{i+1}] {d}" for i, d in enumerate(docs))
    prompt = f"""仅根据下面资料回答,资料里没有就说「资料未提及」,不要编。
引用时用 [1][2] 标出来源。

资料:
{ctx}

问题:{query}"""
    return model_client(prompt)
「资料没有就说没有」这句必须写。不加这句,模型 90% 会编,而且编得很像。
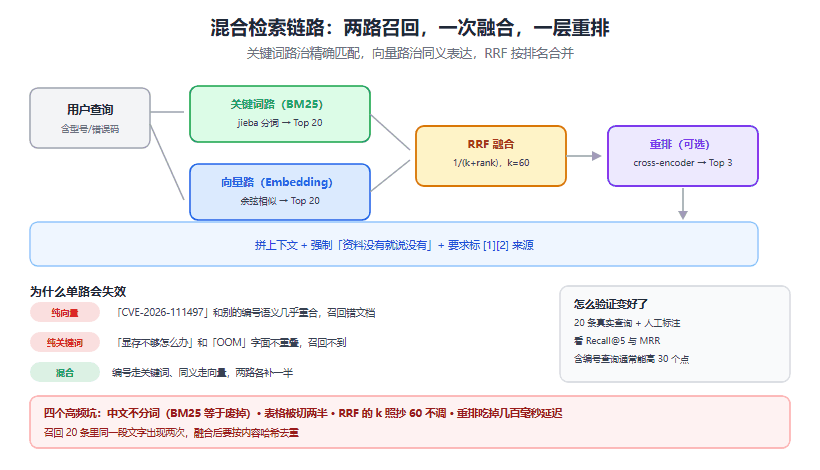
图 1:双路召回各取 20 条,RRF 融合到 10 条,重排取 3 条再生成
怎么评估有没有变好
别凭感觉。准备 20 条真实查询,人工标出「哪几段是正确资料」,然后算两个数:
- Recall@5:正确资料里有多大比例出现在前 5 条
- MRR:第一条正确资料排在第几名的倒数平均
纯向量 vs 混合检索,同一批查询跑一遍,数字会告诉你该不该留这条路。我见过的典型情况是:语义类查询两者差不多,含编号/型号的查询混合检索 Recall@5 能高出 30 个点以上。
坑清单
1. 中文没分词。 直接 query.split() 喂 BM25,等于把整句当一个词,关键词路等于废掉。
2. chunk 切断了表格。 表格被切两半,两半都召回不到完整信息。切分时按 Markdown 结构走,表格和代码块整体保留。
3. RRF 的 k 照抄 60 不调。 语料只有几百条时,k=60 会让排名差异被过度抹平,融合结果接近随机。
4. 重排吃掉所有延迟。 Cross-encoder 单条几十毫秒,20 条就是几百毫秒。要么减候选数,要么只在「检索结果分数接近」时触发。
5. 召回重复内容。 同一段文字在多个文档里出现,Top-3 里两条一样。融合后按内容哈希去重。
6. 上下文塞太满。 3 段 600 字约 1800 字,加上系统提示和问题,8K 上下文刚好。塞 10 段会让模型「看了后面忘了前面」。
边界
这套方案适合几百到几万条的中等语料,单机可跑,延迟在几百毫秒级。
不适合:百万级语料(要上专业向量库和分布式检索)、强结构化查询(该用 SQL,不是 RAG)、需要多跳推理的问题(要 Agent 化,不是检索能解决的)。
参考资料
- rank_bm25 项目 - BM25 实现与用法
- sentence-transformers 文档 - 双塔与 cross-encoder 重排
- BAAI/bge-m3 模型卡 - 多语言 embedding 说明
- RAG 实战(本站) - 切片与召回的上一版实现
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。