
一句话总结:llama.cpp 的 server 已经支持 OpenAI 兼容的 Function Calling,只要模型自带工具模板、启动时加 --jinja,二十行 Python 就能让本地模型查数据库、读文件、调接口;难点不在接入,在「模型说错参数」时怎么兜住。
本地模型最大的短板不是智力,是「只能聊天」。真要干活,它得能调工具:查库存、读日志、发请求。
这篇用一个完整例子走通:llama.cpp 起服务 → 定义工具 → 模型返回 tool_calls → 执行 → 回填结果 → 模型总结。代码能直接跑。
前置条件
| 项目 | 要求 |
|---|---|
| llama.cpp | 较新版本(支持 --jinja 与工具调用) |
| 模型 | chat template 里带 tools 支持,如 Qwen2.5、MiniCPM5、Llama 3.1 系 |
| 显存 | 2B 模型 Q4 约 2.5GB,7B Q4 约 5GB |
| Python | 3.10+,装 openai 和 pydantic |
先确认你的 llama.cpp 支持 jinja 模板:
llama-server --help | grep -i jinja有输出才能继续。没有就更新二进制,这个参数是工具调用的前提。
第一步:起服务
llama-server -m MiniCPM5-2B-Q4_K_M.GGUF \
  -c 8192 \
  -ngl 99 \
  --jinja \
  --host 127.0.0.1 \
  --port 8080
-c 8192 是上下文,工具定义会占掉几百 Token,太小会截断;-ngl 99 全量上卡;--jinja 让服务用模型自带的 chat template(而不是内置的简化模板),工具调用必须靠它。
第二步:定义工具
工具就是用 JSON schema 描述的函数。写两个够用的:
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "get_order_status",
            "description": "查询订单状态,返回当前物流节点",
            "parameters": {
                "type": "object",
                "properties": {
                    "order_id": {"type": "string", "description": "订单号,形如 SO20261026001"},
                },
                "required": ["order_id"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "search_docs",
            "description": "在本地文档库里检索关键词,返回最相关的三段",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "检索词"},
                    "top_k": {"type": "integer", "description": "返回条数,默认 3"},
                },
                "required": ["query"],
            },
        },
    },
]
description 写得越具体,模型选错工具的概率越低。这是最划算的优化,比换模型便宜。
第三步:跑完整的调用循环
import json
from openai import OpenAI
from pydantic import BaseModel, ValidationError

client = OpenAI(base_uRL="http://127.0.0.1:8080/v1", API_key="local")

class OrderArgs(BaseModel):
    order_id: str

def get_order_status(order_id: str) -> str:
    # 换成你的真实查询
    fake = {"SO20261026001": "已发货,杭州转运中心"}
    return fake.get(order_id, "未找到该订单")

def search_docs(query: str, top_k: int = 3) -> str:
    return f"[本地检索占位] 与「{query}」相关的前 {top_k} 段内容……"

def run_tool(name, args_raw):
    """统一入口:先校验参数,再执行"""
    if name == "get_order_status":
        try:
            args = OrderArgs(**json.loads(args_raw))
        except (ValidationError, json.JSONDecodeError) as e:
            return f"参数错误:{e}"
        return get_order_status(args.order_id)
    if name == "search_docs":
        a = json.loads(args_raw)
        return search_docs(a.get("query", ""), int(a.get("top_k", 3)))
    return f"未知工具:{name}"

def chat(user_text, max_rounds=4):
    messages = [
        {"role": "system", "content": "你是助手,需要数据时调用工具,不要编造。"},
        {"role": "user", "content": user_text},
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="minicpm5-2b",
            messages=messages,
            tools=TOOLS,
            tool_choice="auto",
            temperature=0.1,
        )
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return msg.content

        messages.append({
            "role": "assistant",
            "content": msg.content or "",
            "tool_calls": [tc.model_dump() for tc in msg.tool_calls],
        })
        for tc in msg.tool_calls:
            result = run_tool(tc.function.name, tc.function.arguments)
            messages.append({
                "role": "tool",
                "tool_call_id": tc.id,
                "content": result,
            })
    return "超过最大轮数,已中止"

print(chat("帮我查一下订单 SO20261026001 到哪了"))
三个细节决定成败:
tool_call_id 必须原样回填。 模型靠它把「结果」和「调用」配对,id 对不上它会重新调一遍,多花钱还容易死循环。
max_rounds 一定要有。 小模型偶尔会反复调同一个工具,没有上限就是无限循环。
参数先校验再执行。 OrderArgs(**json.loads(...)) 这一步能拦住绝大多数幻觉参数(订单号缺位、类型错)。
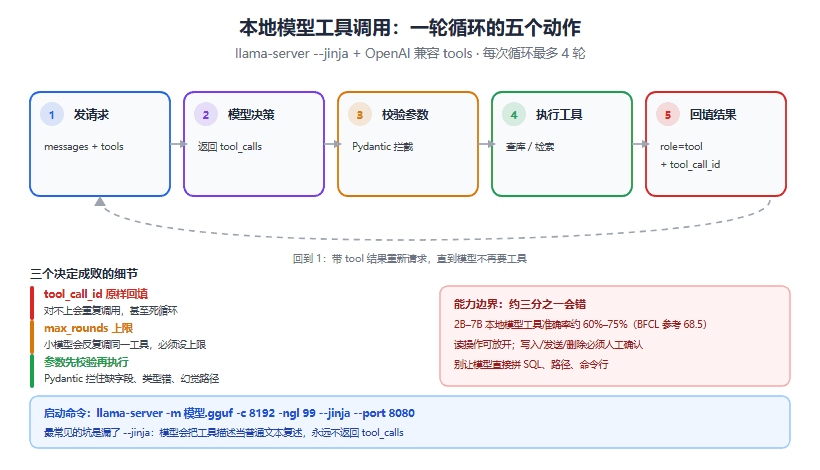
图 1:一轮完整循环:模型出 tool_calls → 校验参数 → 执行 → 回填 → 再生成
坑清单(按命中率)
1. 忘了 --jinja。 表现是模型把工具描述当普通文本复述一遍,永远不返回 tool_calls。这个坑占一半以上。
2. 模型本身不支持工具模板。 有些 GGUF 的 chat template 里没有 tools 分支,换模型比改代码快。选模型时先看模板文件里有没有 tools。
3. 只处理第一个 tool_call。 模型可能一次返回两个调用(并行),只回填一个会导致它下一轮再调另一个,甚至把两个结果混在一起。
4. 上下文被工具定义吃满。 两个工具约 400–600 token,-c 2048 的配置跑几轮就截断。至少给 8K。
5. 参数不校验直接执行。 让模型生成 SQL 或路径时尤其危险,小模型拼错一个引号就可能删库。所有副作用操作都要过一层校验 + 人工确认。
边界
2B 到 7B 的本地模型,工具调用准确率大概在 60%–75%(Bolt E4B 的 BFCL-v3 是 68.5,可作参考)。这意味着三分之一的场景会选错工具或给错参数。
所以定位要清楚:本地工具调用适合「读操作」和「低风险写操作」,比如查状态、检索文档、生成草稿。涉及转账、删数据、发消息给外部,必须加人工确认环节,别指望模型自己靠谱。
参考资料
- llama.cpp 仓库 -
--jinja与 server 参数 - OpenAI Function Calling 文档 - tools 结构与 tool_call_id 约定
- MiniCPM5-2B 模型卡 - chat template 与工具能力
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。