
一句话总结:428B 总参数、23B 激活的 M3.1 Flash 听上去「不算太大」,但 FP8 权重约 428GB,实际起步是 8 张 80GB 卡;这篇给显存怎么算、vLLM 怎么起、吞吐怎么压,以及一张「自建 vs API」的成本表。
先说结论,免得白读:除非你的卡是闲置的,否则 428B 自建不划算。 但如果你有集群、有数据合规要求、或者要微调,这篇的账和命令能直接用。
前置条件
| 项目 | 要求 | 说明 |
|---|---|---|
| 显卡 | 8 × 80GB(A100/H100/H800)起 | FP8 权重约 428GB,还要留 KV cache |
| 互联 | NVLink 优先 | MoE 专家并行吃带宽,PCIe 会明显掉吞吐 |
| 驱动 / CUDA | 驱动 ≥ 550,CUDA 12.4+ | 低版本跑不了 FP8 |
| 推理框架 | vLLM ≥ 0.7 或 SGLang ≥ 0.4 | 需含该模型架构支持 |
| 磁盘 | 1TB 以上空闲 | 权重 + 缓存 + 日志 |
一个容易忽略的点:428B 是总参数,不是显存占用。 FP8 每参数 1 字节,权重约 428GB;如果只有 BF16 权重,就是 856GB,8 卡直接不够。
第一步:确认环境和权重
nvidia-smi --query-gpu=name,memory.total --format=csv
nvcc --veRSIon
输出里确认显存总量、CUDA 版本。然后拉权重(用 hf 命令行,支持断点续传):
pip install -U "huggingface_hub[cli]"
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./m31-flash \
  --max-workers 8
--max-workers 别开太大,很多机房的出口带宽会被打满,反而更慢。断点续传是默认行为,断了重跑同一条命令就行。
第二步:用 vLLM 起服务
vllm serve ./m31-flash \
  --served-model-name m31-flash \
  --tensor-parallel-size 8 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90 \
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --port 8000
四个参数值得解释:
--tensor-parallel-size 8:张量并行度,必须能整除注意力头数,8 是最常见的取值--max-model-len 32768:先别开 1M。KV cache 随长度线性涨,1M 会直接把显存吃干净--gpu-memory-utilization 0.90:留 10% 余量,跑到 1.0 容易 OOM--tool-call-parser hermes:工具调用解析器,具体名字看模型卡,选错会解析不出 tool_calls
SGLang 的等价写法:
Python -m sglang.launch_server \
  --model-path ./m31-flash \
  --tp 8 \
  --context-length 32768 \
  --port 8000
第三步:验证 + 压测
cuRL http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"m31-flash","messages":[{"role":"user","content":"用一句话说明 MoE 是什么"}]}'
能返回就说明服务通了。压测别用自己写的循环,用 vLLM 自带工具:
vllm bench serve \
  --model m31-flash \
  --base-url http://127.0.0.1:8000 \
  --dataset-name random \
  --num-prompts 200 \
--request-rate 8重点看三个数:TTFT(首 Token 延迟)、output tok/s(总吞吐)、P99 延迟。官方标称 170+ TPS 是单请求理想值,并发上去之后总吞吐会变,单请求速度会降。
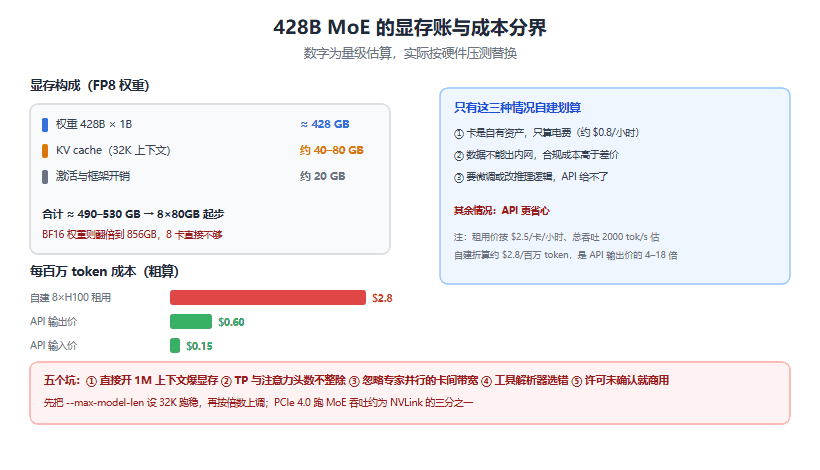
图 1:左边是显存账,右边是「每天多少请求时自建才回本」的粗略分界
成本核算:什么时候自建才划算
按 8×H100 租用价约 $2.5/卡/小时算(不同云差异大,按自己报价替换):
- 每小时成本约 $20
- 假设压测跑到总吞吐 2000 tok/s(乐观值),一小时产出 720 万 token
- 折算 $2.8 / 百万 token
对比 M3.1 Flash 的 API 价:输入 $0.15、输出 $0.60。自建贵 5 到 18 倍。
只有三种情况自建划算:
- 卡是自有资产,折旧已摊完,只算电费(8 卡满载约 8kW,按 $0.1/度算每小时 $0.8)
- 数据不能出内网,合规成本高于差价
- 需要微调或改推理逻辑,API 给不了这个自由度
除此之外,用 API 更省心。
坑清单(按命中率)
1. 直接开 1M 上下文。 KV cache 会把显存吃光,服务起不来或跑到一半 OOM。先 32K,跑稳了再往上调,每次翻倍观察。
2. TP 数与注意力头数不整除。 报错通常很隐晦(shape mismatch),先查模型卡的头数,选能整除的并行度。
3. 忽略专家并行的带宽。 8 卡 PCIe 4.0 跑 MoE,吞吐可能只有 NVLink 的三分之一。买卡之前先看互联。
4. 工具解析器选错。 --tool-call-parser 填错,模型明明返回了工具调用,框架解析成普通文本,前端看起来就是「不支持工具」。
5. 许可没确认就商用。 M3.1 Flash 的权重是放了,但许可条款我没查到明确文本。对外提供服务前必须确认,别默认 Apache 2.0。
边界
这套流程适合有 8 卡以上集群、需要私有化或微调的团队。个人开发者、10 人以下小团队,API 是更理性的选择。
代码和命令都是标准用法,但吞吐和成本数字是估算,实际要按你的硬件压测。我在本机(单卡 2060)跑不了这个量级,没法给实测值。
参考资料
- MiniMax M3.1 Flash 发布与技术细节 - 428B/23B、1M 上下文与权重时间
- vLLM 官方文档 - 张量并行、KV cache 与压测工具
- SGLang 官方文档 - 启动参数与服务化
- MiniMax 开放平台 - API 定价对照
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。