
一句话总结:AI 写的代码不符合项目规范,根因不是模型笨,是它没读过你的规范;把规范写成机器能执行的规则文件(首选 AGENTS.md),是 2026 年性价比最高的工程投资,30 分钟就能见效。
每个用过 AI 编程工具超过一周的人都见过这些现象:它用了你们上周刚废掉的老鉴权模式、造了一个已经存在的轮子、把测试文件放进生产目录。你怪模型笨,其实冤枉它了:每次新会话它都是空白进场的,你的项目规范只存在于你和同事的脑子里。解法想起来有点憨:把新员工入职第一天该知道的事写进一个 Markdown 文件,让工具每次都先读它。这类文件在 2026 年有了统一的名字:规则文件。
五个格式,一张表
| 文件 | 谁在读 | 加载方式 | 状态 |
|---|---|---|---|
| AgentS.md | 30+ 工具(Codex、Copilot、Cursor、Gemini CLI、Aider 等) | 每次会话自动读,子目录就近生效 | 事实标准,Linux 基金会托管 |
| Claude.md | Claude Code 专用 | 每轮都在上下文里,支持 @imports | 现行,可用 @AGENTS.md 桥接 |
| .cursor/rules/*.mdc | Cursor | 支持 glob 作用域,按文件路径激活 | 现行;根目录 .cursorrules 已标 legacy |
| copilot-instructions.md | GitHub Copilot | 仓库级 + 按路径的 .instructions.md | 现行,Copilot 也能读 AGENTS.md |
| SKILL.md | Claude Code 及开放标准 | 按需加载(喊名字才用) | 适合「过程」类知识 |
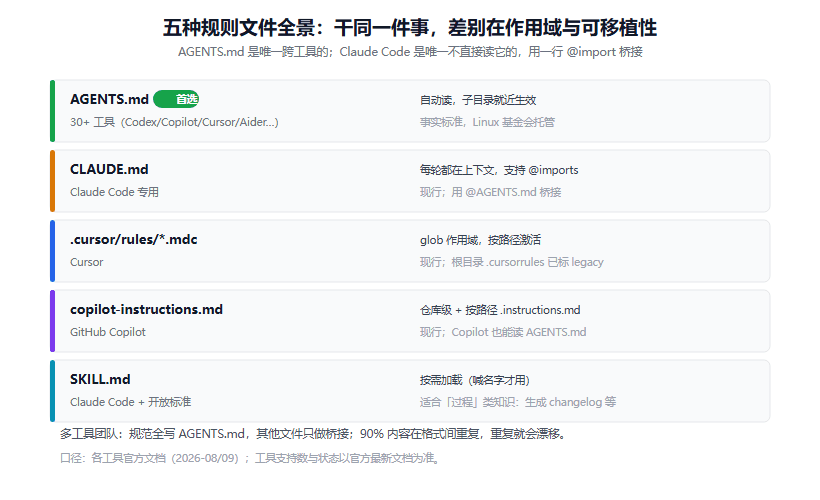
图 1:五个文件干的是同一件事,差别在作用域、加载方式和可移植性。
重点讲 AGENTS.md,因为它是唯一跨工具的。2025 年底 OpenAI、Anthropic、GitHub、Cursor 默默对齐了这个格式,后来捐给了 Linux 基金会旗下的 Agentic AI Foundation。到 2026 年,三十多个工具会自动读它。唯一的钉子户是 Claude Code:它只认自家的 CLAUDE.md,解法也简单,CLAUDE.md 的第一行写上 @AGENTS.md 导入即可,一行桥接,别复制内容。
好规则和坏规则长什么样
这是整篇最值钱的一节。绝大多数人的第一份规则文件失败在同一个地方:写了一堆正确的废话。
坏规则:「写干净的代码」「遵循最佳实践」「保持代码风格一致」。这些话对 AI 是星座运势,它本来就觉得自己在这么做。
好规则长这样:「提交前跑 pnpm lint --fix」「变更只能走 Server Action,Server Component 里禁止 client-side fetch」「错误统一抛 AppError,禁止裸 throw string」。判断标准很直接:一个新同事能不能在不追问的情况下照做。能,就是好规则;不能,就是废话。
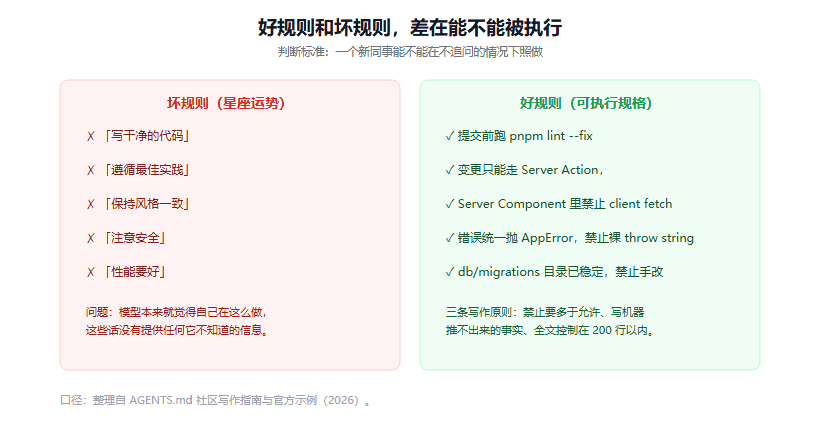
图 2:左边五句是大多数人的第一版规则文件,右边才是能改变 AI 行为的写法。
三条写作原则。第一,禁止要多于允许:模型对行业默认行为很在行,它猜不到的是你项目的例外,把例外写下来。第二,写机器推不出来的事实:构建命令、测试怎么跑、哪些目录不能碰。README 里有的别抄,冗余内容有研究显示会让成本上升两成左右。第三,控制在两百行以内:这文件每次会话都会被读一遍,每一行都在花注意力预算(Codex 还有 32KiB 的硬限制,超了会静默截断)。
一份能直接抄的骨架:项目概览(一段话)、环境搭建(安装/启动/测试的命令原文)、代码规范(命名、错误处理、导入方式)、禁改清单(哪些文件已稳定,谁都不许动)、PR 规则(提交信息格式、必需的检查)。
多工具用户的漂移陷阱
规则文件最大的坑不是写,是维护。你同时用 Cursor 和 Claude Code 的话,同样的规范要写两份,于是三个月后必然出现这种剧情:你在一个工具里修了条规则,教训没有同步到另一份文件,半年后同一个 bug 从另一个工具那里回来了。规则文件没有版本审计,没人告诉你哪份是权威的。
解法是单一真源。规范全部收敛到 AGENTS.md,其他文件只做桥接:CLAUDE.md 一行 import,Cursor 的 .mdc 只留那些 AGENTS.md 表达不了的作用域规则(比如「apps/web 目录下用 ReAct 约定、apps/API 下用 Fastify 约定」这种按 glob 激活的)。改规范只改 AGENTS.md 一处。
还有一个容易被忽略的点:从 Cursor 的 .mdc 迁移到 AGENTS.md 时,原来的 glob 作用域会丢失,要手动把「这条规则只管哪些文件」写进正文。不然会出现「以为还是局部规则,其实已经全局生效」的隐患。
国内工具怎么配
国产工具的规则能力主要走知识库形态,思路一致但入口不同。通义灵码的企业版支持上传代码规范文档做检索增强,团队把编码规范传上去之后,生成结果会按规范走;Trae 企业版有私有知识库导入,把历史项目文档和业务规则喂进去。个人版用户也有轻量方案:项目根目录的规则文件在多数国产工具的 Agent 模式里同样会被读取(它们大多兼容 AGENTS.md 这类约定),具体以各工具文档为准,这块各家口径不一,我查到的信息有限,不敢把话说死。
30 分钟上手路径
第一步,打开你现有的 AI 工具,问它:「基于这个仓库,列出十个新贡献者需要知道的约定。」第二步,把明显的废话删掉,留下项目特有的。第三步,加一节「已稳定,勿动」清单和一节「禁止模式」。第四步,存成仓库根目录的 AGENTS.md。第五步,重启会话,让它做个本来会做错的任务,看规则有没有生效。第六步,用 Claude Code 的话补一行 @AGENTS.md 桥接。
验证很重要。规则文件写完不测,等于没写。找个之前它做错过的任务让它重做一遍,看行为变没变。
FAQ
规则文件和系统提示有什么区别?
系统提示是平台级的行为约束,你改不了;规则文件是项目级的知识注入,跟着仓库走、进版本控制、全团队共享。一个是出厂设置,一个是你的配置。
规则文件会吃掉多少上下文?
两百行以内的 AGENTS.md 大约一千到两千 Token,对现在的长上下文模型不算重。但它是每次会话都带的固定开销,值得为每一行做预算审查。
规则冲突了怎么办?
就近原则:子目录的规则覆盖根目录的(AGENTS.md 支持嵌套,nearest file wins)。设计上就该把通用规范放根目录、目录级例外放子目录。
私有信息能写进去吗?
不能进版本库的(内网地址、密钥路径),各家有本地覆盖机制,比如 CLAUDE.local.md 和 AGENTS.override.md,加进 .gitignore 就行。
写了规则 AI 还是不遵守怎么办?
三个排查方向:文件超长被截断(Codex 的 32KiB 限制)、规则写成了愿望而不是可执行命令、任务上下文太长把规则挤出了注意力。第三个最常见,把关键禁令放到对话开头重申一次,比加长规则文件有效。
结语
规则工程是那种典型的「一小时投入换长期回报」的事。它不能让模型变聪明,但能让你已有的工具立刻更贴合你的项目;它也不挑工具,AGENTS.md 写一次,三十多个工具都认。如果这个系列只让你记住一件可以明天就做的事,就是这三十分钟:给你的仓库写第一份 AGENTS.md,然后观察它少犯了多少傻。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。