
一句话总结:大模型的单步能力已经够用,卡住 Agent 落地的是它每次对话都从零开始——个人记忆(ChatGPT memory、项目规则)已经普及,但组织级记忆还停留在概念阶段,因为它要同时解决四个问题:记错的代价、读写的权限、过期的判断、以及换 Agent 时带不走的迁移。
上周腾讯把腾讯网盘重新定义成「面向 Agent 时代的记忆空间」,目标是把 Agent 积累的上下文和成果沉淀成组织资产(那次发布会我拆过产品结构)。这个说法听着像包装,但它指向的问题是真的。
先说问题本身。
现状:每个 Agent 都是失忆症患者
你今天告诉 Agent:「这个项目的接口返回统一用 {code, data, msg} 结构,错误码从 40000 起」。它记住了,活干得不错。
明天再问它同一个项目的问题,它不知道这件事了。你还得再说一遍。
第三次、第四次,你开始烦,于是选择把这段话写进一个文件,每次对话开头粘一遍。到了第二十次,这个开头的 prompt 已经有一万 Token,占了上下文的一大块,还每次都要付钱(除非吃到前缀缓存)。
这就是「记忆」要解决的事。不是让模型更聪明,是不让它每次都重新学一遍你的规矩。
三层记忆,难度递增
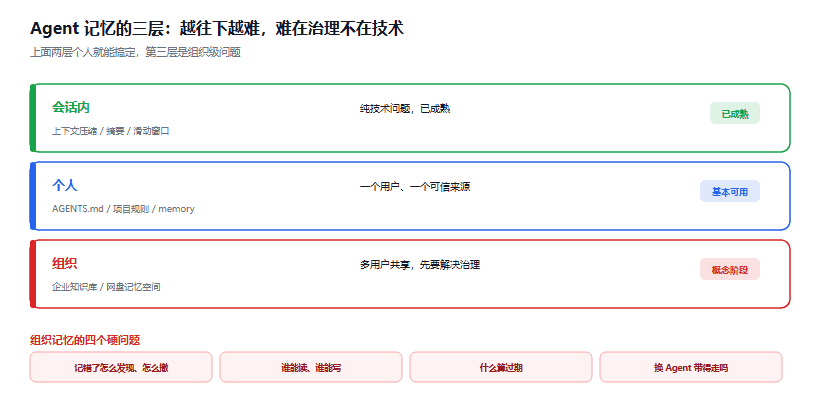
图 1:会话内、个人、组织三层,每往上一层,技术难度和治理难度都翻倍
| 层级 | 解决什么 | 代表做法 | 成熟度 |
|---|---|---|---|
| 会话内 | 一次长对话不遗忘 | 上下文压缩、摘要、滑动窗口 | 已成熟 |
| 个人 | 跨会话记住你的偏好 | ChatGPT memory、项目规则文件、AGENTS.md | 基本可用 |
| 组织 | 团队共用一套上下文 | 企业知识库、网盘记忆空间 | 概念阶段 |
会话内记忆是纯技术问题。上下文窗口不够就压缩,压缩丢信息就分层摘要。这块现在做得不错,工程上也有成熟套路。
个人记忆靠一个简单机制就够了:写一个文件,每次会话开场读进去。Claude Code 的 CLAUDE.md、OpenCode 的 AGENTS.md、Cursor 的 rules 都是这个思路。粗糙但有效,因为它只有一个用户、一个可信来源。
组织记忆难得多。难点不在技术,在治理。
组织记忆的四个硬问题
第一,记错了怎么办。
个人记忆记错,你一眼就看出来「我没说过这话」,删掉重来。组织记忆记错,可能是三个月前某个人的一次错误判断被沉淀下来,然后被后续所有任务继承。错误会被放大,而且没人知道源头在哪。
这一条直接决定了组织记忆必须有「溯源」和「撤销」:每条记忆要知道是谁、在什么场景下写进去的,而且要能整条撤回。
第二,谁能读、谁能写。
会议记录里有薪酬讨论、有客户投诉、有还没公布的组织调整。这些进了 Agent 的上下文,它可能在回答另一个人的问题时说出来。
个人记忆不存在这个问题的前提是「只有一个人用」。组织记忆一旦跨人,权限模型必须和现有 OA 体系对齐,而不是另建一套。
第三,什么算过期。
「这个季度主推 A 方案」这条记忆,下个季度就是错的。过时的记忆比没有记忆更糟,因为它会被当成事实使用。
需要的是给记忆加时效标注和复核机制。技术上不难(加个字段),难的是谁来定期复核——这是运营问题,不是工程问题。
第四,换 Agent 时带得走吗。
你在 A 产品里积累了两年的组织记忆,想换到 B 产品,能迁移吗?
现在基本不能。各家的记忆格式、存储位置、检索方式都不同。这构成了一种新的锁定,比模型锁定更难摆脱——模型可以换,历史上下文换不了。
已经出现的三种做法
文件式(最土但最通用)。 AGENTS.md、Claude.md 这类,纯文本放仓库里,谁都能读、能改、能版本控制。
优点是可审计、可 diff、可回滚,缺点是只能放「静态规矩」,放不了动态积累。而且它有个安全隐患:别人仓库里的规则文件可以被投毒,你的 Agent 会照着执行。
平台式(大厂在做)。 腾讯网盘的记忆空间、ChatGPT 的 memory,把上下文存在平台侧,Agent 按权限调用。
优点是能积累、能跨设备,缺点是锁在平台里,而且用户看不见里面到底存了什么。
知识库式(企业自己搭)。 把文档、Wiki、工单接进 RAG,Agent 检索后使用。
这是目前企业最现实的做法,但它是「检索」不是「记忆」——每次都要重新召回、重新拼上下文,没有「已经理解过」这层。
这三种会长期共存,因为解决的粒度不同:文件管规矩,平台管个人积累,知识库管事实。
我的判断:记忆会成为产品差异点
模型能力的差距在收窄。同一个任务,头部几个模型的差距从「能不能做」变成「做得顺不顺」。这时候决定产品体验的,就不再是模型,是它记不记得你的上下文。
三个理由:
记忆是复利的。 用得越久,Agent 越懂你的项目,切换成本越高。这是留存,不是功能。
记忆是可控的差异化。 模型谁都能接(openrouter 一行配置的事),但记忆结构是产品设计,抄不走。
记忆直接决定 token 成本。 一份组织记忆配合前缀缓存,比每次重发一遍 prompt 便宜一个数量级。这在账本上是实打实的。
但要说冷静的话:现在的组织记忆产品大多还停在「存下来」这一步,离「记得准、用得对、退得掉」还有距离。腾讯那套刚发布,实际能跨产品连续执行到什么程度,得用起来才知道。
常见问题
记忆和 RAG 有什么区别?
RAG 是「检索事实」,每次都要召回;记忆是「已经理解过的上下文」,可以直接用。前者像查资料,后者像同事的默契。
个人记忆会泄露隐私吗?
会,而且很多人不知道平台存了什么。建议定期去各家的记忆管理页面看一遍,该删的删。
组织记忆需要多大规模才值得做?
看重复度。如果你的团队每周有三次以上「跟 Agent 解释同一件事」,就值得。低于这个频率,写个文件够了。
小团队怎么起步?
从文件开始。一个 AGENTS.md 放进仓库,写好技术栈、命名约定、常用命令、禁止事项。成本十分钟,收益立刻能感受到。
换 Agent 产品时记忆怎么办?
目前只能手动导出(如果平台提供的话)。选产品时把「记忆能不能导出」当一个考量项,和当年选网盘看「能不能打包下载」是一个道理。
结语
Agent 的记忆问题,本质是把「一个人的隐性知识」变成「可以被机器调用的显性资产」。这件事在个人层面已经被文件解决了,在组织层面还没有。
对做产品的人,这是一块还没被占满的地;对企业用户,判断标准很简单:别问它记住了多少,问它记错的时候你怎么知道、怎么撤。 后两个问题的答案,才决定这套东西能不能进生产。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。