
一句话总结:上一篇讲的「上下文层」不是买一个产品就能解决的,它落地是三件事——静态规则写进仓库、动态资源按需拉取、实时数据带权限查询。本文给出三层的具体写法、一个 40 行的冲突裁决器(实测能抓出「数据库指向主库还是从库」这类错配),以及五条踩过的坑。
上一篇拆 MIT 那份调研时留了个结论没展开:84% 的企业卡住,卡的不是模型,是模型不知道你们公司到底怎么运转。
这篇讲怎么补。不是讲该买什么产品,是讲三层上下文各写什么、放在哪、冲突了怎么办。
先说一个前提:这套东西小团队做一天能出雏形,大公司做要过跨部门协调。但代码结构是同一个。
前置条件
Python 3.9+(只用标准库,dataclasses 就够)
一个能调模型的客户端(Claude Code、Codex、OpenCode 都行)
不需要向量数据库,不需要 LangChain。三层上下文的第一版,纯文本加一个拼装函数就能跑。
三层的分工
先给结论,后面逐个展开。
| 层 | 载体 | 更新频率 | 谁维护 | 典型内容 |
|---|---|---|---|---|
| 项目层 | AGENTS.md,进 git | 随代码变 | 开发团队 | 技术栈、目录约定、禁改文件、测试命令 |
| 资源层 | MCP resource / 按需工具 | 按需 | 平台或运维 | 表结构、指标口径、配置项、环境信息 |
| 业务层 | 实时查询(SQL / API) | 实时 | 数据团队 | 当期数字、库存、订单状态、审批进度 |
三层不是可选项,缺一层就有一类任务做不了。但三层也不能一次全塞进 prompt,那会把上下文预算烧光。所以要分层、按需、有预算。
第一层:项目层,写死进仓库
这一层最简单,也最容易被忽略。
它解决的问题是:Agent 不知道你这个仓库的规矩。比如测试怎么跑、哪个目录别碰、日志用什么格式、提交前要过什么检查。
写法就是一串短句,不是文档。关键在于「可执行」而不是「全面」:
# AGENTS.md

## 命令
- 跑测试:`make test`(不要用 pytest 裸跑,会漏掉 fixture 初始化)
- 起本地服务:`make dev`,端口 8000
- 迁移:`alembic upgrade head`,改完必须先跑这个再跑测试

## 约定
- 所有 API 响应统一包 `{code, data, msg}`,错误码在 `app/errors.py`
- 时间一律 UTC 存储,展示层再转本地时区
- 日志用 structlog,不要 print

## 禁区
- `migrations/` 下的历史文件不要改
- `.env*` 不要读取、不要打印
- 不要自动执行 `git push`
三条经验。
只写 Agent 会犯错的地方。 你写「代码要整洁」等于没写,它本来就觉得自己写得整洁。写「测试必须用 make test 而不是 pytest」,这才是能拦住它的具体指令。
写完要验证。 找三个常见任务让 Agent 跑一遍,看它有没有照着做。没照做的条款,要么改成更明确的表述,要么删掉——一条不被执行的规则比没有规则更糟,因为它会稀释其他规则的权重。
这一层进 git,但不等于安全。 去年那份 AGENTS.md 投毒的案例说明,仓库里的文件能被第三方注入。所以工作目录的边界要划清,编码智能体隔离那篇里给了一套 CI 扫描的办法。
第二层:资源层,按需拉取
项目层是静态的,资源层是「需要时才读」的那一类。
典型内容:数据库表结构、指标的官方口径、环境变量说明、服务依赖关系。这些东西体积大、变化不频繁,全塞进 prompt 会挤掉真正的任务内容。
做法是做成 MCP 的一个 resource,Agent 需要时自己去读。用 FastMCP 写一个最小版:
from fastmcp import FastMCP

mcp = FastMCP("业务上下文")

@mcp.resource("schema://orders")
def orders_schema() -> str:
    """订单表结构。任何涉及订单金额的查询前先读这个。"""
    return """
orders 表
- id           bigint      主键
- user_id      bigint      用户 ID,关联 users.id
- amount_cents bigint      订单金额,单位:分(不是元)
- status       varchar     pending/paid/shipped/refunded
- created_at   timestamp   创建时间,UTC

注意:amount_cents 是分,展示时要除以 100。
      status = 'refunded' 的记录仍保留在原表,统计 GMV 时要排除。
"""

@mcp.resource("metrics://definition")
def metrics_definition() -> str:
    """核心指标的官方口径。口径不明时以这里为准。"""
    return """
月活(MAU):当月有至少一次登录的去重用户数,不含内部测试账号
GMV:当月 paid + shipped 状态的订单金额之和,不含退款
客单价:GMV / 当月支付订单数(不是除以用户数)
"""
这里有两个设计要点。
resource 的 docstring 就是「什么时候该读它」的说明。 上面那条「任何涉及订单金额的查询前先读这个」,比 resource 内容本身更重要——它在告诉模型触发条件。没有这句,模型不知道自己该去读。
口径定义要写成「排除了什么」。 光说「GMV 是订单金额之和」没意义,关键是「不含退款」。业务知识里有价值的部分几乎都是例外情况,不是通用定义。
MCP 服务本身的搭建细节,从零写一个 MCP 服务器那篇讲得比我细,这边只强调上下文层面的设计。
第三层:业务层,实时但要有边界
前两层解决「懂规矩」和「懂口径」,第三层解决「知道现在是多少」。
这一层最容易出事,因为它要连真数据。三条红线:
只给只读账号。 不要因为方便给它主库读写权限。这一条听起来像常识,但我在项目里见过为了「让它自动修数据」开写权限的,后来一次误判把状态字段刷了。
查询要走封装,不要让它直接拼 SQL。 给一组参数化的查询函数,而不是把数据库连接丢给它:
def get_mau(year: int, month: int) -> int:
    """按官方口径算月活。内部已排除内部账号。"""
    sql = """
        SELECT COUNT(DISTINCT user_id) FROM logins
        WHERE EXTRACT(YEAR FROM login_at) = %s
          AND EXTRACT(MONTH FROM login_at) = %s
          AND user_id NOT IN (SELECT id FROM users WHERE is_internal)
    """
    with readonly_conn() as c, c.Cursor() as cur:
        cur.execute(sql, (year, month))
        return cur.fetchone()[0]
返回值带上「什么时候查的」。 实时数据会过期,模型不知道这一点,可能拿昨天的数字回答今天的问题:
return {"value": n, "as_of": datetime.utcnow().isoformat() + "Z",
        "source": "logins 表", "definition": "metrics://definition#mau"}
带上 as_of 之后,模型在回答时至少有可能说「截至某时刻」。不带,它一定会把旧数字说成现在。
冲突裁决:三层说法不一致时听谁的
这是这套设计里最容易被跳过、但实际最要命的一步。
真实情况是:AGENTS.md 里写了「用只读从库」,MCP resource 里写了「主库」,某个查询函数的注释里又提到「生产库」。三处都对,但指向不同实例。模型读到三个说法,会挑一个最顺手的,而你不知道它挑了哪个。
解决办法是给每层定优先级,冲突时高优先级覆盖低优先级,并且把冲突本身暴露出来。
下面这个 40 行的裁决器我跑过,能同时完成去重和冲突检测:
from dataclasses import dataclass

@dataclass
class Fact:
    key: str
    value: str
    source: str        # project / resource / business
    priority: int      # 越小越优先

class ContextAssembler:
    def __init__(self):
        self.facts = []

    def add(self, key, value, source, priority):
        self.facts.append(Fact(key, value, source, priority))

    def conflicts(self):
        """同一个 key 有多个不同值时返回,用来暴露矛盾"""
        by_key = {}
        for f in self.facts:
            by_key.setdefault(f.key, []).append(f)
        return {k: v for k, v in by_key.items()
                if len({f.value for f in v}) > 1}

    def assemble(self, budget=600):
        """按优先级去重后拼成文本,超预算截断"""
        best = {}
        for f in sorted(self.facts, key=lambda x: x.priority):
            best.setdefault(f.key, f)
        lines = [f"- {f.key}: {f.value} [{f.source}]" for f in best.values()]
        return "\n".join(lines)[:budget]
跑一组刻意构造的冲突数据:
ca = ContextAssembler()
ca.add("数据库", "只读从库 analytics-ro", "project", 1)
ca.add("币种", "人民币,金额以分为单位", "project", 1)
ca.add("数据库", "主库 prod-main(读写)", "resource", 2)
ca.add("当前季度", "2026 Q3", "resource", 2)
ca.add("月活", "128,400", "business", 3)
ca.add("币种", "美元", "business", 3)
输出:
数据库:
  - 只读从库 analytics-ro  [project, 优先级 1]
  - 主库 prod-main(读写)  [resource, 优先级 2]
币种:
  - 人民币,金额以分为单位  [project, 优先级 1]
  - 美元  [business, 优先级 3]

裁决后:
- 数据库: 只读从库 analytics-ro [project]
- 币种: 人民币,金额以分为单位 [project]
- 当前季度: 2026 Q3 [resource]
- 月活: 128,400 [business]
6 条事实里抓出 2 处矛盾,裁决后剩 4 行。冲突列表要打进日志,不要静默处理——上面那两条冲突说明数据层和业务层的口径没有对齐,这是人的问题,得有人去改源头,代码替它决定只会把问题藏起来。
预算:上下文不是免费的
三层加起来很容易超过几万字。而每一轮对话都要重付一次,包括缓存命中的情况也不便宜。
实践里的三条约束:
项目层控制在 1000 字以内。 它每轮都在,最贵。写不进 1000 字的,说明你在写文档而不是写规则。
资源层按需,不预加载。 MCP resource 的好处就是模型自己去读。别在系统提示里塞「以下是所有表结构」。
业务层只带结论不带原始数据。 查 SQL 返回 5000 行明细,模型既读不完也用不上。在函数里就聚合好,返回一个数加一条口径说明。
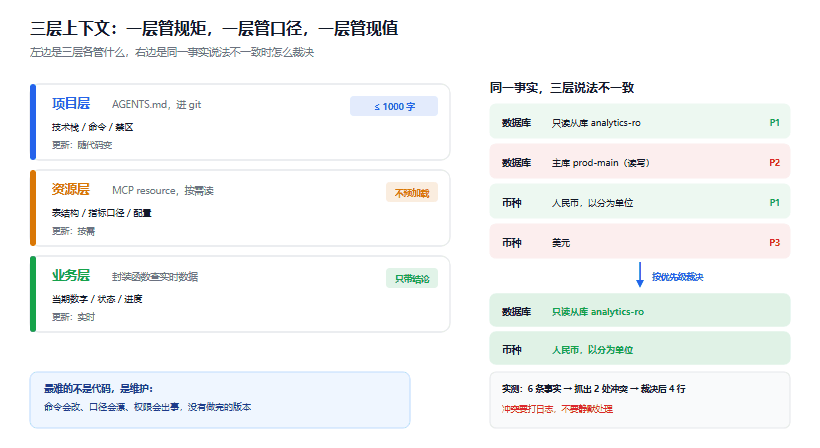
图 1:左边三层各管什么、多久更新一次,右边是同一事实在三层说法不一致时的裁决结果
坑清单
按命中率排,第一条我踩过两次。
1. 三层的同一事实写了不同版本,谁都没发现。
最典型的是数据库地址、币种单位、指标口径。症状是 Agent 偶尔给出一个数量级差别很大的答案,你查半天以为是模型算错,其实是它读到了另一份定义。上线前先跑一次 conflicts(),把冲突清干净。
2. docstring 写成描述而不是触发条件。
写「订单表结构」,模型不知道什么时候该用;写「任何涉及订单金额的查询前先读这个」,它才会在正确时机去读。resource 和工具的说明都是给模型看的说明书,不是给人看的文档。
3. 把当前时间、用户名这类动态值写进静态层。
AGENTS.md 里写「今天是 2026-10-31」,第二天就错了,而且模型不会怀疑它。动态值一律放业务层,静态层只放不变的东西。
4. 返回数据不带时间戳和来源。
Agent 拿一个没有 as_of 的数字,会当成实时值来说。加上时间戳之后,至少有机会说「截至 X 时刻」。
5. 以为写了 AGENTS.md 就生效了。
工具不一定会读。Claude Code 会自动读项目根目录的,其他工具看配置。写完做一次实测:问它「这个项目怎么跑测试」,看它答的是不是文件里那句。答错了说明没生效,别以为是模型不听话。
收尾
三层讲完,回到 MIT 那份调研。它说 84% 的企业没拿到变革性价值,缺的是上下文层。我这篇给的是一份能落地的最小实现,加起来不到 150 行。
但我要说一句不那么乐观的话:这三层里最难的不是代码,是维护。
项目层会过期(命令改了没人更新),资源层会漂移(表结构变了口径没改),业务层会有权限事故。这些东西没有一次做完的版本,只有持续维护的流程。而这部分恰恰不属于任何人的 KPI,所以大多数团队做完第一版就放着烂了。
真要推,我的建议是先只做项目层,一个月后再做资源层,业务层放末尾。项目层成本最低、见效最快、也最能说服人——它能让 Agent 第一次在你的仓库里像个熟手,这个感受比任何 ROI 表格都有说服力。
下一篇讲验收标准:怎么判断一个 Agent 干得好不好,以及为什么没有验收标准就没法迭代。
参考资料
- Creating AI value with enterprise context(MIT Technology Review Insights) - 上下文层的定义与调研数据
- Model Context Protocol 官方文档 - resource、tool、prompt 三种原语的规范
- AGENTS.md 约定 - 项目层约定的通用格式
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。