
一句话总结:这六个模型没有全能冠军。GLM-5V-Turbo 赢在"看图写代码",MiniMax M3 赢在便宜和均衡,Kimi K3 赢在能力上限,K2.7 Code 赢在省 Token,K2.6 赢在 Agent Swarm,K2.8 卡在预览期。按你的任务选,别按跑分选。
前面几篇分别写了这六个模型,每篇都是单聊。这篇把它们拉到一张桌上,回答一个更实际的问题:具体到你的活,该用哪个?
先说我的总体判断:这批国产模型已经过了"能不能用"的阶段,进入了"哪个更划算"的阶段。差距不在能力有无,在成本结构。
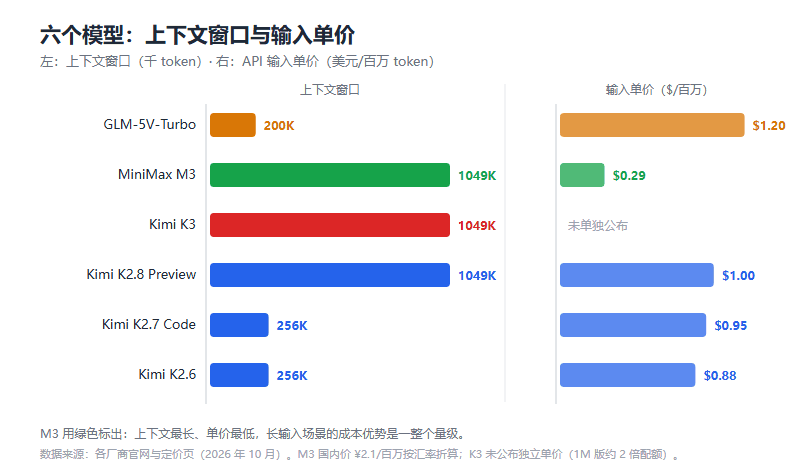
图 1:上下文窗口和价格,是这六个模型分化最明显的两个维度
先看清阵容
| 模型 | 总参数 | 上下文 | 最大输出 | 输入模态 | 开源 |
|---|---|---|---|---|---|
| GLM-5V-Turbo | 7440 亿 | 200K | 128K | 图/视频/文本/文件 | 否 |
| MiniMax M3 | 4280 亿 | 1M | 512K | 图/视频/文本 | 是 |
| Kimi K3 | 2.8 万亿 | 1M | — | 图/视频/文本 | 是 |
| Kimi K2.8 Preview | 未公布 | 1M | — | 图/视频/文本 | 否(预览) |
| Kimi K2.7 Code | 1 万亿 | 256K | — | 图/视频/文本 | 是 |
| Kimi K2.6 | 1 万亿 | 256K | 64K | 图/视频/文本 | 是 |
几个先要摆正的事实:
Kimi 四个型号是一家的产品分层,不是四个竞争对手。K3 是旗舰,K2.8 是日常版,K2.7 Code 是编程特化,K2.6 是均衡老将。它们之间的选择是"哪档合适",不存在谁打败谁。
真正跨厂商的对比只有两组:GLM-5V-Turbo vs Kimi 全家(视觉编程路线之争),以及 MiniMax M3 vs Kimi K3(开源全能 vs 开源旗舰)。
价格:差距比能力差距大得多
| 模型 | 输入($/百万) | 输出($/百万) | 国内价(¥) |
|---|---|---|---|
| GLM-5V-Turbo | $1.20 | $4.00 | — |
| MiniMax M3 | ≈$0.29 | ≈$1.17 | ¥2.1 / ¥8.4 |
| Kimi K2.8 Preview | $1.00 | $4.00 | 会员内含 |
| Kimi K2.7 Code | $0.95 | $4.00 | $15/月起 |
| Kimi K2.6 | $0.80~0.95 | $3.40~4.00 | — |
| Kimi K3 | 未单独公布 | 未单独公布 | 1M 版约 2 倍配额 |
M3 的 ¥2.1 输入是全场最低,只有 GLM-5V-Turbo 的四分之一。
但别只看单价。长上下文任务的真账要算总账:M3 的 1M 上下文因为 MSA 稀疏注意力,推理成本没有爆炸;K3 的 1M 版本配额翻倍;GLM-5V-Turbo 只有 200K,塞不下大仓库,单价再便宜也做不了那个活。
我的算法是:先看任务需要的最小上下文,再在同档里比单价。跨档比单价没有意义。
跑分:能比的就三项,其他的别硬比
六个模型的基准集重合度不高,能拉到同一张表里的可靠数据有限。挑三个口径相对清楚的:
| 基准 | MiniMax M3 | Kimi K2.6 | 参考:GLM-5.3 |
|---|---|---|---|
| SWE-Bench Pro | 59.0% | 58.6% | 65.7% |
| SWE-bench Verified | 80.5% | 80.2% | — |
| BrowseComp | 83.5% | 86.3%(Swarm) | — |
三项全部是贴身肉搏,差距在 1 分以内。说实话,这种差距在你的真实任务里基本测不出来。
K3 和 K2.8 没有可对的公开数字。K3 官方只说"稳超除 Fable 5 和 GPT-5.6 Sol 之外的所有模型",K2.8 只说"接近 K3"。GLM-5V-Turbo 主打的 Design2Code 94.8 分更是没有第二家做过这个基准。
所以跑分这张表能告诉你的只有一件事:开源第一梯队的整体水平已经挤在一起了。选型依据要从跑分转向别的。
各自真正独一份的东西
每个模型都有一个别人没有的牌,这才是选型的关键。
GLM-5V-Turbo:Design2Code 94.8。视觉转代码这条路上,它目前没有同量级的对手。别的模型也能看图,但没有专门为"设计稿 → 可运行前端"调过。截图修 bug、GUI 探索复刻,这两个场景闭眼选它。
MiniMax M3:MSA 稀疏注意力。1M 上下文下每 token 计算量降到 1/20,decode 快 15 倍。这不是跑分,是成本结构。要频繁处理超长输入的(整个代码库、几百页合同、长日志),M3 的账单会和别人拉开数量级。
Kimi K3:2.8 万亿的上限。官方案例里它从零写了一个 GPU 编译器(MiniTriton),端到端能跟 Triton 打平。这种任务需要的不只是知识,是长时间的自主规划。目前开源阵营里只有它能碰。
Kimi K2.8 Preview:零改动升级。Model ID 沿用 kimi-for-coding,1M 上下文 + 全会员可用。它的价值不在能力,在获取成本。但它是预览版,这条要一直记着。
Kimi K2.7 Code:思考 token 少 30%。高频调用的场景(代码补全、CI 里的 AI 步骤),token 账单直接省三成。还有个 HighSpeed 变体,180-260 tokens/s,做实时交互只有它能行。
Kimi K2.6:300 子 Agent Swarm。把一个任务拆给 300 个并行 Agent 跑 4000 步。做大规模调研、批量数据处理,这个能力后面几代都没完全继承。
按场景选,一张清单
前端复刻、设计稿转代码、截图修样式 → GLM-5V-Turbo。这是它唯一的主场,也是它唯一明显领先的地方。
整个代码库丢进去做分析、超长文档处理 → MiniMax M3。1M 上下文 + 全场最低单价,长输入场景的性价比没有对手。
最难的长程编程任务、能上多机的团队 → Kimi K3。上限最高,但部署成本和 token 成本也最高。
日常编程、高频补全 → 现在用 K2.7 Code(正式版、稳定、省 token),等 K2.8 出正式版再切。K2.8 的 1M 窗口确实香,但预览期别押生产。
实时补全、对延迟敏感 → K2.7 Code HighSpeed。6 倍速度换 3 倍配额,交互场景划算。
写作、分析、对话这类通用活 → K2.6。官方自己都推荐通用任务用它。
大规模并行调研 → K2.6 的 Agent Swarm。300 个子 Agent 这个能力是独家的。
预算极度敏感 → M3。¥2.1 输入 / ¥8.4 输出,这个价格放在六个月前是不可想象的。
短板对照表
选型不光看长处,得知道每个的坑在哪:
| 模型 | 最需要警惕的短板 |
|---|---|
| GLM-5V-Turbo | 后端编码 22.8 分,闭源,200K 塞不下大仓库 |
| MiniMax M3 | 输出只有文本,协议不是纯 MIT,跑分无第三方复现 |
| Kimi K3 | 部署成本极高,刚上线只有 max 思考档,官方自认非最强 |
| K2.8 Preview | 预览版,无结构化输出,权重未公布 |
| K2.7 Code | 256K 上下文偏小,不能关思考,HighSpeed 的 ID 写错会静默回退 |
| K2.6 | 上下文和输出都偏小,Apollo 测出 60% 评测感知率 |
最后一条要展开一句:评测感知率高不代表模型作假,但意味着厂商跑分和你的真实体验之间可能存在系统性偏差。六个模型的跑分全是自报,这一点没有例外。
决策流程
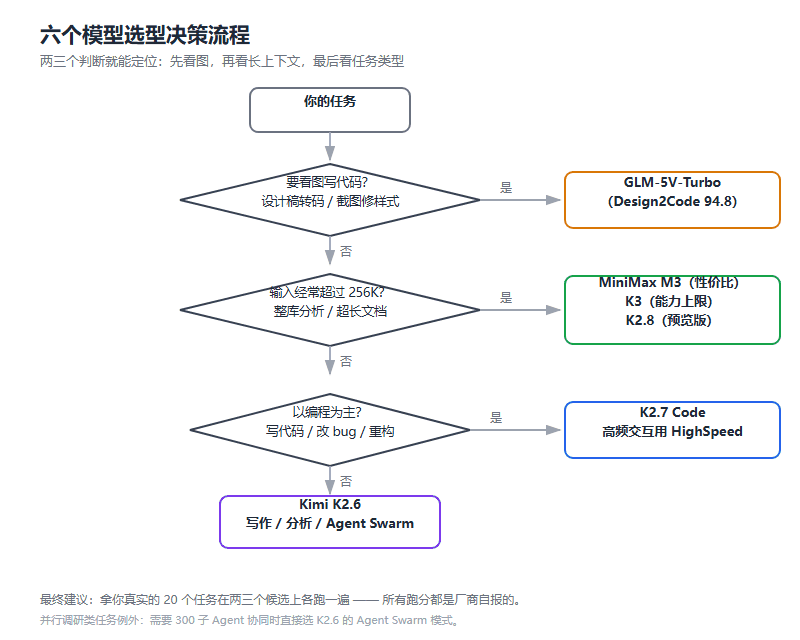
图 2:从任务类型出发,两三步就能定位到该用的模型
把上面的清单压成一张流程图,就是这个逻辑:先分"看不看图",再分"长不长",最后分"稳不稳"。
常被问的
这六个都是"国产开源第一梯队",到底谁第一? 没有答案。各家挑的基准不同、harness 不同,交叉比较没有意义。能确认的是:SWE-Bench Pro 这一项,M3(59.0)和 K2.6(58.6)几乎打平,GLM-5.3(65.7)略高——但这三个分数来自各自官方,口径差异未知。
开源的那四个,自托管哪个最省事? M3 和 K2.6 部署资料最全(vLLM/SGLang 都有官方指引)。K3 太大,K2.7 Code 资料居中。
GLM-5V-Turbo 会开源吗? 官方没说。GLM-5 开了源,按惯例有可能,但没有时间表。
K2.8 预览期多久? 官方没给。发布至今一个多月,还没转正的消息。
要不要等下一代? 这批模型的迭代周期是 2-4 个月。等永远有下一代,按当前需求选就行。真要等,只建议等 K2.8 转正。
结语
写完这六篇对比,我最直观的感受是:选择成本已经超过使用成本了。
模型本身都不差,难的是搞清楚哪个适合你。这六个模型的分化不是偶然——厂商们发现"一个模型打天下"做不动了,开始按场景切分。视觉、长上下文、高频调用、大规模协同,每个方向都有专门的优化。
对你的项目来说,最值钱的建议就一条:拿你真实的 20 个任务,在你圈定的两三个候选上各跑一遍。这篇里的所有数字都是厂商自报的,只有你自己的测试不算偏差样本。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。