
一句话总结:GLM-5.3-Flash 是智谱 8 月底开源的多模态模型,3200 亿参数、1M 上下文、纯 MIT 协议,输入 8 毛、输出 2 块 8。Artificial Analysis 智能指数 57,单项任务成本 4.5 美分——这个价位放在半年前是科幻片。
第一眼看到价格我是不信的。
每百万 Token 输入 0.8 元、输出 2.8 元。对比一下:同门的 GLM-5.3 卖 8 块和 28 块,Claude Opus 4.8 是它的 40 倍。通常这种价格对应的模型,能力也就"能聊天"的水平。
但 GLM-5.3-Flash 的官方定位是"部分能力对齐 Claude Opus 4.8"。
这话得拆开验证。
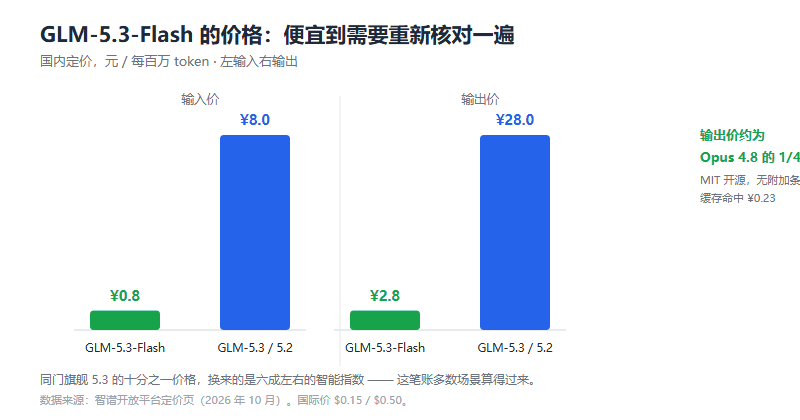
图 1:价格是旗舰的 1/10,第三方智能指数却只差 6 分
先看规格
| 项目 | 参数 |
|---|---|
| 总参数 | 3200 亿 |
| 每 token 激活 | 180 亿 |
| 上下文 | 1M |
| 模态 | 图片、视频、文件、文本(原生多模态) |
| 开源协议 | MIT |
| 国内价 | ¥0.8 / ¥2.8 / 缓存 ¥0.23(每百万 token) |
| 国际价 | $0.15 / $0.50 |
| 发布时间 | 2026 年 8 月 26 日 |
三个点值得单独说。
它是 GLM-5 系列第一个原生多模态。图片、视频、文件直接进,不是在文本模型外挂个视觉适配器。预训练语料 30 万亿 token,从第一天就是混合模态训练。
MIT 协议,没有任何附加条款。同门的 GLM-5.3 用的是自定义 License(超大 MaaS 运营商要过安全审查),Flash 是纯 MIT。想商用、想改、想再分发,不用问任何人。
它的出身有点特别。上线之前,它以 Ox-Alpha 的代号在 OpenCode 和 OpenRouter 上匿名跑了很久的大规模测试。这种"先匿名挨打再发布"的做法,比发布后出问题再修要体面。
为什么能这么便宜
架构上有三处省钱的设计:
混合稀疏 + 线性注意力。智谱称这是首个把两者结合的开源前沿模型。线性注意力管局部依赖,稀疏注意力管全局检索。
IndexPool。四个索引器的键向量加权池化成一个,1M 上下文下的索引开销直接降下来。
模型瘦身。对比旗舰 GLM-5.3:注意力运算少 3.01 倍,KV 缓存小 4.44 倍,激活参数从 32B 砍到 18B,层数从 92 降到 45。
结果就是:能跑,还跑得快,还便宜。
能力到底什么水平
官方给的核心数据是 Artificial Analysis 智能指数 57,每任务成本 $0.045。智谱自己的说法是:"这样的水平过去只有在约 10 倍成本下才能达到。"
第三方渠道确认了 57 这个指数(用同系列模型作代理测得),这个数字在开源阵营里排得进前列。作为对比:GLM-5.2 是 51,DeepSeek V4 Flash 是 50。
编程基准上,官方公布的数字:DeepSWE v1.1 拿 63.4(GLM-5.2 是 46.2,这里注意 5.3-Flash 的后训练继承了 5.3 的成果),AutomationBench 48.8。内部 Z.ai Code Bench 在 max 档位拿 29.0,紧贴 Claude Opus 4.8 的 29.5。
"对标 Opus 4.8"这个说法,准确讲是编程体感对标,不是全面对标。世界知识、复杂推理这些维度,320B 和闭源旗舰还是有差距。但 8 毛钱的价格,要求不能太高。
什么场景该用它
大批量任务。价格是它的核心竞争力。批量改代码、批量生成测试、批量摘要,token 消耗大的活,用 Flash 的成本是旗舰的十分之一。省下的钱够你再跑十遍。
多模态但不追求极致。看图写描述、视频内容提取、文件问答,这些活 Flash 都能干。要做像素级设计稿复刻那种,还是得 GLM-5V-Turbo。
私有化部署。MIT 协议 + 320B 参数,比 744B 的旗舰好部署得多。30B 级的 GLM-4.7-Flash 更小,但能力差一截,中间这个档位正好。
夜间批处理。智谱的建议场景里就有这条:质量优先、成本敏感、不赶时间的任务放夜里跑。
短板
速度不算快。AI 测的输出速度大约 47 tokens/s(官方提速前),在同尺寸模型里偏慢。要快可以看后来出的 FlashX,200 tokens/s,价格约 2.5 倍。
长上下文的细节保持一般。1M 窗口能塞,但超长文档后半段的细节把握会下降。这是稀疏注意力方案的通病,不是它一家的问题。
基准全是自报。AA 指数 57 有第三方背书,但 DeepSWE、AutomationBench 这些是智谱自己跑的。
跟旗舰的差距真实存在。GLM-5.3 的复杂工程理解、疑难问题定位,Flash 替代不了。雪球上有个说法我觉得挺准:Flash 更擅长执行明确的任务,旗舰更擅长判断任务该怎么做。
怎么用
API 在智谱开放平台(bigmodel.cn),也上了 OpenRouter 等国际渠道。
自托管:权重在 Hugging Face(zai-org/GLM-5.3-Flash),transformers 和 vLLM 都支持。
第三方平台:Cursor 已上线,千问 AI 平台也能调。
常被问的
它跟 GLM-5.3 什么关系? 同一代,Flash 是缩小版。基座能力继承了 5.3 的后训练成果,参数砍到 320B,加了原生多模态。可以理解为"5.3 的性价比特供版"。
FlashX 又是什么? 9 月 18 日发布的提速版,200 tokens/s,能力同 Flash,价格约 2.5 倍。对延迟敏感选它,对成本敏感选原版。
真商用没问题吗? MIT 协议没有任何限制。唯一建议是自己跑一遍基准,别全信厂商数字。
1M 上下文实际能用多少? 技术上支持,但建议 256K 以内。超长文档的后半段细节保持是这个价位模型的普遍弱项。
最后
GLM-5.3-Flash 让"旗舰能力的零头价格"这件事变成了现实。
它不是最强的模型,但它可能是性价比最高的开源多模态模型。AA 指数 57 配 $0.045 的任务成本,这个组合在开源市场里目前找不到第二个。
如果你的任务量大的话,算一笔账:同样的活用旗舰跑和用 Flash 跑,一年的差价可能够雇半个人。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。