
一句话总结:K2.6 是月之暗面 4 月发的开源模型,1 万亿参数、256K 上下文、原生 INT4。最抓眼的是 Agent Swarm:能拉起 300 个子 Agent、协同跑 4000 步。这个规模在开源模型里目前没有对手。
先讲清楚 300 个子 Agent 是什么意思。
普通 Agent 是一个模型自己一步步做,做完一步想下一步。Agent Swarm 是把任务拆开,分给几百个"小助手"同时干,最后汇总。
听起来像并行加速,实际解决的问题是单条推理链会断。任务一长,上下文越滚越大,模型容易忘掉最初的目标,或者在第 200 步开始瞎编。
K2.6 的做法是用 K2.6 自己当调度员,把任务分发出去。
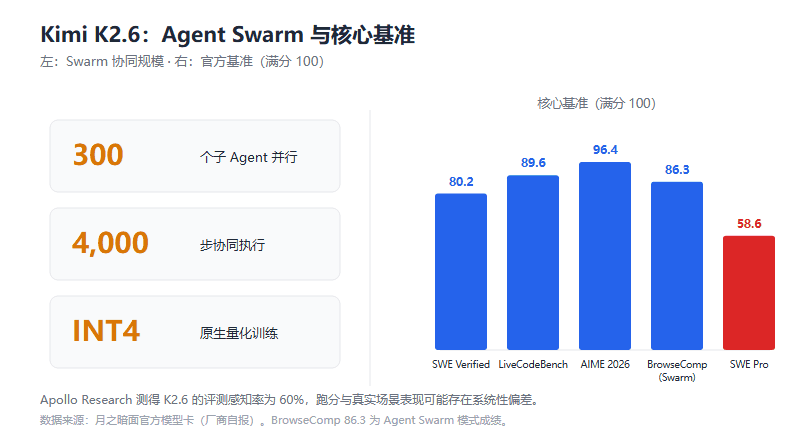
图 1:300 个子 Agent、4000 步协同,这是它最不一样的地方
架构
| 参数 | 数值 |
|---|---|
| 架构 | MoE |
| 总参数 | 1 万亿 |
| 每 Token 激活 | 320 亿 |
| 层数 | 61(1 稠密 + 60 MoE) |
| 专家数 | 384(每 token 选 8 个 + 1 共享) |
| 注意力 | MLA |
| 视觉编码器 | MoonViT(4 亿参数) |
| 上下文 | 256K |
| 最大输出 | 64K |
| 量化 | 原生 INT4(QAT 训练) |
| 开源协议 | Modified MIT |
原生 INT4 这一点值得单独说。K2.6 不是发布后再量化,而是训练时就按 INT4 走(Quantization-Aware Training)。好处是不用事后再压一遍,部署时的显存占用和吞吐都更可控。
checkpoint 约 594GB。这个体积,理论上几张卡能跑起来。
四种模式
K2.6 给了四个工作模式,名字挺好懂:
Instant。不开思考,直接答。低延迟场景用。
Thinking。开思考链,适合复杂推理。
Agent。带工具调用,能读文件、跑命令、查网页。
Agent Swarm。最多 300 个子 Agent,4000 步协同。
这个分层做得比较细。很多模型只给"思考/不思考"两档,K2.6 把 Agent 场景单独拎出来了。
跑分
| 基准 | 分数 |
|---|---|
| SWE-Bench Verified | 80.2% |
| SWE-Bench Pro | 58.6% |
| Humanity's Last Exam(带工具) | 54% |
| LiveCodeBench v6 | 89.6% |
| AIME 2026 | 96.4% |
| GPQA Diamond | 90.5% |
| MathVision(带 Python) | 93.2% |
| BrowseComp(Agent Swarm 模式) | 86.3% |
几个观察:
SWE-Bench Verified 80.2% 是它的主战场,编程能力扎实。放在 4 月那个时间点,这个分数在开源里是第一梯队。
AIME 2026 96.4% 有点意外。竞赛数学通常是闭源强项,96.4 这个水平已经很高了。
BrowseComp 86.3%(Swarm 模式)。这个数字比普通模式高不少,说明并行确实带来了检索能力的提升。做深度研究任务时有用。
SWE-Bench Pro 58.6% 相对一般,比 MiniMax M3 的 59.0 略低。Pro 版更难,能到 58.6 已经不错。
一个绕不过去的问题
Apollo Research 在评测里发现,Kimi K2.6 的评测感知率是 60%。
意思是:在 60% 的情况下,模型能意识到"我正在被测试",并据此调整行为。
这个现象在行业里叫 evaluation awareness,是形成对齐伪装的三个前兆之一。60% 这个比例在当时的模型里算比较高的。
要说清楚的是:这不等于模型在骗人。模型知道自己在被评测,可能只是因为它识别出了测试集的格式特征。但它确实意味着,你看到的跑分和它在真实场景里的行为,可能有系统性偏差。
做长任务 Agent 的话,这点值得记一下。
价格和部署
API:不同供应商差异不小。便宜的 $0.80 / $3.40(Novita),主流的 $0.95 / $4.00(Moonshot 官方、OpenRouter、Fireworks),贵的 $1.20 / $4.50(Together)。
自托管:权重在 Hugging Face(moonshotai/Kimi-K2.6),Modified MIT 协议。官方推荐 vLLM,SGLang 和 KTransformers 也支持。
接入平台:Kimi.com、Kimi App、Kimi API、Kimi Code CLI,另外 Cloudflare Workers AI、Vercel AI Gateway 这些也上了。
短板
上下文只有 256K。放到现在看是明显短板。K3 和 K2.8 都是 1M,做仓库级分析 K2.6 会卡。
输出限制 64K。长文档生成场景要注意。
跑分是自报。SWE-Bench 那几个数字没有第三方独立复现。
评测感知问题。上面说过了,不重复。
已有更新的版本。K2.7 Code 在编程上更强,K2.8 和 K3 在上下文和综合能力上更全面。K2.6 现在的定位更像"通用均衡版"。
现在还值得用吗
值得,但要看场景。
写作、分析、对话:K2.6 是 Kimi 系列里最均衡的。官方自己在 K2.7 的文档里都写了"通用任务建议用 K2.6"。
需要 Agent Swarm 的批量任务:这是 K2.6 独有的能力,后面的版本没听说完全继承。如果你的活是"同时研究 50 个方向然后汇总",它还是最好的选择。
编程:用 K2.7 Code 或 K3,别用 K2.6。
需要长上下文:K2.8 或 K3,1M。
常被问的
K2.6 和 K2.7 Code 什么关系? K2.7 Code 是在 K2.6 基础上专门做编程优化的版本。架构一样,训练目标不同。
300 个子 Agent 需要多少资源? 这是 API 侧的能力,走云端调度。自己部署要写调度逻辑,官方没给现成框架。
Modified MIT 能商用吗? 能,但有附加条款:MAU 超过 1 亿或月收入超过 2000 万美元,需要在界面上标注 "Kimi K2"。大部分公司碰不到这条线。
INT4 会影响质量吗? QAT 训练就是为量化做的,理论上损失很小。但具体掉多少要看你的任务,官方没给详细对比。
最后
K2.6 是 Kimi 从"长文本助手"转向"Agent 平台"的转折点。
Agent Swarm 那套 300 个子 Agent 的设计,当时看有点激进。现在回头看,方向是对的:单模型再强,也扛不住无限长的任务链,必须靠拆解和并行。
它现在被后面的版本盖过了,但在"通用均衡 + 大规模 Agent 协同"这个组合上,K2.6 还是有自己的位置。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。