
一句话总结:GLM-5V-Turbo 是智谱今年 4 月发的多模态编程模型,7440 亿参数、200K 上下文,主打"看懂画面再写代码"。Design2Code 拿到 94.8 分,但这个数字得拆开看。
先说结论:这模型有意思,但不是所有人都该用。
智谱把 GLM-5V-Turbo 定义成"多模态 Coding 基座"。翻译一下,就是模型能直接吃图片、视频、设计稿,然后吐代码,中间不需要你先用文字把画面描述一遍。
这个思路挺对。过去做前端复刻,你得写"左边一个侧边栏宽度 240px,右边卡片三列布局,圆角 12px……",写得再细也总有遗漏。现在直接把 Figma 截图丢进去。
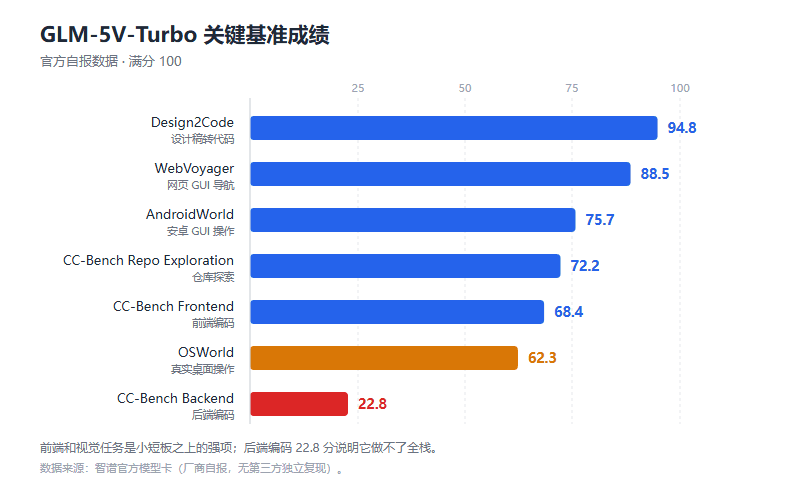
图 1:Design2Code 94.8 是它的招牌成绩,但下面几项就没这么好看了
规格不算大,价格倒是没涨
| 项目 | 参数 |
|---|---|
| 总参数 | 7440 亿(MoE) |
| 每 Token 激活 | 400 亿 |
| 上下文 | 200K |
| 最大输出 | 128K |
| 输入模态 | 图片、视频、文本、文件 |
| 输出模态 | 文本 |
| 价格 | $1.20 输入 / $4.00 输出(每百万 token) |
| 发布时间 | 2026 年 4 月 2 日 |
744B 这个体量,在今年的多模态模型里算中等。但它的激活只有 40B,推理成本能压住。
价格是它比较聪明的地方。跟纯文本的 GLM-5-Turbo 一个价。加了视觉能力不加钱,这个信号很明确:智谱觉得视觉是标配,不该额外收费。
跑分怎么看
官方给了一堆数字,我挑几个关键的:
Design2Code 94.8。这个基准测的是"给设计稿生成代码",对比 Claude Opus 4.6 的 77.3,领先 17.5 分。差距不小。
但说实话,这个数字我保留意见。Design2Code 的评测集里,很多页面结构相对规整,视觉相似度和代码正确性是分开算的。94.8 分不代表生成的代码能直接上生产,只代表"长得像"。
WebVoyager 88.5,AndroidWoRLd 75.7。这两个是 GUI 操作基准,测的是模型能不能真的去点网页、点 App。88.5 说明浏览网页找信息这块确实强。
OSWorld 62.3。这个明显弱于前面几项,而 OSWorld 恰恰是最接近"真人用电脑"的测试。有个细节:Claude Opus 4.6 在 OSWorld 和 Flame-VLM-Code 上反超了它。所以"全面领先"这个说法站不住。
CC-Bench-V2 三项:Backend 22.8、Frontend 68.4、Repo Exploration 72.2。前端和仓库探索都还行,后端只有 22.8 分。这个分数说明它继承了 GLM-5 系列"前端强、后端弱"的老毛病,加视觉也没改善。
三个真能用上的场景
截图报错,直接改。这是我觉得最实用的。页面样式崩了,截个图丢进去,它能识别出"这个按钮和下面卡片重叠了""这个颜色比设计稿浅了两个色阶",然后给修复代码。以前你得自己找是哪一行 CSS 的问题,现在省了这一步。
设计稿转工程。给一张高保真稿,输出可运行的 ReAct 或 Vue 工程。注意是"可运行",不是"像素级一致"。要真做到像素级,还是得人工调。
GUI 自主探索。配合 Claude Code 或 OpenClaw 这类 Agent 框架,模型能自己打开目标网站,翻页面、记跳转关系、截图,然后照着生成代码。这条路径比"给一张静态图"更接近真实需求,因为很多页面的交互逻辑静态图看不出来。
短板得说清楚
第一,它是闭源的。官方文档只给了 API 入口,没有开放权重。有第三方媒体说权重上了 Hugging Face,但我在智谱官方文档里没找到对应说明,这事存疑。想私有化部署的,现在别指望。
第二,视频能力偏弱。虽然标称支持视频输入,但官方演示里几乎全是图片场景。视频这块目前更像"支持"而不是"擅长"。
第三,后端能力没跟上。22.8 分的 Backend 摆在那,做全栈项目它帮不上太多忙。
第四,跑分全部来自官方。没有第三方独立复现。Design2Code 94.8 这个数字,等有人用同一套 harness 跑一遍再说。
怎么用
API 在智谱开放平台(bigmodel.cn),国内和国际版都能调。产品端可以在 Z.ai 官网直接试多模态对话,或者用 AutoClaw 体验 Agent 视觉能力。
Coding Plan 用户现在可以申请优先体验,后续会正式纳入 GLM Coding Plan。
几个常被问到的
它和 GLM-5 什么关系? GLM-5 是纯文本基座,744B 开源(MIT)。GLM-5V-Turbo 是在这个基座上加视觉,但改成了闭源 API 形态。同参数不同策略。
200K 上下文够用吗? 前端项目够。整个仓库一次性喂进去做重构,不够。要那个得看 Kimi K3 或者 MiniMax M3 的 1M。
跟 Claude 比选哪个? 纯视觉转代码,GLM-5V-Turbo 的 Design2Code 分数更高。但如果是复杂工程改造,Claude 那套工具链(Claude Code)成熟度还是更好。
会开源吗? 官方没说。以智谱的惯例(GLM-5 开源了),有可能,但目前没有时间表。
最后
GLM-5V-Turbo 解决的是一个很具体的问题:让模型少一道"用文字描述画面"的中间环节。这个方向我认为是对的,因为描述本身就是信息损失。
但它现在的定位更像"前端专用工具",而不是通用编程模型。做设计稿还原、截图修 bug、GUI 自动化,它值得试。做后端服务、复杂系统重构,还是拿别的模型。
价格跟纯文本版持平这一点,如果你本来就在用 GLM-5-Turbo,等于免费多了个视觉能力。这个买卖不亏。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。