
一句话总结:Kimi K3 是全球首个开源的三万亿级模型,2.8 万亿参数、1M 上下文、原生视觉。官方自己承认整体还落后 Claude Fable 5 和 GPT-5.6 Sol,但稳超其他所有模型。这种坦诚在发布稿里不多见。
月之暗面这次很实在。
发布公告第三段就写了:「虽然 Kimi K3 的整体表现仍落后于最强的闭源模型 Claude Fable 5 和 GPT-5.6 Sol,但它在我们的整套评测中展现出前沿水平的能力,并稳定超过了其他所有模型。」
大多数厂商不会这么写。这也让后面的数字更可信一些。
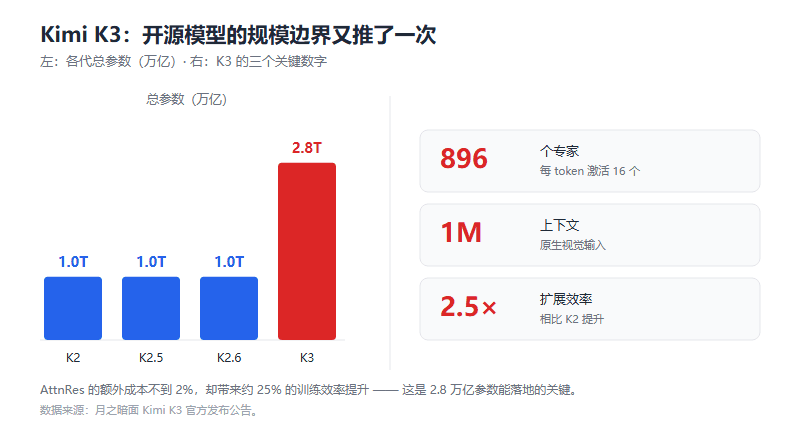
图 1:2.8 万亿参数,896 个专家里激活 16 个
2.8 万亿是什么水平
Kimi K3 总参数 2.8 万亿。按官方说法,这是"全球首个开源的三万亿级别模型"。
这个"级别"用词很讲究。2.8 万亿不到 3 万亿,但按量级算是 3T 级。过去 12 个月里有 9 个月,开源模型的规模上限都是 Kimi 在推。这句话听着像自夸,但查下来确实是事实。
架构上做了两处改动:
KDA(Kimi Delta Attention),一种混合线性注意力。解决的问题是信息在超长序列里怎么流动。标准注意力在长序列下会被稀释,KDA 用线性注意力补这个短板。
AttnRes(注意力残差)。这个改善的是信息在深层模型里的流动。有个数据挺有意思:AttnRes 增加的额外成本不到 2%,但带来约 25% 的训练效率提升。对万亿参数的模型来说,这个杠杆比很高。
MoE 方面,稀疏度进一步放大:896 个专家里激活 16 个,配 Stable LatentMoE 框架。加上训练方法和数据配方的优化,整体扩展效率比 K2 提升约 2.5 倍。
简单说,同样的算力,能换来的智能多了 1.5 倍。
规格
| 项目 | 参数 |
|---|---|
| 总参数 | 2.8 万亿 |
| 专家数 | 896 个,每 Token 激活 16 个 |
| 上下文 | 1M |
| 模态 | 文本、图片、视频输入 → 文本(原生视觉) |
| 思考强度 | 发布时仅 max,后续加 low / high |
| 开源 | 是,2026 年 7 月 27 日前发布完整权重 |
| 发布时间 | 2026 年 7 月 16 日 |
有个细节:发布时默认思考强度是 max(极致),low 和 high 两档要等后续更新。这意味着刚上线时所有请求都是最高推理强度,token 消耗会比较大。
它到底强在哪
长程编程。官方描述是"在最少人工监督下,能维持长时间工程会话,导航大型仓库,编排终端工具"。这几个词对应的都是真实痛点。让模型写一个函数不难,难的是连续工作几小时还不跑偏。
两张案例值得看:
第一个是 GPU kernel 优化。每个模型独立在相同沙箱里工作,最多 24 小时,任务是分析、重写、基准测试四个 kernel(涉及 AttnRes、KDA 和一个 512 头维度的 MLA kernel),跨 NVIDIA Hopper 和另一家厂商的 GPGPU。K3 的表现和 Fable 5 接近,明显超过 Opus 4.8、GPT-5.6 Sol 和 GPT 5.5。
有个细节我觉得比分数更重要:在 K3 开发的后期,早期版本的 K3 承担了团队大部分 kernel 优化工作。模型参与优化自己的底层算子,这个闭环已经跑通了。
第二个是 GPU 编译器。K3 从零写了 MiniTriton,一个类似 Triton 的紧凑编译器,包含自己的 tile 级 IR 层(架在 MLIR 上)、优化 pass 和 PTX 代码生成管线。在支持的 roofline 基准上,性能与 Triton 和 torch.compile 持平甚至更好,某些负载上还超过了 Triton。
而且它不只是写了几个孤立 kernel,而是完整的端到端编译器:DSL 前端、IR pass、PTX 代码生成、运行时,全都有。还能稳定训练 nanoGPT 到收敛。
说实话,这个案例比任何跑分都更有说服力。
视觉与编程结合。官方提到它在游戏开发、前端、CAD 这些场景能用截图和视觉信息优化代码。这条路子跟 GLM-5V-Turbo 类似,但 K3 的基座更大,复杂项目上的天花板更高。
短板
不是最强。官方自己说了,落后 Fable 5 和 GPT-5.6 Sol。这个"落后"不是谦虚,是事实描述。
部署成本高。2.8 万亿参数,即便稀疏激活 16 个专家,显存占用也远超普通团队的承受范围。想自己跑,得先算算硬件账。
思考强度单一。刚上线只有 max 档,简单任务也会深度推理,token 成本下不来。等 low/high 上线后会好一些。
中文评测数据少。官方公布的几乎都是英文基准。中文长文档、中文代码场景的实际表现,还得自己测。
公司和生态背景
K3 发布后 30 分钟登顶 Hugging Face 趋势榜第一。上线 48 小时请求量超出集群承载。
商业数据变化也很猛:ARR 3 月破 1 亿美元,5 月 2 亿,6 月中旬 3 亿,8 月超过 10 亿。B 端收入里 API 占 70%。
资本市场那边,月之暗面 7 月完成 35 亿美元 F 轮融资,估值 350 亿美元,之后又有约 500 亿美元估值的 IPO 前融资,计划 2027 年一季度在港股挂牌。
这些数字跟模型能力没有直接关系,但能说明一件事:K3 不是实验室玩具,是真的在产生收入。
怎么用
产品端:kimi.com、Kimi App、Kimi Work 桌面客户端、Kimi Code。
API:platform.kimi.ai。注意 1M 上下文和 256K 上下文的价格不一样,1M 版本(k3)消耗约两倍配额。
开源自部署:权重在 Hugging Face,7 月 27 日前发布完整版本。
常被问的
K3 和 K2.8 Preview 什么关系? K2.8 是接棒 K3 日常流量的轻量版,能力接近 K3 但思考更高效、价格更低。旗舰任务用 K3,日常开发用 K2.8。
2.8 万亿参数,普通显卡能跑吗? 不能。这个体量需要多机多卡。个人开发者建议直接用 API。
开源协议是什么? 需查 Hugging Face 仓库的 LICENSE,官方发布稿未明确说明。这点建议自己确认。
值得从 K2.6 升到 K3 吗? 如果你的任务是长程编程或者需要 1M 上下文,值得。日常对话和短任务,K2.6 或 K2.8 更划算。
最后
K3 的意义不在于"开源追上闭源"这种口号。它追上了大部分,但没追上最顶尖的那两个,官方也承认。
它真正证明的是另一件事:开源模型的规模天花板还能继续推。2.8 万亿不是终点,AttnRes 那个"2% 成本换 25% 效率"的结构性优化,说明架构层面还有空间。
对开发者来说,最实际的影响是:以前只有闭源 API 能做的长程复杂任务,现在有了一个可以自己部署的选项。虽然贵,但至少存在。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。