
一句话总结:MiniMax M3 是今年 6 月发的开源多模态模型,4280 亿参数、1M 上下文,自研 MSA 稀疏注意力把长上下文推理成本砍到 1/20。SWE-Bench Pro 59.0,是国产开源里少见的全能型选手。
1M 上下文这件事,行业里已经吹了一年多。但真正能用的没几个。
原因不复杂。标准注意力是平方复杂度,序列拉到 100 万 Token,算力需求能把任何一张卡吃干。所以大部分"1M 上下文"的模型,要么速度慢到没法交互,要么价格高到没人敢用。
MiniMax M3 的解法是自研一套稀疏注意力,叫 MSA。效果是:100 万上下文下,每 token 的计算量降到上一代的 1/20。
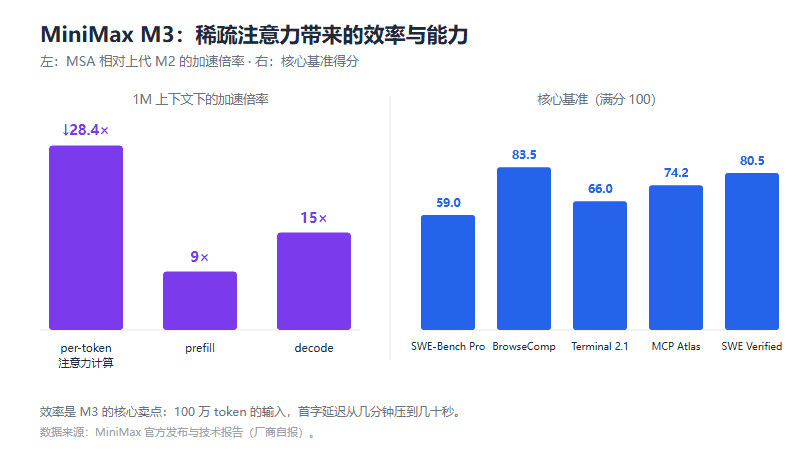
图 1:MSA 在 1M 上下文下把每 token 注意力计算降了 28.4 倍
这套注意力到底怎么省的
MSA 建立在 GQA(分组查询注意力)之上,分两条路走:
一条叫 Index Branch,很轻,负责给所有 KV 块打分,然后为每个查询组挑出最相关的 Top-k 块。另一条叫 Main Branch,只在选中的块上做精确注意力计算。
有个细节我觉得挺关键:局部块永远保留,不管它得分多低。这样能保证最近上下文的信息不丢。很多稀疏注意力方案就栽在这,稀疏过头导致模型忘了前半段说了什么。
官方论文里还有个数据。在一个 109B 的多模态模型上,MSA 在 1M 上下文下把每 token 注意力计算降了 28.4 倍,质量跟 GQA 持平。配上联合设计的 GPU kernel,H800 上 prefill 快了 14.2 倍,decode 快了 7.6 倍。
落到 M3 身上(对比上一代 M2):prefill 9 倍,decode 15 倍。
这个数字是什么概念?100 万 token 的输入,原来要等几分钟,现在几十秒能出第一个 token。
规格
| 项目 | 参数 |
|---|---|
| 总参数 | 4280 亿 |
| 每 token 激活 | 230 亿 |
| 专家数 | 128 个(top-4 激活)+ 1 共享 |
| 层数 | 60 |
| 上下文 | 1M(1049K) |
| 最大输出 | 512K |
| 模态 | 文本、图片、视频输入 → 文本 |
| 思考模式 | enabled / adaptive / disabled 三档 |
| 国内价 | ¥2.1 输入 / ¥8.4 输出(每百万 token) |
| 开源协议 | MiniMax Community License |
| 发布时间 | 2026 年 6 月 1 日 |
18 个专家里选 4 个,加上 1 个共享专家。这个稀疏度比 Kimi K3 的 16/896 低不少,但激活量 23B 也不算小。
有意思的是它给了三档思考模式,中间那个 adaptive 是让模型自己判断要不要深度推理。这个设计比"开/关"两档更实用。简单问题不浪费 token,复杂问题自己会多想。
跑分:全能,但没有单项第一
SWE-Bench Pro 59.0%。这个基准测的是真实软件工程任务,很难。59.0 超过了 GPT-5.5 和 Gemini 3.1 Pro。放在开源阵营里属于第一梯队。
SWE-bench Verified 80.5%。这个基准相对简单些,80.5 算正常水平,比 K2.6 的 80.2 高一点点。
Terminal Bench 2.1 66.0%。终端操作能力。这个分数不算突出,GLM-5.3 在 2.1 上是 88.2,但两者评测口径可能不同,别直接比。
BrowseComp 83.5。网页信息检索,这个分数超过了 Claude Opus 4.7 的 79.3。做深度研究类任务时这个能力很值钱。
MCP Atlas 74.2。工具调用能力,说明接外部系统这块没问题。
还有个我觉得最有意思的:PostTrainBench 37.1,全球第三。这个测试是让模型在 12 小时内独立完成另一个模型的后训练全流程,包括数据合成、训练、评估、迭代。M3 排第三,前面只有 Opus 4.7(42.4)和 GPT-5.5(39.3),后面是所有其他模型。
这说明它不只会写代码,还能组织一整个研究流程。这个能力目前很少有模型具备。
数学这块有点出人意料
MiniMax 同时发了个叫 MaxProof 的推理框架。思路是让模型在推理时同时扮演生成者、验证者、修正者和排序者,对候选证明做群体搜索,最后用锦标赛选优。
结果:M3 配 MaxProof,IMO 2025 拿 35/42,USAMO 2026 拿 36/42。两个都超过人类金牌线。
竞赛数学一直是闭源模型的强项,开源模型能到这个水平,说明稀疏注意力没有拖累推理质量。
短板
它是多模态,但输出只有文本。图片、视频能看懂,不能生成。想让它出图,得接别的模型。
社区许可证有门槛。MiniMax Community License 不是纯 MIT,商用前得读一遍条款。不同来源对协议的描述有出入,有的写 Modified MIT,有的写 Community License,建议直接看仓库里的 LICENSE 文件。
跑分都是自报。SWE-Bench Pro 59.0 这个数字,目前没看到第三方用同一 harness 复现。
中文场景的评测偏少。官方给的几乎全是英文基准,中文长文档、中文代码注释这些没数据。
怎么用
权重在 Hugging Face 和 GitHub(MiniMaxAI/MiniMax-M3),transformers 4.52.4 以上,vLLM 0.24.0 以上。官方推荐参数 temperature=1.0、top_p=0.95、top_k=40。
API 走 MiniMax 开放平台,国内 ¥2.1/¥8.4 这个价格,在 1M 上下文的模型里算便宜的。对比一下:混元 Hy4 是 ¥6/¥18,GLM-5.3 是 ¥8/¥28。
如果你的场景是"把整个代码库丢进去做分析",M3 的性价比目前是最好的之一。
常被问的
M3 和 Kimi K3 怎么选? K3 参数大 6 倍多(2.8T vs 428B),上限更高,但部署成本也高得多。日常任务 M3 够用,要顶到能力天花板选 K3。
1M 上下文真的能跑满吗? 技术上可以,但要注意显存。全量 1M 需要多卡。单卡跑 128K-256K 是现实选择。
支持微调吗? 权重开源,理论上可以。官方没给微调脚本,得自己写。
最后
M3 让我改变了一个看法。之前我觉得"1M 上下文"更像营销数字,因为能用和好用是两回事。MSA 这套方案至少让"能用"这件事成立了。
它的定位也很清醒:不追求单项第一,追求"编程、Agent、长上下文、多模态"四项都不短板。对大多数团队来说,这种均衡比某个单项冠军更实用。
价格 ¥2.1 输入,是它最狠的地方。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。