
一句话总结:GLM-5.2 是 GLM-5.3 的基座模型,7530 亿参数、1M 上下文、MIT 开源。8 月那次著名的"后训练提升 50%"用的就是它。后辈光芒太盛,但它本身仍是编码成本极低、长上下文极稳的旗舰。
有个现象挺有意思:GLM-5.3 发布的时候,全网都在讨论"同一基座、后训练提升 50%"。所有人都在夸后训练,很少有人回头看那个基座本身。
基座就是 GLM-5.2。
说句实在话,我觉得它是智谱今年最被低估的模型。原因很简单:它发布的时候风头被抢了,它被超越的时候又成了"旧款"。但它现在还在智谱开放平台上正常卖,价格跟 5.3 一样,能力也够硬。
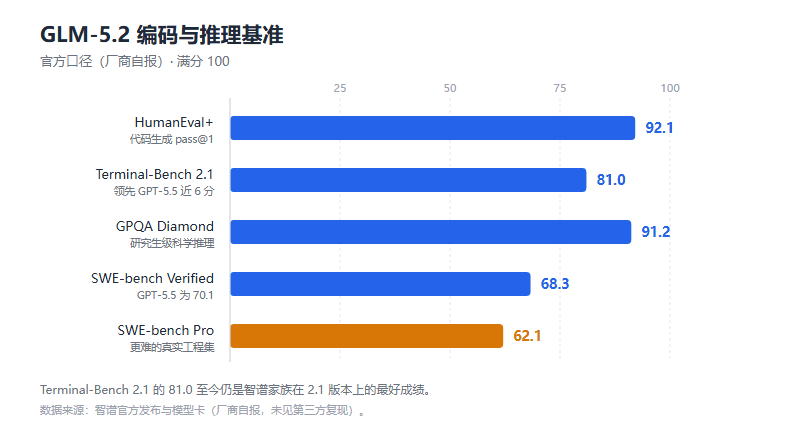
图 1:Terminal-Bench 2.1 拿 81.0,编码成本约为 GPT-5.5 的六分之一
规格
| 项目 | 参数 |
|---|---|
| 总参数 | 约 7530 亿 |
| 每 Token 激活 | 约 400 亿 |
| 上下文 | 1M |
| 开源协议 | MIT |
| API 价格 | $1.40 / $4.40(每百万 token,与 5.3 同价) |
| 编码任务成本 | 约 $0.5/百万(约为 GPT-5.5 的 1/6) |
| 后续 | 作为 GLM-5.3 的基座被后训练反超 |
发布的具体日期,我在智谱官方文档里没有找到明确记录,这点说明一下。能确认的是它早于 8 月 14 日的 GLM-5.3,属于 2026 年上半年发布的版本。
IndexShare:1M 上下文的省钱方案
GLM-5.2 首次引入了 IndexShare 架构,思路是把注意力计算拆成两步:
先快速扫一遍,标记哪些位置重要,这是索引。然后只对重要位置做完整注意力,这是检索。每 4 层共享同一个索引器,把额外开销压下来。
官方数据是 FLOPs 减少 2.9 倍。
实际体验如何?有开发者测过:输入一个 20 万行的代码库,等几秒出结果。50 页的英文白皮书丢进去问细节,能准确找到段落,没有出现"中间信息丢失"的老毛病。
但要诚实:超过 50 万 token 后,对文档后半段的细节把握会下降。1M 是标称值,不是无损值。
编码能力:两个基准很能打
Terminal-Bench 2.1 拿 81.0。这个数字比 GPT-5.5 高接近 6 分。这个基准测的是真实命令行环境里的操作能力——装依赖、调试、改配置、跑脚本。对做 Agent 的开发者来说,它比 HumanEval 那种"写个函数"的测试有参考价值得多。
SWE-bench Verified 68.3。略低于 GPT-5.5 的 70.1,差距 2 分以内。考虑到开源和六分之一的价格,这个交换是划算的。
SWE-Bench Pro 62.1、GPQA Diamond 91.2、HumanEval+ 92.1。全都是能拿得出手的数字。
注意一点:以上全部是厂商自报。81.0 那个数字我没有找到第三方复现。
一个非权威但有意思的对比
独立博主 Goldie Bench 做过一轮测试:拿同一组 47 个任务让 GLM-5.2 和 Google Gemini 3.6 Flash 各跑一遍,打分规则是能不能跑起来、贴合度、好看程度。
结果 GLM-5.2 以 27 比 20 赢了。
这个测试是个人行为,样本量小、打分主观,不能当权威结论。但它至少说明一件事:GLM-5.2 在"生成能跑的东西"这个维度上有真实力,不是纸面参数好看。
博主的原话里有个细节我记住了:GLM 做的 Voxel 城市是"最密集、最有细节的",带窗户的摩天楼和速度金币 HUD。这种完成度不是堆参数能堆出来的。
和 GLM-5.3 怎么选
这是最多人会问的。答案比想象中简单。
价格一样。开放平台上 5.2 和 5.3 同价,¥8 / ¥28。
能力上 5.3 全面更强。编程体感提升 50%,CyberGym 从 77.2 涨到 84.5,长程任务大幅进步。同价位没有理由选弱的。
那 5.2 还有什么用?自托管。两个都是 MIT 开源,权重都在 Hugging Face。但 5.3 的后训练使用了更长的强化学习,推理链更长,部署后的 token 消耗也更高。5.2 的推理路径更短,自家数据里它每任务输出 9.6 万 token(5.3 是 7.5 万,但那是在更强档位下)。
还有个使用习惯的问题:5.3 强制开启思考,不支持关闭。5.2 没这个限制。如果你的流水线里有需要快速响应、不需要深度推理的环节,5.2 反而更合适。
短板
被自家迭代盖过。这是它最大的"短板",虽然不是模型的错。新项目直接用 5.3,没有争议。
不支持视觉。纯文本模型。要图得配 GLM-5V 系列。
中文场景评测少。官方公布的基准几乎全是英文的。做中文业务的话,自己测。
1M 的后半段衰减。上面提过,50 万 token 以上细节保持会下滑。
常被问的
GLM-5.2 和 5.3 的基座完全一样吗? 官方明确说了是同一个基础模型,5.3 的所有提升来自后训练。参数、激活量、层数都没动。
现在还有必要了解 5.2 吗? 如果你只调 API,了解 5.3 就够了。如果你做模型研究(比如后训练能榨出多少提升),5.2 和 5.3 是一组绝佳的对照实验:同基座、不同训练量、结果差 50%。
它开源的权重是什么规格? MIT 协议,Hugging Face 上有 FP8 和 BF16。50 万行代码库的分析、长文档问答都有人跑通过。
Intel/AMD 的卡能跑吗? 有报道说英特尔至强 6 和 Gaudi 平台完成了适配,海光 DCU 做了 Day 0 适配。国产算力这块智谱做得比较全。
最后
GLM-5.2 的故事有点像球队里的中场:锋线进球了,没人记得传球的是谁。
它作为 GLM-5.3 的基座,见证了"后训练 Scaling"这个命题的验证过程。它自己也是一个能打的模型:Terminal-Bench 2.1 的 81.0 放在今天依然排得上号,六分之一的编码成本是实打实的。
如果你的场景恰好是"快速响应、不需要深度思考、成本敏感",别急着用最新的,5.2 可能正合适。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。