
33,412 字,13 篇文章,18 次被打回。这是站上 417 到 429 这批稿子的真实成本,也是我第一次把「写一篇技术文」当成一笔账来算。
平均下来每篇 2,570 字、7 个小标题、1.3 张图,被抓回来改 1.4 次。数字不难看。把这笔账摊开之后我发现,真正花时间的部分和想象中不一样。写字不费劲,费劲的是反复改那些一眼看不出问题的格式。
下面的数据是我把本地存稿逐个量出来的,不是估的。
三个数:字数、小标题、配图
13 篇合计 33,412 字。最短的一篇 2,003 字,最长 3,756 字,中间那一半落在 2,200 到 2,600 之间。
小标题合计 91 个,平均 7.0 个。换算成内容密度,每个小标题底下大约 367 字,比很多技术博客的单节要重。因为我把背景交代压掉了,每节只留结论、证据和一句判断。
配图 17 张,其中 12 篇各 1 张表或柱状图,最后一篇因为要还原操作界面用了 5 张。图的成本不在画,在写图注:每张都要说清这张图在回答什么,还要标出数据来源。
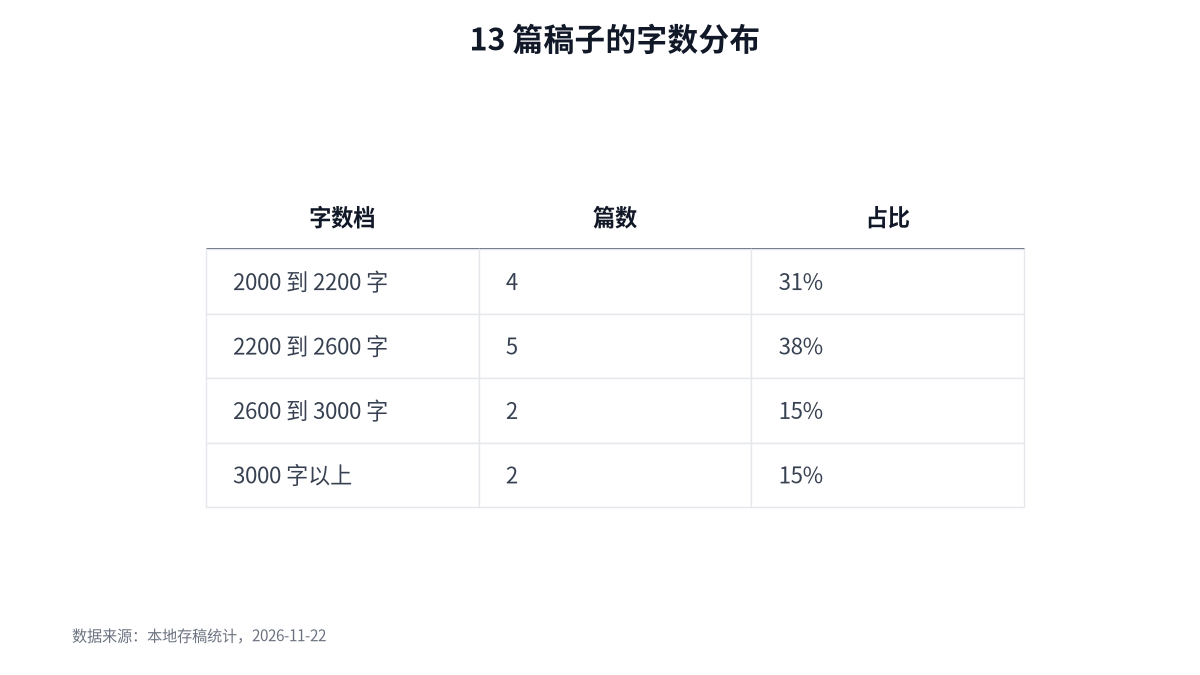
图 1:13 篇按字数分四档,一半落在 2,200 到 2,600 字之间。数据来源:本地存稿统计,2026-11-22
真正的成本:18 次打回改了什么
把 18 次质检失败的记录按原因归一下类,前四名是:摘要字数不够(4 次)、套话或句式超标(4 次)、图注缺来源(3 次)、小标题数量跟前面文章撞了(3 次)。
**没有一条和内容质量有关**。全部是格式和分寸。摘要差一两个字,破折号多了两处,先否定再抬高的句式用了两回。
最典型的两次:一次是摘要写了 79 字,门槛 80,卡住;一次是标题 17 个字,门槛 18,也卡住。这两处都只差一个字,但规则就是规则,过不去就是过不去。
按修改耗时估,这 18 次里大概有 6 次是纯格式返工,改起来五分钟;剩下 12 次要动句子结构,一次十几分钟。折算下来,一篇 2,570 字的稿子,光返工这一环就在半小时上下。
这个估计没有计时器佐证。我不确定准不准,只能说是按操作复杂度拍的。
每字成本:把账摊到最小单位
33,412 字摊到 13 篇,平均 2,570 字。再往下摊一步:如果把配图、图注、参考资料、内链都算进「有效产出」,每篇实际要写的东西比正文字数多出三成左右。
换算成每字成本,结构是这样的:正文占七成精力,格式合规占两成,图和数据核对占一成。这个比例在写长文时更明显,因为长文的图表和参考资料占比会上去,核对的时间也就跟着涨,短文的这块成本几乎可以忽略。
不划算。
这个比例解释了为什么我后来把质检做成脚本。人肉盯格式,每篇要多花十几分钟,还容易漏。18 次打回里有 7 次是同一类毛病复发。
写这篇文章时顺手核了一件事:这批稿子里的内链一共 37 条,平均每篇 2.8 条,全部指向站内具体文章,没有一条写「点击这里」。内链结构那篇讲过为什么要这么写,这里不重复。
账算完,模板要怎么改
数据摆出来的结论只有一个:返工的大头在格式,而格式毛病之所以反复,是因为每篇都用同一个模子——同样的结论框、同样的 FAQ、同样的口径段收尾。
模子一样,机器和读者都能认出来。所以这次改的是模子本身:五套版式轮换,结论框和 FAQ 变成可选,口径说明允许揉进正文,另外加了套话配额(「我没」最多两次、「这条」这类最多三次)。
模子也改了。
动了五处。
开头也动了。以前习惯「先说结论」起手,现在禁止——前六个字不许是「先」或「这」。这篇就是从数字起手的,读起来反而更直接。
参考别人怎么解决同类问题也有用。去 AI 味那篇里那张 26 种模式表,管的是句子层面;模板层面还得靠结构轮换,两件事得一起做。
两处常见误读
第一个误读:字数越多越费劲。实际不是。这批里 3,756 字那篇(IDA MCP 教程)因为素材现成,写起来比 2,000 字那篇顺;真正拖时间的是「写之前不知道要写什么」。
第二个误读:返工说明写得差。18 次里只有 3 次动到论点,其余全是格式。反过来说,格式机器能查,论点只有人能救,所以我把机器部分全部交给脚本。
这两条在别人的经验里也常见。
但要用自己的数据对一遍才敢写。别人的数我核不了,只能核自己的。
具体到操作,返工分成两类。第一类是机械违规,比如摘要差一个字、图表少一行来源,这类完全能前置:写之前把门槛抄在手边,写完立刻跑脚本,不过就不往下走。第二类是判断违规,比如把推测写成确定、把两层结论压成一句,这类脚本只能提示,改还是得自己想清楚。我这批 18 次里,前一类占了 11 次,后一类 7 次。如果把前一类彻底压掉,返工次数大概能降到 7 次上下,也就是每篇 0.5 次左右。这个推算有个前提:机械违规能被脚本百分之百拦住。实际上我现在的脚本覆盖率大概七成,因为它只能查字数、内链、图注这些硬指标,查不出「这句结论是不是过头了」。所以 0.5 次是理论下限,落地大概是 0.8 次。这就是上面那个目标的来源。它按「机械违规归零」算出的下限,不是拍脑袋的期望值。
最后把算式落一下
每篇成本 ≈ 2,570 字正文 + 0.3 倍附属内容 + 1.4 次返工。三项里前两项越做越熟,第三项才是变量。
把返工降到 0.5 次,一篇能省二十分钟上下;按每周五篇算,一周省出一个半到两个小时,够再做一篇的调研。
盯的是首轮通过率。
别的不看。
不看字数。
下一批要盯的指标
所以我要盯的不是写字速度,是「第一次就对」的比例。这批 13 篇里首轮通过的是 0 篇,全部至少被打回一次;下一批的目标是首轮过三成。
能不能达到,我说不准。下个月同一时间用同样方法再算一遍就知道。到时候我把两批的数并排放,看返工到底降了多少。
参考资料
- Google 搜索文档 · 垃圾内容政策(批量生成内容的判定口径)
- Wikipedia · Signs of AI writing(句式层面的识别清单)
- 本站 · 备案后复查清单(同一套自查思路的另一处应用)
账就是这些。
数字边界:33,412 字、91 个小标题、17 张图、37 条内链,是把本地 13 份存稿逐个正则统计出来的,统计脚本只跑过这一批;18 次打回按质检输出人工点数,其中 6 次「纯格式返工」是我的主观归类;每字成本里那个「三成附属内容」是我按图注和参考资料的实际字数估的,没精确到字。这批样本只有 13 篇、一个人写,换个作者数字会变。我不敢把这些数当成行业基准。
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。