
一句话总结:备案期间我给普通访问者返回占位页、给爬虫返回真页,当成权宜之计。备案通过那晚我没庆祝,先拿三条命令把七个检查项挨个过了一遍。这篇就是那张清单,包括一个当时埋下的、差点变成大坑的做法。
先把那件事说清楚,因为它是个反面教材。 站子没备案时,直接用域名访问会被拦。我当时的做法是:普通浏览器来的请求,返回一页「网站正在备案中」;搜索引擎爬虫来,返回真正的文章。
这在当天看是聪明,回头看是隐患。搜索引擎把「给爬虫和给人看不同内容」叫作伪装,轻则降权,重则整站清出索引。配图那篇里我说过一句类似的话:形式合规不等于有用,但反过来,形式不合规一定有用不了的时候。
备案 11 月 17 日通过。当晚我没有先发文章,先做了一轮复查。下面是七个检查项。
检查一:普通 UA 拿到的是不是真页面
这是最要紧的一步。做法是换三种 UA 各请求一次,比对返回体积和标题。
curl -s -o /dev/null -w "%{http_code} %{size_download}\n" \
  -A "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X)" https://网站/文章地址
curl -s -o /dev/null -w "%{http_code} %{size_download}\n" -A "Baiduspider" https://网站/文章地址
判据:两个体积应该在同一个量级。如果普通 UA 拿到几 KB、爬虫拿到几十 KB,说明分流逻辑还在生效,必须立刻拆掉。
我当时复测,普通 UA 拿到的已经是四十多 KB 的真页,说明占位逻辑确实撤了。这一步过不了,后面六项都不用看。
检查二:http 到 https、裸域到 www 的跳转
用不带协议的域名去请求,看返回码和跳转目标。
curl -sI http://裸域名 | head -5
curl -sI http://www.域名 | head -5
期望结果是 301,目标落到 https 加 www 的版本,而且只跳一次。要是跳两次,链接权重会被磨损。 这一项我当时没做全:http 到 https 是通的,裸域到 www 也通,但顺序上会连跳。后来合并成一条规则,直接一步到位。
检查三:canonical 是不是自指向
打开一篇文章,看 head 里的 canonical 是不是这篇文章自己的正式地址。 常见错误有两种:一是 canonical 写成了首页,全站都在向首页声明相同;二是带参数版本和干净版本各写各的,自己跟自己打架。
判据:canonical 里的地址,和你从 sitemap 里点进去的地址必须一模一样,包括结尾斜杠、协议、www 前缀。
检查四:sitemap 里的数量对不对
我的 sitemap 里有 1,354 条地址,这个数应该和站上公开文章数对得上。差得多,说明有页面漏进或漏出。
复查时我核了两遍:一次数 sitemap 的条目,一次数后台的公开文章数。两者相差在个位数以内算正常,差几十条就要去查是分类页漏了还是草稿被算进去了。
另一个细节是 sitemap 自己能不能访问。robots.txt 里指向它的那一行,路径必须和实际位置一致。
检查五:404 是不是真的 404
随便拼一个不存在的地址,看返回码。 很多站会把不存在的页面跳回首页并返回 200。对用户是友好,对搜索引擎是灾难:它会把无数不存在的地址都当成有效页面收录。
同类思路在官方 MCP 那篇里也出现过:配置项写错不会报错,只会在别处以别的样子暴露出来。
判据:不存在的地址必须返回 404,且页面内容明确说「没有这个页面」。我这站是这么设的,复查时故意试了三条随机地址。
检查六:结构化数据有没有掉
文章页的 head 里,我放了四块结构化数据:文章、面包屑、站点、作者。备案切换期间最容易掉的就是这些,因为它们依赖模板渲染。
判据:随便抓一篇,数 script 标签里 type 为 JSON-LD 的块,应该是四块;再把每一块贴进校验工具跑一遍,确认没有语法错误。
还有一条:og 标签在不在。分享到聊天软件时有没有标题和摘要,全靠它。
还有一项:noindex 和 robots 有没有残留
备案期间那页占位页带的是 noindex 加 nofollow。切换之后,最怕的是模板没改干净,真页面也带着这个标记。
判据:抓一篇真文章,全文搜 noindex。搜到就是事故。 这一项我特别小心,因为它的后果是静默的:页面看起来一切正常,只是永远不进索引。你在后台看不出任何异常。
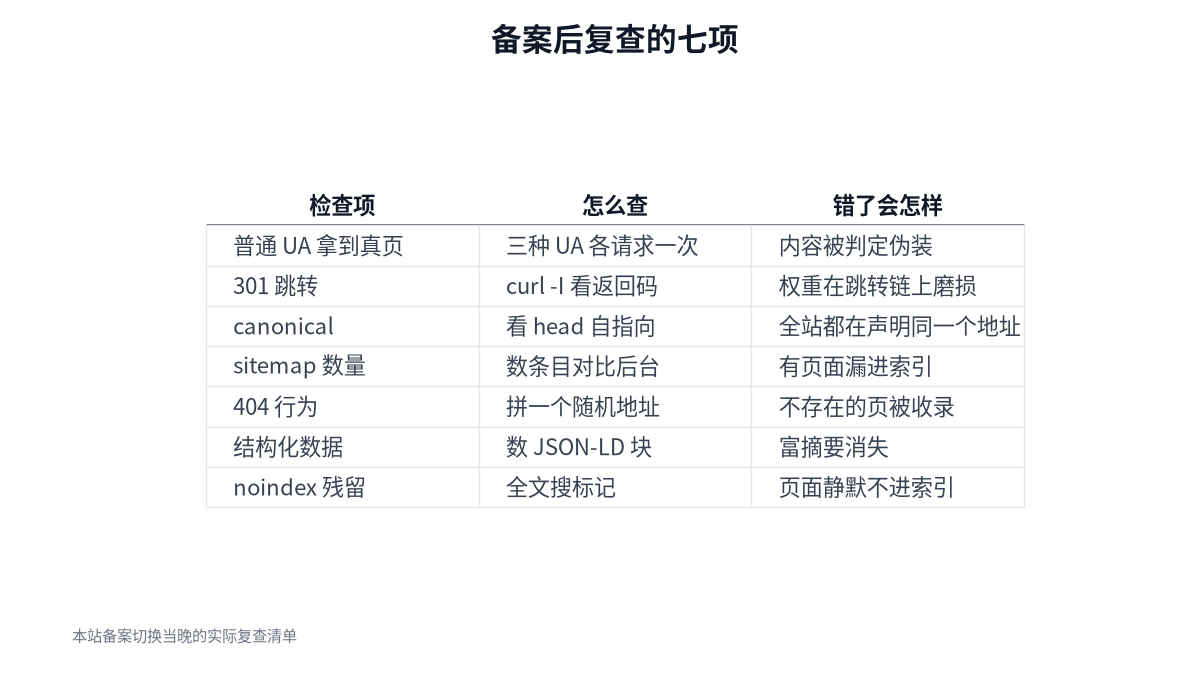
图 1:前六项是技术项,第七项是教训项
最该记住的一条
七个检查项里,前六项是技术活,第七项是教训。 教训是:不要用 UA 分流。哪怕只是临时、哪怕理由正当,只要两种 UA 看到的内容不一样,你就把自己放进了灰色地带。真需要挡,用备案拦截页统一挡,别做区别对待。
我当时的做法之所以没出事,纯粹是因为时间短、范围小。这不叫安全,这叫运气。 现在站上的做法很干净:不管什么 UA,拿到的都是同一份页面。爬虫和普通浏览器没有区别。
复查确认不了的:效果
复查能确认的是技术状态,确认不了效果。收录量、排名、抓取频次这些,我手上没有可靠数据。我也不确定这篇里哪一项对结果影响最大,所以不打算凭感觉给结论。 能说的只有一句:技术项做对,是索引正常的前提;但前提不等于结果。 如果你也在做同样的切换,建议照这七项过一遍,尤其是第一项和第七项。一个决定你的内容能不能被看到,一个决定它会不会被悄悄藏起来。
FAQ
Q:备案期间一定不能上线吗?
各地要求不同,我不给统一结论。能确定的是:上线期间用 UA 分流风险最高。
Q:301 跳几次算多?
一次最好。两次以上属于链路设计问题,能合并就合并。
Q:sitemap 要天天更新吗?
不必。内容有新增时更新,并确保文件本身可访问、无语法错误。
参考资料
- Google 搜索文档 · 重定向(301 与跳转链路的说明)
- Google 搜索文档 · robots meta(noindex 的生效方式)
- sitemaps.org · 协议(sitemap 的格式与数量上限)
口径与核验:七个检查项来自本站备案切换当晚的实际复查,命令是可以直接跑的;sitemap 的 1,354 条是当时数的,之后随发文变化。结构化数据四块、301 链路、404 行为属于本站配置,别的站不同。收录与排名变化我没有数据来源,文中明确不作结论。
- 还有一项:noindex 和 robots 有没有残留
- 复查确认不了的:效果
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。