
一句话总结:选模型不是比分数,是先回答四个约束问题——能不能私有、要不要长上下文、任务长短、预算多少,答案组合基本就锁定了这五款里的唯一一个。
前面分别写了 Qwen3.8、M3.1 Flash、MiniCPM5-2B、LongCat 2.5、Step5,也做了横评和成本账。这篇收个口:怎么把选择做成流程,而不是凭感觉。
四个问题,按顺序问
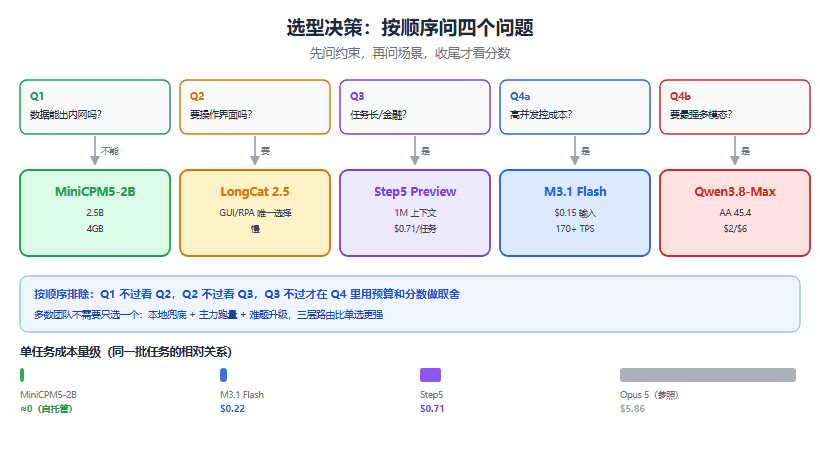
图 1:先问约束,再问场景,收尾才看分数
问题一:数据能不能出内网?
不能出,只有一条路:MiniCPM5-2B。2.5B、4GB 显存、Apache 2.0,笔记本就能跑。别纠结它的分数只有 12.5,私有化的第一要求是「装得下且合规」。
能出网,继续下一个问题。
问题二:任务是不是要操作界面?
要——比如点网页、填表单、跑 RPA、驱动桌面软件——选 LongCat 2.5。它在这五款里是唯一把 GUI 操作当核心能力的。代价是慢(单任务 30 分钟起)和 Preview 状态。
不要,继续。
问题三:任务长不长、是不是金融/研报类?
单次跑几十分钟、要吞几万到几十万 Token 的文档、或者做投研分析,选 Step5 Preview。1M 上下文、单任务 0.71 美元、金融评测强。有卡可以自建,没卡走 API。
不是,继续。
问题四:预算和并发怎么权衡?
- 高并发、成本第一、任务短(分类、抽取、摘要)→ M3.1 Flash,$0.15 输入、170+ TPS
- 要最强多模态、要最高分、预算宽松 → Qwen3.8-Max,$2/$6,AA 45.4
按预算再看一遍
| 场景 | 首选 | 单任务成本量级 |
|---|---|---|
| 端侧/离线/私有 | MiniCPM5-2B | 0(自托管,只有电费) |
| 批量跑量 | M3.1 Flash | $0.2 左右 |
| 长文档/金融 | Step5 Preview | $0.7 左右 |
| GUI/RPA | LongCat 2.5 | ¥2–8/百万 token,按量 |
| 旗舰多模态 | Qwen3.8-Max | $0.1 起,视任务 |
注意这张表是「量级」不是精确值。同样一个任务,输入输出比一变,成本能差好几倍,具体算法在成本那篇里。
五个常见误判
误判一:拿参数量当能力。 1.6 万亿的 LongCat 没进 AA 榜,2.5B 的 MiniCPM 数学能到 86.5。参数是容量,激活量和训练质量才是能力。
误判二:只看输入价。 输出价通常是输入的 3–4 倍,长输出任务光看输入价会算错一半。
误判三:把「开源」当「随便用」。 Apache 2.0、带商用门槛的自定义许可、仅 API,是三件事。Qwen3.8 的 2.4T 权重就有 1 亿月活和 5000 万收入两道门槛。
误判四:忽略思考成本。 M3.1 Flash 思考关不掉,简单请求也烧推理 token。报价单上看不出来,账单上很明显。
误判五:以为榜单能替代实测。 榜单是统一任务集,你的任务是另一回事。同一个模型在客服场景和代码场景的表现可以完全相反。
一个务实的组合方案
多数团队不需要只选一个。我自己的做法是三层:
- 本地兜底:MiniCPM5-2B 跑在开发机或边缘设备上,处理离线、涉密、低价值高频的小任务
- 主力跑量:M3.1 Flash 承担线上批量任务,成本可控、速度快
- 难题升级:Step5 或 Qwen3.8-Max 处理长文档、复杂推理、需要高质量输出的场景
三层之间用路由判断:任务长度、是否涉密、输出质量要求。这套结构比「选一个最强模型」便宜得多,也更抗风险。
常见问题
只能选一个,选谁?
看你的主业务。做产品跑量选 M3.1 Flash,做研究选 Step5,做端侧选 MiniCPM5,做视觉多模态选 Qwen3.8-Max。
Qwen3.8 和 Step5 都是旗舰,差在哪?
Qwen3.8 多模态更全、AA 分更高(45.4 vs 44),Step5 便宜一半、金融与长任务更专。要视觉选前者,要成本选后者。
LongCat 现在能用吗?
能用,但它还是 Preview,接口和定价都可能变,适合验证方向、不建议压核心业务。
小团队有必要自建吗?
除端侧场景,一般没必要。600B 级别的模型自建成本远高于 API,2.5B 的端侧模型才是自建真正划算的地方。
多久重新评估一次?
三个月。这五款里有一半是这两个月才发的,迭代速度决定选型结论的有效期很短。
结语
这五款的差别,本质是四个约束的不同排列:私有化、GUI 操作、长任务、预算。把这四个问题按顺序问一遍,答案基本是唯一的。
分数榜可以看,但别当决策依据。真正决定成败的是「这个模型的工作方式,跟你的业务形态契不契合」——这件事只有拿自己的任务跑一遍才知道。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。