
一句话总结:M3.1 Flash 同时提供 Anthropic 和 OpenAI 两套兼容端点,接入本身十分钟搞定,真正的坑在「思考关不掉」——默认 effort 是 max,不显式降档的话,简单请求也会按最贵的方式计费。
解读篇讲了这个模型的定位,这篇全是工程细节:怎么接、参数怎么填、钱怎么省。
前置条件
| 项目 | 值 |
|---|---|
| 模型 ID | MiniMax-M3.1-Flash |
| OpenAI 兼容端点 | https://API.minimax.io/v1 |
| Anthropic 兼容端点 | https://api.minimax.io/anthropic |
| 上下文 | 1,000,000 Tokens |
| 价格 | $0.15 输入 / $0.60 输出 / $0.015 缓存(每百万) |
| 思考控制 | reasoning_effort:low / medium / high / xhigh / max,默认 max |
API Key 在 platform.minimax.io 申请。两个端点用同一把 key,选哪个看你现有代码基于哪套 SDK。
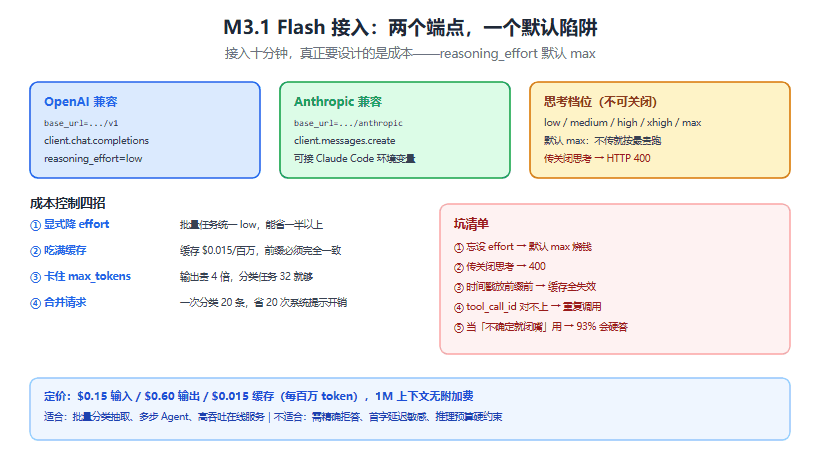
图 1:两套端点 + 一个不可关闭的思考档位,右边是省钱四招
方式一:OpenAI SDK 直连
如果你现在用的是 OpenAI SDK,改两个参数就能切过来:
from openai import OpenAI

client = OpenAI(
    api_key="sk-xxx",
    base_uRL="https://api.minimax.io/v1",
)

resp = client.chat.completions.create(
    model="MiniMax-M3.1-Flash",
    messages=[
        {"role": "system", "content": "你是工单分类助手,只输出类目名。"},
        {"role": "user", "content": ticket_text},
    ],
    reasoning_effort="low",   # 关键:默认是 max,这里必须显式降档
    max_tokens=64,
    temperature=0.1,
)
print(resp.choices[0].message.content)
reasoning_effort 是这套接入的核心开关。分类、抽取这类任务用 low 就够,复杂 Agent 规划才需要 high 或 max。
注意:不能传 thinking=False 或类似参数。 实测传关闭思考的参数会直接返回 HTTP 400,官方设计就是思考常开,只能用 effort 调深浅。
方式二:Anthropic 兼容端点
如果你的代码基于 Claude 的 SDK,或者想接 Claude Code,用这个端点:
import anthropic

client = anthropic.Anthropic(
    api_key="sk-xxx",
    base_url="https://api.minimax.io/anthropic",
)

msg = client.messages.create(
    model="MiniMax-M3.1-Flash",
    max_tokens=1024,
    messages=[{"role": "user", "content": "把这段日志里的错误码提取成 JSON"}],
)
print(msg.content[0].text)
Claude Code 里接它,设置三个环境变量即可:
export ANTHROPIC_BASE_URL="https://api.minimax.io/anthropic"
export ANTHROPIC_AUTH_TOKEN="sk-xxx"
export ANTHROPIC_MODEL="MiniMax-M3.1-Flash"
社区里已经有不少人这么用,好处是 Claude Code 的工具调用、文件编辑这些能力能直接借用,模型换成便宜的。
成本控制的四招
第一招:显式降 effort。 这是最大的一笔。默认 max 意味着每个请求都跑最深推理,简单任务白烧钱。批量任务统一设 low,能省一半以上。
第二招:吃满缓存。 缓存命中价 $0.015,是输入价的十分之一。前提是请求前缀完全一致——system prompt、工具定义、长文档放在前面且不改,命中率才高。顺序频繁变动等于没缓存。
第三招:卡住 max_tokens。 输出 $0.60 比输入贵四倍,不限长度的话,模型可能写出一大段。分类任务 32 token 够用,别给 4096。
第四招:合并请求。 同一批任务打包进一个请求(比如一次让模型分类 20 条),比分 20 次调用省掉 20 次系统提示的开销。
工具调用要注意的两件事
多步调用保持 tool_call_id 一致。 模型返回 tool_calls 后,你的工具执行结果必须按原 id 回填,顺序和 id 对不上,下一轮它会重新调一遍——多花钱还容易死循环。
工具定义别每次都改。 工具 schema 属于请求前缀的一部分,改动会让缓存全部失效。定好了就固定住,要加工具就新开一套配置。
坑清单
1. 传了关闭思考的参数。 直接 400,且报错信息不一定直白。记住只能调 effort。
2. 忘了设 effort,默认 max。 这是最容易忽略的隐性成本,尤其批量任务,账单能差一倍。
3. 以为长上下文有附加费。 它没有超长附加费,但 1M 上下文的输入 token 还是要按 $0.15 算,长文档该切还是切。
4. 缓存没命中还以为省了钱。 缓存要求前缀一致,动态时间戳、随机 ID 放在最前面会让缓存彻底失效。
5. 拿它做「不知道就别说」的任务。 它的幻觉率 93%(AA 测试口径),不确定时倾向硬答。要这种场景,加一层校验或用别的模型。
边界
这套接法适合:批量分类抽取、多步 Agent、需要高吞吐的在线服务、成本敏感的批处理。
不适合:需要精确拒答的场景、要求首字延迟极低的交互(思考常开会抬高首字时间)、需要精确控制推理预算的合规业务。
代码层面没什么难的,难的是「每次都记得降档」这个纪律。建议直接封装一层默认参数,别指望调用方每次手写。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。