
一句话总结:这五款模型覆盖了从 2.5B 端侧到 1.6 万亿旗舰的全部区间,但「参数大」和「值得用」是两件事——真正的选型依据是激活量、价格、许可证和你任务的长短,本文用一张表加三条路线把它们理清。
这几个月国产模型密集发布,参数从 2.5B 一路卷到 1.6 万亿。我把手上这五款放在一起对了一遍,越对越觉得:光看参数表选模型,基本等于闭眼抽签。
先把事实摆齐,再讲怎么选。
一张表看全
| 模型 | 参数 / 激活 | 上下文 | 价格($/百万) | 权重 | AA 指数 |
|---|---|---|---|---|---|
| Qwen3.8-Max | 2.4T / 95B | 1M | $2.00 / $6.00 | 闭源 API | 45.4 |
| Step5 Preview | 600B / 27B | 1M | $1.00 / $2.70 | 开源权重(协议待确认) | 44 |
| MiniMax M3.1 Flash | 428B / 23B | 1M | $0.15 / $0.60 | 10-23 放出 | 42 |
| LongCat 2.5 Preview | 1.6T / 48B | 1M | 约 $0.28 / $1.12(¥2/¥8) | 无 | 未进榜 |
| MiniCPM5-2B | 2.5B(稠密) | 131K | 开源,自托管 | Apache 2.0 | 12.5 |
四个读表要点:
激活量比总参数更能说明成本。 Qwen3.8-Max 激活 95B,Step5 激活 27B,M3.1 Flash 激活 23B——三者的总参数差了几倍,但单 Token 开销由激活量决定,这直接反映在价格上。
参数最大不等于分数最高。 LongCat 2.5 有 1.6 万亿,是五款里最大的,但至今没进 AA 榜单,实测也偏慢。参数是容量,不是能力。
开源状态必须分清。 MiniCPM5 是 Apache 2.0 真开源;Step5 放了权重但协议未确认;Qwen3.8 的 2.4T 权重带商用门槛;M3.1 Flash 的权重还没落地;LongCat 只有 API。
上下文都到 1M 了,但质量不一样。 标称 1M 是一回事,能在这个长度上保持检索质量是另一回事。目前没有第三方的长上下文横评,这一栏我持保留态度。
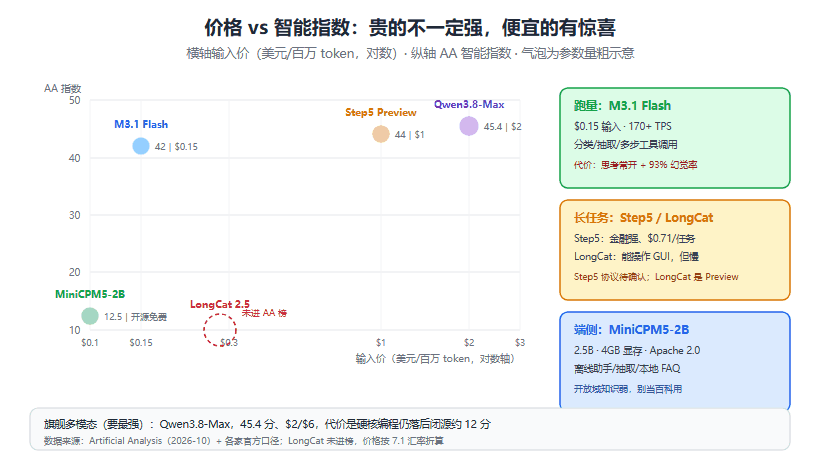
图 1:横轴为输入价格(对数),纵轴为 AA 智能指数,气泡大小为参数量
三条路线,比排名更有用
路线一:极致性价比,跑量
MiniMax M3.1 Flash。 $0.15 的输入价、170+ TPS 的吞吐、42 分的智能指数,这组组合在批量任务上没有对手。适合分类、抽取、摘要、多步工具调用这类高频场景。
前提是接受两个代价:思考关不掉,简单请求也会烧推理 token;93% 的幻觉率,不确定时也硬答。跑量可以,做最终判断不行。
路线二:长任务与专业场景
Step5 Preview 是这条线的主力:1M 上下文、27B 激活、单任务成本 0.71 美元,金融任务(FrontierFinance 66.4)是它的强项。有 GPU 资源的团队可以自建,没有就走 API。
LongCat 2.5 是另一条岔路:它的价值不在写代码,在操作界面——终端、浏览器、GUI、表格都能驱动。适合 RPA、自动化测试、后台长任务。缺点是慢,一个任务半小时起步,而且是 Preview。
路线三:端侧与私有化
MiniCPM5-2B。 2.5B、4GB 显存、Apache 2.0,手机、车机、轻薄本、离线终端都能跑。它解决的是「装得下」的问题,不是「最强」的问题。
结构化任务(数学、代码、工具调用)它的表现远超尺寸,开放域知识基本靠猜。用它做端侧助手、离线抽取、本地 FAQ,很合适。
另外:旗舰与多模态
Qwen3.8-Max。 需要最强多模态、要 1M 上下文、不想自己运维,选它。$2/$6 不算便宜,但 45.4 分的 AA 指数是这五款里最高的。代价是硬核编程仍落后闭源旗舰一截(SWE-Bench Pro 67.7 vs 80)。
三个常见误区
误区一:参数越大越好。 1.6 万亿的 LongCat 没进 AA 榜,2.5B 的 MiniCPM 在数学上能打 86.5。模型能力取决于训练质量、数据配比、激活效率,不只看总参数。
误区二:只看每百万 token 价格。 真正的成本是「每个任务花多少」。M3.1 Flash 便宜但它思考常开,简单任务的 token 消耗会翻倍;Step5 单价 $1,但输出短、单任务只要 0.71 美元。
误区三:忽略许可证。 Apache 2.0、自定义许可、仅 API 是三件完全不同的事。要商用、要二次分发、要嵌进硬件,先看协议再看跑分。
常见问题
这五款里哪个综合最强?
Qwen3.8-Max,AA 45.4 分最高,多模态和 1M 上下文齐全。但「最强」不等于「最适合」,看你的场景。
预算有限选哪个?
跑量选 M3.1 Flash($0.15 输入),长任务选 Step5($1 输入、单任务 0.71 美元),端侧选 MiniCPM5(免费自托管)。
想本地部署,谁最现实?
MiniCPM5-2B 最现实,4GB 显存就能跑。Step5 需要多卡(FP8 约 600GB),属于团队级投入。Qwen3.8 的 27B 介于两者之间。
LongCat 值不值得试?
如果你做 GUI 自动化或后台长任务,值得。它操作界面的能力是这五款里最明确的,但 Preview 状态和慢速是硬伤。
榜单分数能直接比吗?
AA 指数是一套统一口径,可以横向比;厂商自报的分项不能跨家比,测试框架和参数都不同。
结语
这五款不是同一条赛道上的五个选手,是五个不同位置的工具:端侧、跑量、长任务、金融、旗舰多模态。选型的第一步不是看榜,是把自己的任务拆成「多长、多贵、要不要私有、能不能等」。
我个人的排序建议:先用 MiniCPM5 把本地流程跑通(成本为零),再用 M3.1 Flash 跑线上批量(单价最低),长任务和金融场景上 Step5,需要多模态和最高分再上 Qwen3.8-Max。LongCat 放在观察位,等它出正式版。
- 路线一:极致性价比,跑量
- 路线二:长任务与专业场景
- 路线三:端侧与私有化
- 另外:旗舰与多模态
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。