
一句话总结:原型跑通和真正上线之间隔着部署、监控、成本三道坎;这篇文章在本机架了一个最小网关做故障注入实验,把超时怎么设、监控该埋哪些点、告警阈值定多少、API 和自建的账怎么算,全部给出可复制的数字。
前九篇把零件一个个做出来了:MCP 工具、RAG 检索、结构化输出、Function Calling、Agent 循环、本地部署。零件都有,接下来是怎么把它们装成一台能对外服务的机器。这一步的失败率比想象中高——原型是在你自己的键盘上跑通的,上线意味着流量、并发、别人的钱和别人的耐心。
我见过最常见的翻车不是模型不够聪明,是三件很土的事:没有超时,一个 Agent 死循环烧掉一天预算;没有回滚,改了 prompt 只能眼睁睁看着指标掉;没有成本归因,月底收到账单才知道某个接口被人刷了。这篇就围着这三件事讲。
上线前先答三个问题
动手之前先把三件事写下来,它们决定了后面所有技术选择。
谁在用,多少并发? 个人工具和面向用户的产品是两种生物。前者的正确答案是能跑就行,后者要考虑峰值、限流和降级。本文的实测数据显示,一个后端挂死时,有没有网关决定了用户拿到的是答案还是空白。
数据能不能出门? 这是硬约束,不是偏好。医疗、财务、未公开代码这类场景,本地或私有化部署是唯一选项,成本让路。
挂了谁买单? 说人话就是 SLA。如果服务挂十分钟只是同事吐槽一句,很多工程可以省;如果挂十分钟要赔钱,那网关、监控、备用模型一样都不能少。
部署形态:四种选择一张表
| 形态 | 适合谁 | 冷启动 | 运维量 | 价格量级 |
|---|---|---|---|---|
| 单机 Docker | 个人工具、内部小服务 | 无 | 低 | 一台机器钱 |
| PaaS(Railway / Render / Fly.io) | 小团队快速上线 | 秒级 | 很低 | 每月 5 到 20 美元 |
| Kubernetes | 多副本、要弹性伸缩 | 分钟级 | 高 | 集群钱 |
| ServeRLess GPU(Modal 等) | 突发 GPU 推理 | 分钟级 | 中 | 按调用计费 |
几个踩过才知道的细节。K8s 上跑 LLM 服务,伸缩要看队列深度而不是 CPU(KEDA 配队列深度伸缩,冷却期 300 秒),并且永远不要缩到 0:minReplicas=1,否则下一个请求要等冷启动,那是用户可见的故障,省下来的那点机器钱不够赔体验。
发布策略上,单端点直发最快但炸起来最彻底;蓝绿切换能秒回滚,代价是双倍资源;灰度(先 10% 流量,观察 30 分钟再全量)是生产环境最稳的选择;影子部署零用户影响但拿不到真实反馈。AI 应用我默认推灰度,因为它允许你同时看新旧两个版本的质量分而不只是错误率。
网关实验:超时、重试、故障转移与限流
这一节的数字全部来自本机实测。我用 Python 标准库写了个一百行的小网关,功能只有四样:3 秒超时、超时重试一次、故障转移到备用后端、2 QPS 令牌桶限流。备用后端是个 5 毫秒返回的假服务,模拟降级到便宜小模型。
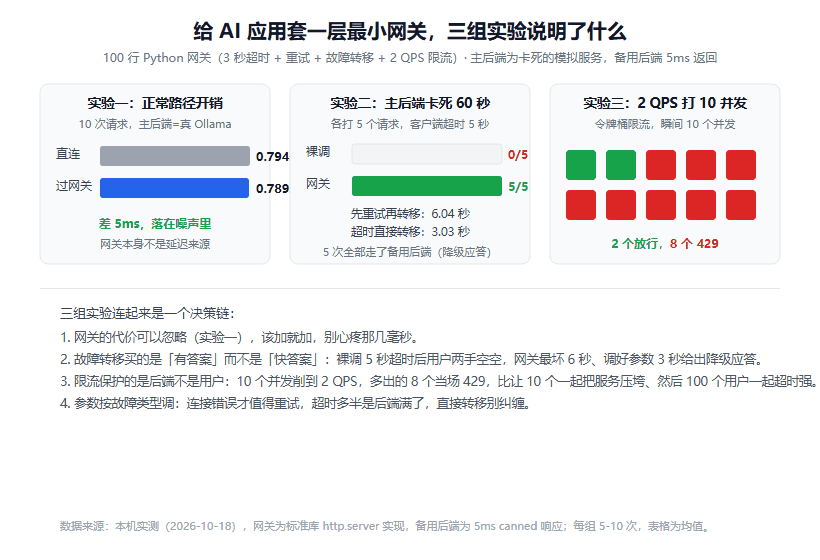
图 1:网关开销可以忽略,真正值钱的是故障转移和限流。
实验一,正常路径开销。 主后端指向真正的 Ollama,各打 10 个请求:直连平均 0.794 秒,过网关 0.789 秒。差 5 毫秒,落在噪声里。结论很直接:别拿「网关会拖慢」当不做的理由。
实验二,主后端卡死 60 秒。 裸调(客户端 5 秒超时)5 个请求全灭,一个答案都没拿到。套上网关后 5 个全成功,全部走了备用后端,代价是 6.04 秒(3 秒超时 + 3 秒重试 + 5 毫秒转移)。这个结果我一开始不满意,于是把「超时后重试」改成「超时直接转移」,同样的故障下 3.03 秒出降级应答。参数不是摆设:连接类的错误值得重试,超时多半是后端已经满了,与其纠缠不如快点换路。
实验三,限流。 令牌桶 2 QPS,瞬间打 10 个并发,结果 2 个放行、8 个当场拿到 429。限流保护的是后端不是用户——让 10 个人一起排队把服务压垮、然后 100 个用户一起超时,比当场拒绝 8 个人糟得多。
生产环境不必自己写这一百行,LiteLLM、Portkey 这类网关已经把路由、缓存、重试、限流做全了。但自己写一遍的好处是知道每个参数在干嘛:超时之后到底是重试还是转移,这个决定要按故障类型来做,框架替不了。
一条最小上线链路
把服务包起来是最没技术含量的一步,也是最容易偷懒然后出事的一步。
from fastapi import FastAPI
from OpenAI import OpenAI

app = FastAPI()
client = OpenAI(base_url="http://127.0.0.1:11434/v1", api_key="ollama")

@app.get("/healthz")
def healthz():
    return {"ok": True}

@app.post("/ask")
def ask(q: str):
    resp = client.chat.completions.create(
        model="qwen2.5:7b",
        messages=[{"role": "user", "content": q}],
        timeout=8.0,          # 超时是底线,不是可选项
        max_Tokens=512,       # 单请求上限,防长答案烧穿预算
    )
    return {"answer": resp.choices[0].message.content}
配一份十行的 Dockerfile,把权重挂成卷而不是打进镜像(换模型不用重建镜像),依赖版本全部锁死。健康检查端点别省略,K8s 靠它重启异常 Pod,负载均衡靠它摘除坏节点。
版本化要有三套:模型用 tag(model:v1.2.3),镜像和代码用 Git tag 关联,API 路径带版本(/api/v1/ask)。发布时打镜像 tag,出问题一条命令回滚到上一个镜像和权重。没有回滚的发布不叫发布,叫赌运气。
监控:别只监控「服务器活着」
传统监控问的是「服务在不在」,AI 应用要问的是「答案对不对、钱花了多少」。一个返回 HTTP 200 但内容胡编的服务,在你的可用性看板上永远是绿的。
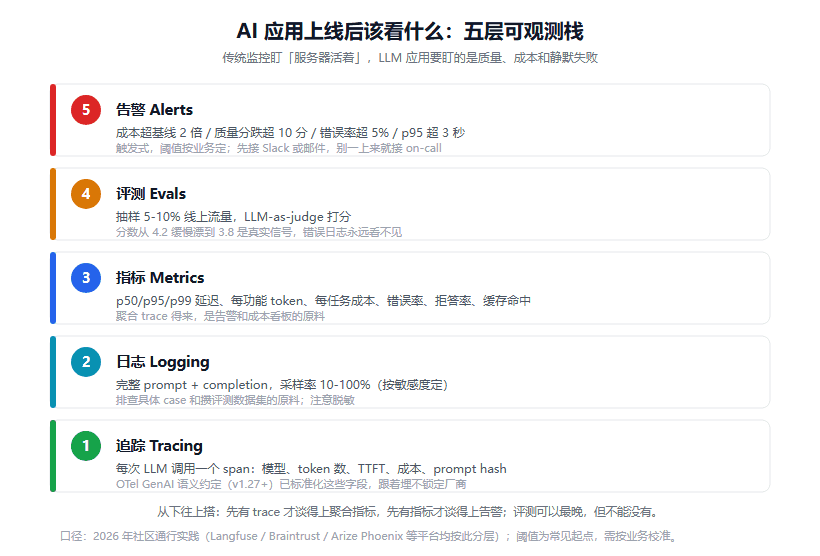
图 2:从下往上搭,tracing 是地基,alerts 是屋顶。
| 层 | 埋什么 | 工具 |
|---|---|---|
| 追踪 | 每次 LLM 调用一个 span:模型、token 数、TTFT、成本、prompt hash | Langfuse、Phoenix;字段跟 OTel GenAI 语义约定(v1.27+)走 |
| 日志 | 完整 prompt + 完整输出,采样率 10-100% 按敏感度定 | 自建存储,注意脱敏 |
| 指标 | p50/p95/p99 延迟、每功能 token、每任务成本、错误率、拒答率、缓存命中率 | Prometheus + Grafana |
| 评测 | 抽样 5-10% 线上流量,LLM-as-judge 打分 | Langfuse、Braintrust |
| 告警 | 成本超基线、质量分下跌、错误率、p95 延迟 | 平台自带或自建 |
我最看重的一个指标是每完成任务的成本,不是总花费。按「用户有没有拿到他要的东西」来归集成本,才知道哪个功能在赚钱、哪个在烧钱。第二个是质量分的缓慢漂移:两周里从 4.2 掉到 3.8,错误日志一条都不会有,但用户已经感觉到了。
工具选择上,Langfuse 可自托管(MIT 协议,Hobby 档每月 5 万单位免费,Core 29 美元/月),2026 年 1 月被 ClickHouse 收购后仍在正常迭代;Helicone 今年 3 月被 Mintlify 收购后进入维护模式,新项目我不建议押它。这些都是我查到的现状,选型前记得再确认一次。
告警与止损:阈值怎么定
阈值没有标准答案,但有常见的起点:日成本超过均值 150% 就告警,p95 延迟超过 3 秒或者 SLA 的 1.2 倍就排查,错误率超过 5% 就查供应商状态和备用链路,token 用量超过限额 80% 就限流掉非关键流量。质量分掉 10 分以上要当事故处理。
比告警更重要的是硬止损,它不需要人参与就能生效:账号级别的消费上限、agent 循环的 max_iterations、单请求 max_tokens、每个调用的超时。这四道闸里任意一道缺失,都可能让一次意外变成一次事故。上线 checklist 里还应该有两条容易被漏掉的:写操作(发邮件、转账、改库)必须有人工确认环节;关键路径要有备用模型可以切换。
成本核算:API 还是自建
先给价格(2026 年多家第三方汇总,按每百万 token 计):GPT-4o-mini 输入 $0.15、输出 $0.60;DeepSeek V3 输入 $0.14、输出 $0.28;Claude Haiku 4.5 输入 $1、输出 $5;Claude Sonnet 4.6 输入 $3、输出 $15。国内渠道的 DeepSeek 报价有 0.14-0.28 的浮动,按促销档走会更便宜。
按一个典型请求(2K 输入 + 500 输出)算单请求成本:DeepSeek 约 $0.00042,GPT-4o-mini 约 $0.0006,Haiku 约 $0.0045,Sonnet 约 $0.0135。做个客服机器人,每月 10M 输入 + 2M 输出,DeepSeek 一个月约 2 美元,Sonnet 约 60 美元。看到这个数字我其实挺意外:这个量级自建完全没有意义。
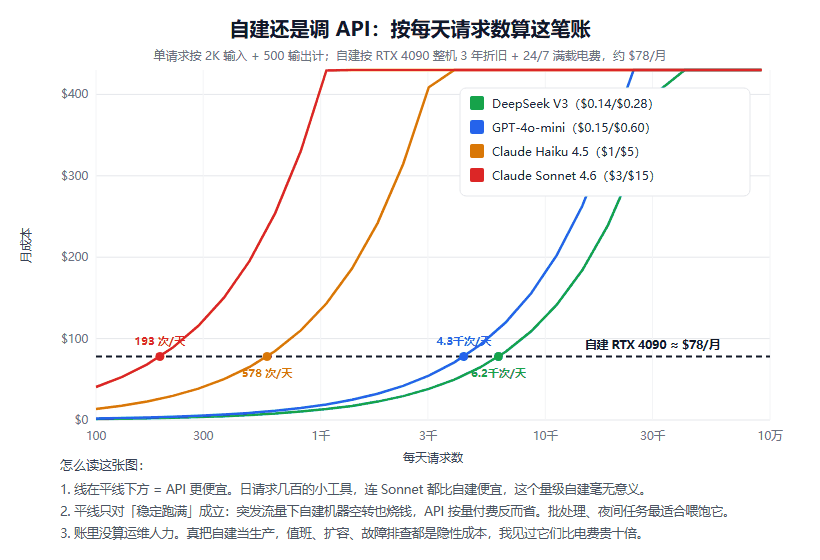
图 3:自建的平线只对「稳定跑满」成立,突发流量下 API 反而更省。
自建的账我这么算:一台 RTX 4090 整机约 15000 元,按 3 年直线折旧约 416 元/月;24 小时满载 350W,一个月 252 度电,按居民电价 0.55 元/度约 139 元;合计约 555 元/月,折合 78 美元。这条平线和四条 API 斜线的交点分别是:Sonnet 每天 193 次,Haiku 578 次,GPT-4o-mini 4300 次,DeepSeek 6200 次。
这就是「别一上来就自建」的量化版本:除非你的量稳定在每天几千次以上,或者数据根本不能出门,否则 API 更划算。而且这条平线假设机器被喂得很饱,突发流量下空转也烧钱,那一刻的账要再算一遍。账里也没算运维人力,真把自建当生产,值班和故障排查经常比电费贵十倍。
省钱有四招,按性价比排:缓存(重复的系统提示和文档上下文走缓存价,便宜 50% 到 90%,这是被浪费最多的一块)、小模型分工(分类、路由、摘要交给 mini 档,只在复杂推理时升级)、批处理(OpenAI 和 Anthropic 的 batch API 打五折,代价是 24 小时 SLA,离线任务最适合)、上下文压缩(历史对话摘要化、截断,别让上下文无限膨胀)。
还有一笔隐性开销值得单独提:如果模型 20% 的时候答错、你的代码自动重跑一次,那就是 20% 的成本乘数。这一点呼应前面的网关实验——重试要挑故障类型,盲目重试等于给自己加税。
翻车点清单
密钥硬编码进镜像,或者镜像里带了 .env;忘了设超时,一个慢请求拖死整个线程池;agent 没有 max_iterations,循环起来一夜烧光预算;缩容到 0 尝到冷启动;没有版本化和回滚方案,出事只能硬着头皮改;只监控 CPU 和内存,不看质量分和拒答率;日志里存了明文 PII。这七条我基本都见过真实的版本,没有一条需要高手才能避开。
FAQ
个人小工具要不要上 Kubernetes?
不要。单机 Docker 或者 PaaS 就够了,K8s 的运维成本远高于它在这个规模带来的收益。等你需要多副本和弹性伸缩再考虑,那时候你会知道自己为什么需要它。
可观测性平台怎么选?
我自己倾向 Langfuse,开源、能自托管、框架无关,数据留在自己手里。已经在用 LangChain 的可以直接上 LangSmith,集成最省事。Helicone 接入最快(零代码改动)但已进维护模式,新项目谨慎。核心是先把 trace 跑起来,工具是第二位的。
什么时候真的该自建 GPU?
三个条件至少满足两个:日请求量稳定在几千以上(参考图 3 的平衡点)、负载平稳能喂饱机器、数据不能出门。只满足「想省钱」这一条的话,先去把缓存和小模型分工做了,通常能省一半以上。
灰度发布 AI 应用要盯什么?
10% 流量跑 30 分钟,重点看质量分、拒答率、每任务成本,而不只是错误率和延迟。AI 应用的坏版本经常是「全部 200 但答案变差了」,只看可用性指标会让你信心十足地全量一个退化的版本。
成本突然涨上去了怎么查?
先按功能和用户拆每任务成本,定位是哪个接口;再看拒答率和重试次数(这两个是隐性放大器的常客);最后看缓存命中率是不是掉下去了。查清楚之前,先把非关键流量限流掉止血。
结语
十篇写到这里,从写第一个 MCP 工具到把一个 AI 应用真正送上线,链路算走完整了。回过头看,真正决定成败的往往不是模型选择,而是那些不性感的工程细节:一个超时参数、一条回滚命令、一次成本归因。这些事情做对了,模型换哪家都不会出大事;做错了,再强的模型也会在某个凌晨把你叫醒。
这个系列的收尾建议很简单:先把 trace 和硬止损接上,这两样做完,你的 AI 应用就已经比大多数原型更接近生产了。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。