
一句话总结:逆向里所有「找偏移」的动作,追到底都要落回 PE 结构。这篇把两个头、节表、十六个数据目录拆开讲,重点说清 RVA 和文件偏移这对最容易搞混的概念,再给一段能直接把任意 EXE 的导入表、节权限、TLS 回调 dump 出来的 Python 代码。
前面几篇一直在动态侧打转:CE 找地址、x64dbg 下断、反调试识别。这些动作都有个前提——你得知道自己在看哪块内存。
而「这块内存是什么、为什么在这个地址、可读还是可执行」,答案全在磁盘上的那个文件里。PE 结构就是那张地图。
前置
- 任意一个 EXE 或 DLL 当样本(自己写的程序最好)
- 一个可视化工具:CFF Explorer 或 PE-bear,看结构比命令行直观
- Python +
pip install pefile,做批量分析 - 一点耐心:这部分内容是纯静态的,没有「跑一下就知道」的捷径
两个头,一个节表
PE 文件的骨架是三段:DOS 头、NT 头(含文件头与可选头)、节表。
DOS 头留了 64 字节,开头两个字节是 MZ。它的实际作用只有一个:偏移 0x3C 处有个 4 字节的 e_lfanew,指向真正的 NT 头在哪。这个间接层是历史遗留,但从 1993 年留到今天。
NT 头开头是签名 PE\0\0,后面跟两块:
| 结构 | 关键字段 | 你要它干什么 |
|---|---|---|
| 文件头(20 字节) | Machine、NumberOfSections | 判断 32/64 位、有几个节 |
| 可选头 | ImageBase、AddressOfEntryPoint、SectionAlignment | 默认加载基址、入口 RVA、内存对齐粒度 |
| 可选头后半 | DataDirectory[16] | 导入表、导出表、重定位、TLS 各在哪 |
ImageBase 这个字段是「没开 ASLR 时的加载地址」。开了 ASLR 之后实际基址每次不同,但模块内偏移不变——这就是为什么逆向里所有地址都写成「模块名 + 偏移」。
DataDirectory 是十六个槽位,按固定顺序排:
| 序号 | 名称 | 逆向里的用途 |
|---|---|---|
| 0 | Export | DLL 导出函数,找入口点 |
| 1 | Import | 导入了哪些 API,判断程序在干什么 |
| 2 | Resource | 图标、字符串表、版本信息 |
| 3 | Exception | x64 的异常处理表 |
| 5 | BaseRelocation | 重定位,ASLR 的基础 |
| 9 | TLS | TLS 回调,反调试常藏在这 |
| 12 | IAT | 导入地址表,运行时被填成真实地址 |
| 13 | DelayImport | 延迟导入,躲静态分析常用 |
| 14 | CLR | .NET 程序在这,是托管代码 |
节表紧跟在可选头之后,每个节 40 字节。关心五个字段就够:名字(8 字节)、VirtualSize、VirtualAddress、SizeOfRawData、PointerToRawData、Characteristics。
Characteristics 是权限位,看几个典型值:
0x60000020:可执行 + 可读(代码段.text)0x40000040:可读(只读数据.rdata)0xC0000040:可读 + 可写(.data)0xE0000020:可读 + 可写 + 可执行(.text变成这样,基本可以确定被加壳或自修改代码)
RWX 那条是我判断样本是否可疑的第一眼依据。正常的编译器产物里,同时可写又可执行的节很少见。
RVA 与文件偏移:一对必须分清的数
这是新手最容易栽的地方,我单独拎出来说。
- RVA(相对虚拟地址):相对于
ImageBase的偏移,是「加载到内存后」的地址 - 文件偏移(File Offset):这个字节在磁盘文件里的位置
两者不相等,因为对齐粒度不同:内存按 SectionAlignment(通常 0x1000,即 4KB)对齐,文件按 FileAlignment(通常 0x200,即 512 字节)对齐。
换算公式:
文件偏移 = RVA - 节的 VirtualAddress + 节的 PointerToRawData举个例子:一个节 VirtualAddress = 0x1000、PointerToRawData = 0x400,那么 RVA 0x1234 对应的文件偏移是 0x1234 - 0x1000 + 0x400 = 0x634。
搞混的后果很具体:你在 IDA 里看到一个地址,算成文件偏移去十六进制编辑器里找,找到的是一堆不相关的东西,然后开始怀疑人生。
导入表:静态分析的第一个入口
导入表回答的是「这个程序调用了哪些外部函数」。对逆向来说,这是成本最低的线索来源。
结构是这样的:一个 IMAGE_IMPORT_DESCRIPTOR 数组,每项对应一个 DLL,里面有 OriginalFirstThunk(指向 INT,名称表)和 FirstThunk(指向 IAT,运行时被填充成真实地址)。名称表里每项是 IMAGE_IMPORT_BY_NAME,含一个 hint 和函数名字符串。
实际看的时候不用记这么细,工具直接给你列出来。要关注的是函数名的组合:
IsDebuggerPresent、CheckRemoteDebuggerPresent:反调试(见反调试那篇)VirtualProtect、WriteProcessMemory:内存改写,可能是注入CreateToolhelp32Snapshot、Process32First:枚举进程RegOpenKeyEx、CryptEncrypt:配置读取、加密LoadLibrary+GetProcAddress:动态解析,故意隐藏导入
动态解析这条要特别注意:导入表干净不代表没调用。用 LoadLibrary + GetProcAddress 动态拿函数地址是常规的隐藏手段,静态看导入表完全看不到。
一段能直接用的 dump 脚本
import pefile, sys

def dump(path):
    pe = pefile.PE(path, fast_load=True)
    pe.parse_data_directories()

    print(f"== {path}")
    print(f"架构: {'x64' if pe.FILE_HEADER.Machine == 0x8664 else 'x86'}")
    print(f"ImageBase: 0x{pe.OPTIONAL_HEADER.ImageBase:X}")
    print(f"入口点 RVA: 0x{pe.OPTIONAL_HEADER.AddressOfEntryPoint:X}")
    print(f"对齐: 内存 0x{pe.OPTIONAL_HEADER.SectionAlignment:X} / 文件 0x{pe.OPTIONAL_HEADER.FileAlignment:X}")

    print("\n-- 节表")
    for s in pe.sections:
        name = s.Name.rstrip(b"\x00").decode(errors="ignore")
        ch = s.Characteristics
        flags = ("R" if ch & 0x40000000 else "-") + \
                ("W" if ch & 0x80000000 else "-") + \
                ("X" if ch & 0x20000000 else "-")
        print(f"  {name:<8} VA 0x{s.VirtualAddress:08X}  "
              f"大小 0x{s.Misc_VirtualSize:08X}  文件偏移 0x{s.PointerToRawData:08X}  权限 {flags}")
        if flags == "RWX":
            print("    ! 可写且可执行,注意是否加壳或自修改代码")

    print("\n-- 导入的 DLL 与函数(节选)")
    if hasattr(pe, "DIRECTORY_ENTRY_IMPORT"):
        for entry in pe.DIRECTORY_ENTRY_IMPORT:
            dll = entry.dll.decode(errors="ignore")
            names = [imp.name.decode(errors="ignore") if imp.name else f"ord{imp.ordinal}"
                     for imp in entry.imports]
            print(f"  {dll}: {len(names)} 个")
            for n in names[:8]:
                print(f"    - {n}")
            if len(names) > 8:
                print(f"    ... 其余 {len(names)-8} 个")

    print("\n-- 可疑信号")
    if hasattr(pe, "DIRECTORY_ENTRY_TLS") and pe.DIRECTORY_ENTRY_TLS:
        print("  ! 存在 TLS 目录:代码可能在入口点之前执行")
    ddir = pe.OPTIONAL_HEADER.DATA_DIRECTORY
    if ddir[13].VirtualAddress:
        print("  ! 存在延迟导入:部分 API 静态看不到")
    if ddir[14].VirtualAddress:
        print("  ! 存在 CLR 目录:这是 .NET 程序,得换 ILSpy 那套工具")

if __name__ == "__main__":
    dump(sys.argv[1] if len(sys.argv) > 1 else "target.exe")
跑一下自己的程序,把输出和工具里看到的对一遍,比读十页文档快。
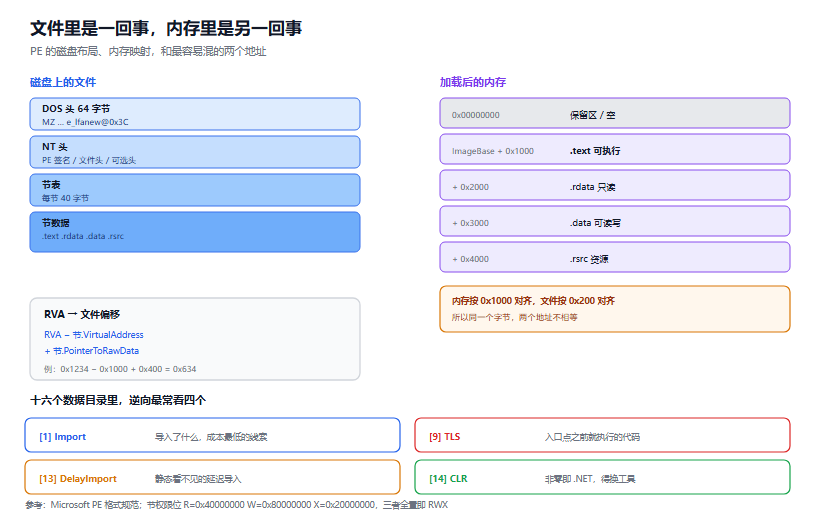
图 1:上为文件里的节与实际内存的映射关系,下为十六个数据目录里最常用的几个
坑清单
坑一:把 RVA 当文件偏移用。 排第一。两个对齐粒度不同,混用必然找不到东西。记住 SectionAlignment 通常是 0x1000、FileAlignment 通常是 0x200。
坑二:ImageBase 当成实际加载地址。 开了 ASLR 之后每次都不一样。运行时地址要乘以实际基址,或者用「模块 + 偏移」的写法。
坑三:只看导入表就下结论。 LoadLibrary + GetProcAddress 能让导入表一片干净。同理,延迟导入和 CLR 程序的导入表都不能反映真实调用。
坑四:忽略 Characteristics 里的 RWX。 一个 0xC0000040 的节被改成可执行,或者 .text 变成可写可执行,都是强信号。查壳先看这个。
坑五:32/64 位搞混。 Machine 字段 0x8664 是 x64,0x14C 是 x86。可选头大小也不同(PE32 是 0xE0,PE32+ 是 0xF0),算偏移时算错一位就全乱。
边界
这篇讲的是静态结构,不涉及加壳脱壳和实际样本分析。真要动加壳程序,PE 结构的知识是前提但不是全部,还得看导入表被抹成什么样、节名有没有被改、入口点是否在异常节里。
样本范围也说明一下:用自己的程序或靶场程序练,别拿来源不明的可执行文件在主力机上跑。静态分析相对安全,但双击运行是另一回事。
FAQ
学这个对写代码有帮助吗?
有。理解节的权限和对齐,能解释很多诡异现象:比如为什么全局变量初始化顺序会出问题、为什么某些常量在 .rdata 里、为什么链接出来的体积比预期大。
PE 和 COFF、ELF 什么关系?
COFF 是更早的目标文件格式,PE 的文件头沿用了 COFF 结构;ELF 是 Linux 那边的对应物,思路类似(头 + 节 + 段),字段名不同。
.NET 程序也用这套吗?
文件格式一样,但代码是 IL 不是机器码。DataDirectory[14](CLR)非零就是托管程序,得用 DNSpy / ILSpy 这类工具看,用 x64dbg 只能看到 JIT 之后的产物。
怎么快速判断一个 EXE 有没有加壳?
四个信号一起看:节名异常(.UPX0、随机字符串)、节数量很少但体积很大、.text 是 RWX、导入表只有 LoadLibrary 和 GetProcAddress。四个里中两个就值得深挖。
RVA 换算有没有工具?
CFF Explorer 的「Address Converter」、PE-bear 都有。写脚本的话 pe.get_offset_from_rva(rva) 一行搞定。
结语
PE 结构不难,难的是那几个概念要一次理顺:文件偏移和 RVA 的区别、ImageBase 和实际基址的区别、虚拟大小和原始大小的区别。
理顺之后你会发现,之前那些「为什么这里对不上」的问题,答案基本都在这三个区别里。
参考资料
- Microsoft PE 格式规范 - 完整结构定义
- pefile 文档 - Python 解析 PE 的接口
- CFF Explorer - 可视化查看 PE 结构
- 本站 x64dbg 入门 - 动态侧如何配合静态结构
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。