
一句话总结:几千到几十万条文档的语义搜索,不需要 Milvus 也不需要 Qdrant。SQLite 加一个扩展就能做 KNN 检索,再配上内置的 FTS5 做混合搜索,整个系统就是一个数据库文件。这篇给完整可跑的代码和规模边界。
先说结论性的判断:向量数据库的核心卖点是规模,而绝大多数项目的规模根本用不上它。你的知识库如果是几千份文档、几十万条切片,装一套需要 Docker、需要运维、需要单独备份的服务,纯属给自己找麻烦。
sqlite-vec 是个 SQLite 扩展(MIT / Apache-2.0 双协议),把 KNN 检索做成了 SQL 语句。数据在文件里,备份就是复制一个 .db 文件。
环境
pip install sqlite-vec sentence-transformers两个依赖:sqlite-vec 自带预编译扩展,sentence-transformers 负责生成向量。中文场景建议用 BAAI/bge-small-zh-v1.5(512 维,约 100MB),英文用 all-MiniLM-L6-v2(384 维)。
如果你的机器 CPU 弱,也可以改用 Ollama 跑 bge-m3 通过 HTTP 拿向量,省掉 torch 那一坨依赖。
建库:三个表分工
结构很简单,一张原表存文本,一张虚拟表存向量,一张 FTS5 表做关键词。
import sqlite3, sqlite_vec, struct

DIM = 512   # 必须和嵌入模型输出维度一致,建表后不能改

db = sqlite3.connect("kb.db")
db.enable_load_extension(True)
sqlite_vec.load(db)
db.enable_load_extension(False)

db.executescript("""
CREATE TABLE IF NOT EXISTS docs (
    id      INTEGER PRIMARY KEY,
    path    TEXT NOT NULL,
    content TEXT NOT NULL
);

CREATE VIRTUAL TABLE IF NOT EXISTS vec_docs USING vec0(
    embedding float[512] distance_metric=cosine
);

CREATE VIRTUAL TABLE IF NOT EXISTS fts_docs USING fts5(
    content, content='docs', content_rowid='id'
);
""")
三个容易出错的地方:
- 维度写死在建表语句里(
float[512]),换模型必须重建表 distance_metric=cosine要显式写,默认是 L2。文本嵌入用余弦更准- FTS5 的
content='docs'是外部内容表模式,索引不重复存正文,省空间
写入:把向量打包成 BLOB
sqlite_vec.serialize_float32() 把 Python list 转成二进制,比传 JSON 字符串快得多。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")

def add_docs(items):
    """items: [(path, content), ...]"""
    texts = [c for _, c in items]
    vecs = model.encode(texts, normalize_embeddings=True)

    with db:   # 事务,批量写快很多
        for (path, content), vec in zip(items, vecs):
            cur = db.execute(
                "INSERT INTO docs(path, content) VALUES (?, ?)", (path, content))
            rid = cur.lastrowid
            db.execute(
                "INSERT INTO vec_docs(rowid, embedding) VALUES (?, ?)",
                (rid, sqlite_vec.serialize_float32(vec.tolist())))
            db.execute(
                "INSERT INTO fts_docs(rowid, content) VALUES (?, ?)", (rid, content))
normalize_embeddings=True 这个参数别漏。bge 系列的向量归一化之后,余弦距离和点积等价,检索结果更稳。
如果不想用 serialize_float32,标准库也能做:
def pack(vec):
    return struct.pack(f"{len(vec)}f", *vec)   # 等价写法
查询:一条 SQL 就是 KNN
def search_semantic(query, k=10):
    qv = model.encode([query], normalize_embeddings=True)[0]
    rows = db.execute("""
        SELECT d.id, d.path, d.content, v.distance
        FROM vec_docs v
        JOIN docs d ON d.id = v.rowid
        WHERE v.embedding MATCH ? AND k = ?
        ORDER BY v.distance
    """, (sqlite_vec.serialize_float32(qv.tolist()), k)).fetchall()
    return rows
注意 k = ? 是 vec0 的专用参数,不能只用 LIMIT。两者都写更保险——k 控制检索深度,LIMIT 控制返回条数。
没有建索引这一步。vec0 默认做的是暴力扫描,几千到几十万条的量级下延迟在毫秒级,够用。
加关键词:FTS5 + RRF 融合
纯语义检索有个通病:精确词搜不到。错误码、产品型号、人名缩写这类东西,向量表达不出来。SQLite 的 FTS5 正好补这块。
def search_keyword(query, k=10):
    rows = db.execute("""
        SELECT d.id, d.path, d.content, f.rank
        FROM fts_docs f
        JOIN docs d ON d.id = f.rowid
        WHERE fts_docs MATCH ?
        ORDER BY f.rank
        LIMIT ?
    """, (query, k)).fetchall()
    return rows

def rrf(rank_lists, k=60):
    """倒数排名融合,不用校准两路分数量纲"""
    score = {}
    for rows in rank_lists:
        for rank, row in enumerate(rows):
            rid = row[0]
            score[rid] = score.get(rid, 0) + 1 / (k + rank + 1)
    return sorted(score.items(), key=lambda kv: kv[1], reverse=True)

def search_hybrid(query, k=10):
    fused = rrf([search_semantic(query, k), search_keyword(query, k)])
    ids = [rid for rid, _ in fused[:k]]
    if not ids:
        return []
    ph = ",".join("?" * len(ids))
    return db.execute(f"SELECT id, path, content FROM docs WHERE id IN ({ph})", ids).fetchall()
RRF 的好处是不用管两路分数的量纲差异——一边是余弦距离(0 到 2),一边是 BM25 排名分(可能是负数),直接加权相加会打架。按排名倒数求和就没这个问题。
这套融合在上一篇 RAG 文里讲过原理,这里换成了 SQLite 实现,代码量少了三分之二。
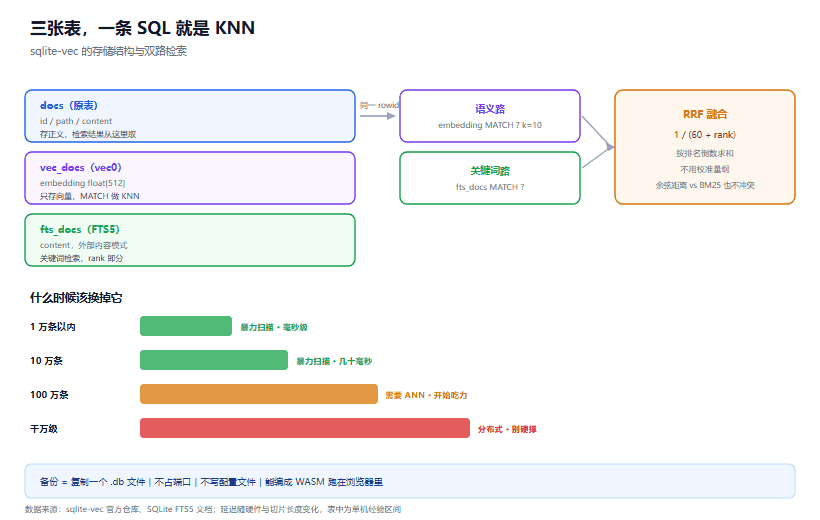
图 1:原文表、向量表、FTS5 表各管一件事,融合层只做排名合并
规模边界:什么时候该换
这是我认为最该说清楚的一段,因为「SQLite 能不能扛」这个问题没有统一答案。
| 数据量 | 检索方式 | 实际感受 |
|---|---|---|
| 1 万条以内 | 暴力扫描 | 毫秒级,无感 |
| 10 万条 | 暴力扫描 | 几十毫秒,可接受 |
| 100 万条 | 需要 ANN | 开始吃力,考虑分片或换库 |
| 千万条以上 | 分布式 | 别硬撑 |
判断标准不是「多少条」,是「查询延迟能不能接受」。单机场景下 10 万条以内我建议直接用,超过就实测一次再决定。
外接的另一个信号是并发。SQLite 的写锁是库级的,多进程同时写入会互相等。只读查询并发的场景没事,写入频繁的应用要考虑 WAL 模式(PRAGMA journal_mode=WAL)。
坑清单
坑一:维度写错。 建表时 float[512],模型输出 384 维,插入直接报错。换模型必须删表重建,老数据要重新编码。
坑二:enable_load_extension 被禁用。 少数 Python 构建(比如 macOS 系统自带的)编译时关掉了扩展加载,enable_load_extension(True) 会抛异常。换用官方 python.org 或 conda 的解释器。
坑三:忘了归一化。 不归一化又用余弦距离,结果会偏向长文本(向量模长大)。bge 和大多数中文模型都建议 normalize_embeddings=True。
坑四:FTS5 中文分词。 SQLite 内置分词器对中文按字切,效果一般。要好的中文检索得挂 jieba 之类的自定义分词器,或者接受「按字匹配」——对专有名词其实还行。
坑五:把大段文本一条条塞进 vec0。 切片长度建议 300 到 500 字。太长了单条向量表达不准,太短了检索出来的片段没有上下文。
边界
这套方案适合「单机、可离线、数据量中小、以读为主」的场景:个人知识库、内部文档搜索、离线设备的检索、桌面应用内嵌搜索。
不适合:多租户 SaaS、需要水平扩展的服务、千万级以上的向量。这些真该用专门的库。
另外一个容易被忽略的优势值得提一句:sqlite-vec 能编成 WASM,同一套 SQL 在浏览器里也能跑。做纯前端的本地搜索时,这个特性很好用。
FAQ
和 FAISS 比怎么样?
FAISS 是纯索引库,只做向量检索,没有 SQL、没有事务、没有持久化。sqlite-vec 是「数据库里的向量能力」,胜在集成度高,代价是极限性能不如专用索引。
需要单独装 SQLite 吗?
不需要。Python 标准库自带 sqlite3,sqlite-vec 装的是扩展。
能不能直接存 OpenAI 的嵌入?
可以。text-embedding-3-small 是 1536 维,建表写 float[1536]。只是每次查询都要调 API,本地场景不如自己跑小模型。
多少条数据之后必须换?
没有硬阈值。我的经验是查询延迟超过 200ms 就该考虑换,而 10 万条以内通常到不了这个数。
支持增量更新吗?
支持,直接 insert。删除要同时删三张表(或者用触发器),漏删会导致检索出空内容。
结语
这套东西的价值不在技术含量,在于把基础设施成本降到零。一个 .db 文件,不占端口,不写配置文件,备份就是复制。
如果你正在为几千份文档纠结要不要上向量数据库,先花两小时把这 200 行跑通。很多项目跑起来之后会发现,根本不需要换。
参考资料
- sqlite-vec 官方仓库 - vec0 虚拟表、距离度量与各语言绑定
- SQLite FTS5 文档 - 外部内容表与 rank 排序
- BAAI/bge-small-zh-v1.5 模型卡 - 维度与归一化建议
- 本站 RAG 混合检索与重排 - RRF 原理与 k 值选择
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。