
一句话总结:传统 SEO 争的是排名,GEO 争的是被引用。AI 搜索的工作方式是「检索 → 切片 → 摘取」,所以它偏好的内容和我们过去优化的方向不太一样:不是关键词密度,是可摘取的结论、明确的实体、能追溯的出处。这篇给六件能直接照做的事和一份反面清单。
先说清一件事:GEO(Generative Engine Optimization)这个词现在被讲得很玄,但落地的东西不玄——你只要想明白 AI 是怎么读到你的,剩下的动作就都顺了。
链路:AI 搜索不是「读你的整篇文章」
用户问一个问题,背后大致这么走:
关键在第三步和第四步:它读的是段落,不是文章。这意味着你那篇文章整体写得多好,只要没有任何一段能独立回答这个问题,就不会被引。
这个机制决定了后面所有动作的方向。
六件能直接做的事
一、把小标题写成问题。
不是「性能表现」,而是「这个模型跑一个任务要多少钱」。前者需要读者自己联想,后者和用户的提问在语义上直接对齐。
我写技术文时习惯让每个 H2 独立可读——不看上下文也知道这一段在讲什么。这个习惯在 GEO 上直接变成优势。
二、每个 H2 下面先给结论,再给论证。
AI 摘取片段时有长度限制,它更愿意拿开头就把话说清的那段。所以段落的理想结构是:一句结论 + 一到两句依据 + 一个具体数字或例子。
对比一下:
❌ 「在性能方面,该模型表现出了相当不错的特性,尤其在一些场景下能够满足用户需求。」
✅ 「Terminal-Bench 4.0 上 50.3%,比上一个版本高 28.8 个百分点,比同代的 Sol 低 5.6 个点。」
后者能被直接摘出来当答案,前者摘出去等于没说。
三、数据必须带来源和口径。
这条我在每篇文末都做(参考资料那块),原因是双向的:对人来说它建立可信度,对 AI 来说它是可交叉验证的锚点。
同一个数字如果有两个来源冲突,把两个口径都写出来。模型在生成时会倾向于引用「说明了口径」的来源,因为那看起来更可靠。
四、实体要统一且可识别。
同一个东西在全站用同一个名字。别一会儿「M3.1 Flash」一会儿「MiniMax 那个小模型」一会儿「M3.1F」。模型做实体对齐时,别名越多越容易漏。
配套要做的是 About 页和作者信息。E-E-A-T 那套东西讲了几年,在 AI 搜索里反而更重要了——它需要判断「这个页面背后有没有一个可信的实体」。
五、结构化数据别省。
Article、FAQPage、BreadcrumbList 这三种覆盖大部分内容站。它们不保证被引用,但能让机器更准确地理解「这是问答」「这是文章」「这属于哪个栏目」。
成本很低,一个模板改一次全站生效。
六、别把 AI 爬虫挡在门外。
这条最容易踩。很多站的 robots.txt 抄了一堆 AI 爬虫的 Disallow(前两年「防止内容被白嫖」的风气),结果自己的内容在 AI 搜索里彻底消失。
主流需要放行的 UA:
User-Agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /
要不要放行是个策略选择:放行意味着内容可能被用来生成答案(流量被截),不放行意味着在 AI 搜索里不存在。我的判断是内容站应该放行——被引用至少带品牌曝光和引用链接,完全不出现等于放弃这个入口。
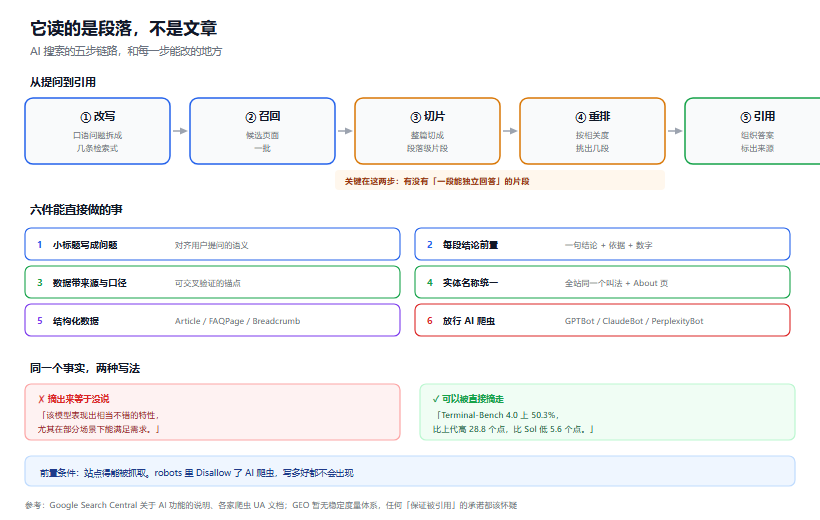
图 1:AI 搜索的五步链路,以及每一步对应的可优化点
怎么验证有没有被引用
没有官方后台,只能手工测。三个方法:
第一,直接问。 用你目标的长尾问题去问豆包、Kimi、元宝、Perplexity,看回答里有没有出现你的域名或文章标题。多问十几个问题,记录命中率。
第二,看 referrer。 AI 入口带来的流量,referrer 经常是空的或者只有域名。用分析工具筛「direct + 落地页是文章页」的组合,能捞出部分。
第三,搜品牌词加关键短语。 比如搜「你的站名 + 某个你独有的表述」,如果 AI 能答出来,说明它读过。
这三个方法都不精确,但趋势能看出来。别指望有精确归因。
反面清单
不要批量生成水文。 AI 搜索的召回环节会做质量过滤,同质化内容多了反而拖累整站。
不要堆关键词。 生成式模型对语义冗余很敏感,一段里反复出现同一个词会让它判断这段信息密度低。
不要隐藏文本、不要做 cloaking。 对传统搜索是违规,对 AI 爬虫同样有检测。
不要为了「被引用」编数据。 一旦被交叉验证发现矛盾,损失的信任比收益大得多。
坑清单
坑一:robots 抄了模板,把 AI 爬虫全挡了。 上面说过,先去看自己站的 robots.txt。
坑二:以为发了就会被引用。 从发布到被索引到被召回,中间有几天到几周的延迟,新站更慢。
坑三:只优化首页。 AI 搜索几乎总是落到具体文章页,首页再优化也没用。
坑四:文章很长但没有可摘段落。 三千字全是论述,没有一句能独立回答问题的结论段。这种情况最可惜——内容是有价值的,只是形态不对。
坑五:忽略图片和表格的替代信息。 图里的文字 AI 读不到(除非有 alt 或图注),表格倒通常能读。关键数据别只放在图里。
边界
GEO 现在还没有稳定的度量体系,任何声称「保证被 AI 引用」的服务都应该怀疑。能做的就是把内容写成容易被摘取的样子,剩下的交给检索和模型的判断。
还有一个现实约束:这套东西的前提是站点能被抓取。本站目前还在备案期,全站返回占位页,AI 爬虫来了也只会读到「网站正在备案中」。所以下面那份清单,我打算等备案通过再执行——现在做优化等于对着空气喊话。
FAQ
GEO 会取代 SEO 吗?
不会。AI 搜索的召回仍然依赖传统索引,传统 SEO 做不好,GEO 无从谈起。它是叠加项,不是替代项。
多久能看到效果?
内容层面改动(结构、结论前置、数据出处)在下次被抓取后可能生效;被稳定引用通常要一两个月,取决于你的更新频率和站点权重。
要不要给 AI 单独做一套内容?
不建议。同一套内容既服务人也服务 AI 是最经济的。单独做一套维护成本翻倍,而且容易变成低质内容。
结构化数据真的有用吗?
对传统搜索的富摘要确定有用;对 AI 搜索的作用是「降低理解成本」,间接有用。成本低,值得做。
小站有机会吗?
有。AI 搜索对「具体、可验证、聚焦单一问题」的内容更友好,这恰好是小站能拼过综合大站的地方。
结语
GEO 的本质可以用一句话概括:把内容写成「可以被摘下来当答案」的形状。
这件事和「写得好」不冲突,但它确实要求你把过去那种「娓娓道来」的写法改一改——先给结论,再讲为什么。对读者也更友好。
参考资料
- Google Search Central - AI 功能与网站内容的最佳实践
- OpenAI GPTBot 说明 - 抓取用途与 robots 控制方式
- 本站 备案期间的 SEO 清单 - 上线前的基建与切换顺序
- 本站 新站收录 12 项检查 - 抓取、索引、展现三段指标
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。