
一句话总结:MCP 解决的是「AI 想用你的工具,但不知道它存在」这个问题。这篇从 20 行的最小服务器写起,讲清 tool / resource / prompt 三种原语的分工、参数设计为什么比代码重要、怎么接进 Claude Code 和 WorkBuddy,以及 stdio 模式下最容易踩的那个坑。
先说痛点。你有个查日志的脚本、一个内部 API、一个只读数据库连接。每次让 AI 帮忙分析,都得手动把结果复制过去。MCP 就是干这个的:把你的能力包成标准接口,客户端一配置,模型就能自己决定什么时候调、传什么参数。
它本质是 JSON-RPC,传输层可以是 stdio(本地进程)或 HTTP。对个人用户,stdio 最简单——客户端启动一个子进程,通过标准输入输出通信。
最小可跑版本
装 SDK:
pip install mcp
# 或者用 uv(推荐,隔离干净)
uv add mcp
二十行写出第一个服务器:
from mcp.server.FastMCP import FastMCP

mcp = FastMCP("demo-tools")

@mcp.tool()
def count_lines(path: str) -> int:
    """统计文本文件的行数。

    Args:
        path: 文件绝对路径
    """
    with open(path, encoding="utf-8", errors="ignore") as f:
        return sum(1 for _ in f)

if __name__ == "__main__":
mcp.run() # 默认 stdio就这些。@mcp.tool() 装饰器把函数注册成工具,参数类型注解自动生成 JSON schema,docstring 变成工具描述。
跑起来是阻塞的,终端看着像卡住——正常,它在等客户端说话。
三种原语,别混用
MCP 给了三个概念,用途完全不同:
| 原语 | 语义 | 谁来触发 | 典型用途 |
|---|---|---|---|
| Tool | 有副作用的动作 | 模型决定调用 | 查数据库、发请求、写文件 |
| Resource | 只读数据 | 客户端按 URI 读取 | 配置文件、文档、日志片段 |
| Prompt | 可复用模板 | 用户主动选择 | 固定的分析流程、代码审查清单 |
新手最常见的错误是把所有东西都做成 tool。判断很简单:只读、且有固定地址的数据,做成 resource;需要参数组合、会改变状态的动作,才做成 tool。如果你只是想给本地模型接几个工具、不打算搭通用协议,llama.cpp 的 Function Calling那条路更轻。
Resource 的写法:
@mcp.resource("config://app")
def get_config() -> str:
    """当前应用的配置(只读)"""
return open("app.toml", encoding="utf-8").read()好处是这类数据不消耗工具调用的轮次,客户端可以直接把它塞进上下文。
参数设计比代码重要
这段是我认为整篇最值钱的部分。
模型决定要不要调你的工具,靠的是工具名 + 描述 + 参数 schema。代码写得再漂亮,描述写得含糊,它就是不会调。
三条实操建议:
一、工具名用动词开头,写清对象。 query_slow_logs 比 logs 好,get_user_orders 比 orders_query 好。
二、描述里写「什么时候用」和「什么时候别用」。 只写「查询日志」不够,要写「用于按时间范围和级别筛选服务端日志;不用于查询业务数据,那用 query_orders」。
三、参数用具体类型,别用裸 dict。 类型注解越具体,schema 越清晰,模型填错参数的概率越低。
from typing import Literal

@mcp.tool()
def query_slow_logs(
    service: str,
    minutes: int = 30,
    level: Literal["warn", "error", "fatal"] = "error",
    liMIT: int = 50,
) -> str:
    """查询指定服务最近的慢请求与错误日志。

    用于排查线上问题时获取原始日志。想看业务数据请用 query_orders。

    Args:
        service: 服务名,如 order-api、user-api
        minutes: 回溯分钟数,默认 30,上限 1440
        level: 最低日志级别
        limit: 最多返回条数,默认 50,上限 200
    """
Literal 会让 schema 变成枚举,模型基本不会填错。默认值和上限写在 docstring 里,模型会读到。
返回值建议统一成字符串或可 JSON 序列化的结构。别直接返回 ORM 对象,序列化失败会让整个调用报错,而模型只会看到「工具调用失败」这种无用信息。
接进客户端
MCP 服务器的配置就是一个命令加参数。各家客户端的配置文件位置不同,结构几乎一样。
WorkBuddy 是 ~/.workbuddy/mcp.json:
{
  "mcpServers": {
    "demo-tools": {
      "command": "C:/path/to/Python.exe",
      "args": ["D:/projects/demo_mcp/server.py"],
      "env": { "LOG_LEVEL": "info" }
    }
  }
}
Claude Code 可以用命令加,也可以写 .mcp.json:
claude mcp add demo-tools -- C:/path/to/python.exe D:/projects/demo_mcp/server.py两个细节:路径写绝对路径(客户端的工作目录不确定),Python 解释器写全路径(别指望客户端继承你的 PATH)。
Windows 上还有个隐藏问题:如果用的是微软商店版 Python,python.exe 是个占位符,被调用时会静默失败。用 where python 确认一下真实路径。
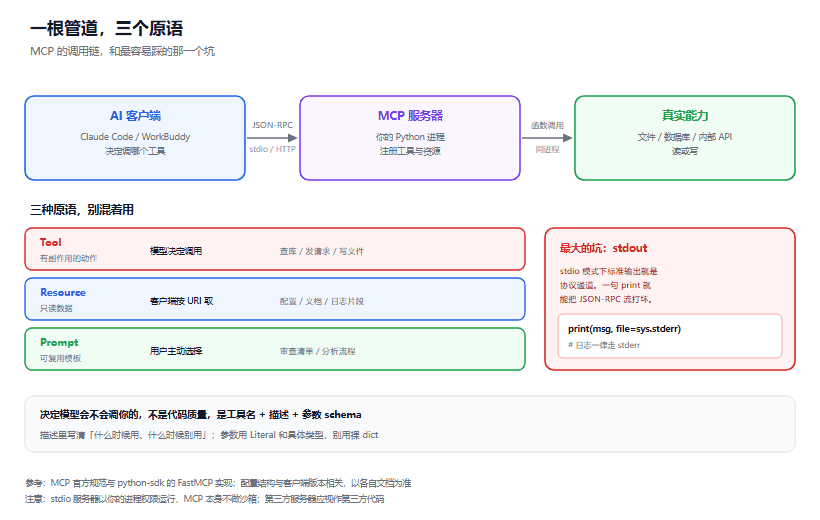
图 1:客户端与服务器之间是 JSON-RPC,服务器再调用你的实际工具
那个必踩的坑:stdout 被污染
stdio 模式下,标准输出就是协议通道。你在工具函数里随手 print("debug"),那一行会插进 JSON-RPC 流里,客户端解析失败,表现为「工具调用超时」或者「服务器无响应」。
排查起来极其费时间,因为服务器自己看着一切正常。
规矩很简单:
import sys

def log(msg):
    print(msg, file=sys.stderr)   # 日志一律走 stderr
或者干脆写文件。第三方库的日志也要管住——有些库默认往 stdout 打,得手动把它重定向到 stderr。
这一条我踩过,找了半小时才发现是某个 SDK 的 banner 打在了 stdout。
坑清单
坑一:stdout 混入非协议内容。 上面说过,排第一。任何 print、任何库的 banner、任何进度条都会破坏协议。
坑二:工具函数抛未捕获异常。 服务器可能整个挂掉,而不是返回一条错误信息。用 try/except 包住,把错误当返回值传回去,模型能读到原因,还能自己重试。
坑三:一次注册太多工具。 三十个工具塞给模型,它会挑错。分组做多个服务器,按场景启用,比一个全能服务器好用。
坑四:没有超时和上限。 一个查询跑十分钟,客户端早超时了。所有工具都要有内部超时和结果条数上限,参数里也要暴露给模型。
坑五:把写操作做成默认行为。 删除、覆盖、发消息这类动作,参数里加个 confirm: bool 或者干脆只提供 dry-run,让人看一眼再执行。
边界
stdio 服务器跑在你自己的机器上、你自己的权限下。工具能读什么,取决于你的进程权限,MCP 本身不做沙箱。所以别把「删库」这种能力包成工具交给模型,除非你有确认环节。
另外提醒一句:第三方 MCP 服务器要当第三方代码看。它能在你的机器上执行任意操作,装之前看一下源码或者至少确认来源。
FAQ
必须用 Python 吗?
不用。官方 SDK 有 Python、TypeScript,社区还有 Go、Rust、Java 实现。选你手边最熟的语言,协议层是一样的。
stdio 和 HTTP 怎么选?
本地工具用 stdio(简单、无需端口);要给多个客户端共享或者跨机器,才用 HTTP + 鉴权。
一个服务器能同时提供 tool 和 resource 吗?
能,同一个 mcp 实例上两种装饰器可以混用,客户端会分别列出。
怎么知道模型到底调没调我的工具?
看客户端的调用日志(大多会显示工具名和参数),服务器这边用 stderr 打点。两边对一下就知道是「没调」还是「调了失败」。
写好的服务器能发布吗?
可以,但公开的服务器要考虑鉴权、限流和输入校验。私用和个人项目直接本地跑就行。
结语
MCP 的价值不在协议本身,在于它把「给 AI 加一个能力」的成本降到了写一个函数加一个装饰器。
真要上手,从最小那个 20 行版本开始,先跑通再加功能。别一上来设计十个工具——你会发现模型只用其中三个,而且不是你最看好的那三个。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。